Az NVIDIA RTX Spark egy gépre hozza a kódolást és a tesztelést
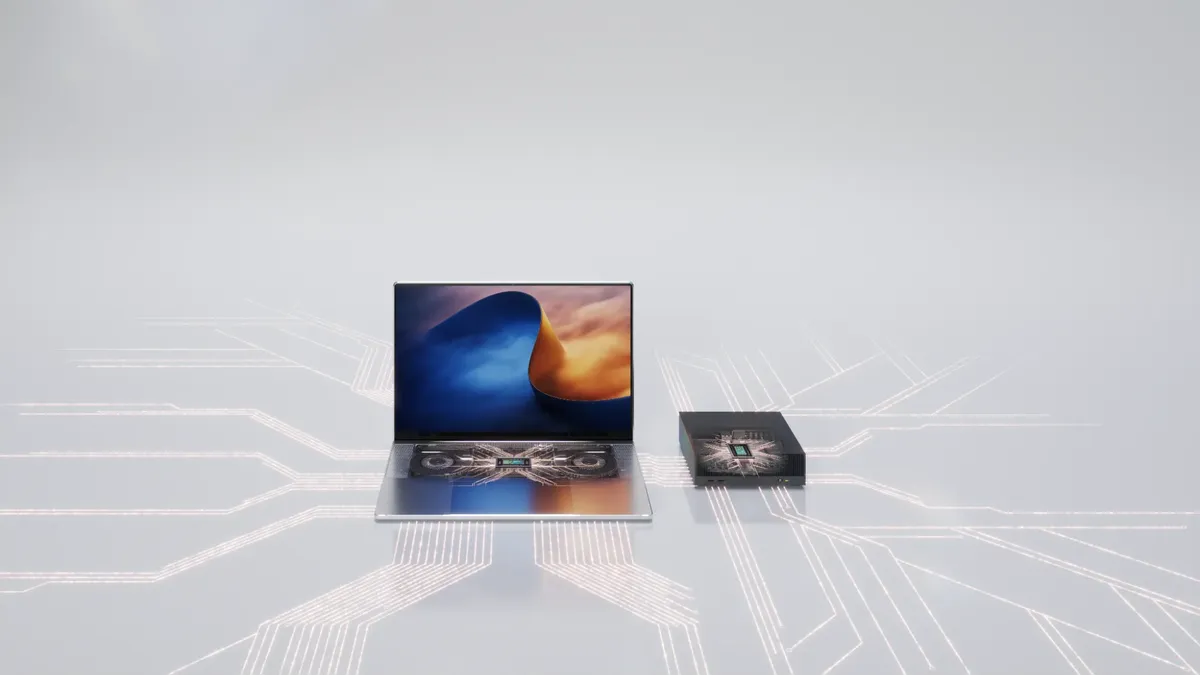
Az NVIDIA RTX Spark helyi kódolóügynökök futtatását, modellek finomhangolását, tesztelését és telepítését célozza egyetlen számítógépen. A platform az NVIDIA GB10 rendszerchipjére és legfeljebb 128 GB közös memóriára épül.
- Az RTX Spark helyi AI-fejlesztést és kódolóügynököket céloz egyetlen gépen.
- Legfeljebb 128 GB közös memóriát és 1 petaflop FP4-es AI-teljesítményt kínál.
- Az NVIDIA saját mérése szerint akár 4,6-szor gyorsabb kódolóügynököknél.
- A Nemotron 3.5 Bolt 74B-A9B 24GB helyi ügynökökhöz készült.
- A platform Windows on Arm fejlesztői eszközökkel és CUDA-támogatással bővül.
A fejlesztési folyamatot egyetlen gépre költöztetnék
Az NVIDIA szerint a szoftverfejlesztési munkafolyamatok egyre inkább GPU-központúvá válnak. A kódolóügynökök futtatásához, az alkalmazások teszteléséhez, a modellek finomhangolásához és a fordításhoz eddig gyakran laptopra, felhős modell-API-ra és felhőalapú virtuális gépre volt szükség.
Az RTX Spark laptopok és kompakt asztali számítógépek ezt a folyamatot egyetlen gépen kezelnék. A fejlesztők Windowsban vagy a Windows Subsystem for Linux környezetben dolgozhatnak. Az NVIDIA és a Microsoft közösen fejlesztett Windows Developer Config beállítása a vállalat leírása szerint telepíti a fontos fejlesztői keretrendszereket, módosítja az értesítéseket, fejleszti a terminálhasználatot, és lehetővé teszi a tálca oldalra helyezését.
Az NVIDIA GB10 rendszerchip, a Grace CPU és a Blackwell GPU legfeljebb 128 GB közös memóriát, valamint 1 petaflop FP4-es AI-számítási teljesítményt kínál. Ez helyi kódolási modellek futtatását is lehetővé teszi, köztük a Qwen 3.8 Flash Next modellét.
Az NVIDIA saját mérései szerint gyorsabb a fejlesztői munkaterheléseknél
Az NVIDIA összehasonlítása szerint az RTX Spark 4,6-szoros teljesítményt nyújt kódolóügynököknél, 2,7-szereset finomhangolásnál és 1,8-szorosat kódfordításnál az Intel Panther Lake 12Xe rendszeréhez képest. A vállalat a kódolóügynököknél Qwen3.8-27B modellel végzett AA-AgentPerf-local tesztet, a finomhangolásnál Llama-3.1-8B modellt és Unsloth LoRA-t használt, a fordítást pedig a Phoronix Test Suite Linux-kerneltesztjével mérte.
Az RTX Sparkhoz kapcsolódó Windows on Arm fejlesztői környezetben elérhető az első PyTorch-CUDA build, a Python 3.15 natív alapértelmezett támogatása, több mint 2000 Conda-csomag, valamint Arm-kompatibilis változat a 15 000 legnépszerűbb Python-csomag több mint 97 százalékához.
Az NVIDIA a CUDA-X könyvtárakat és az NVIDIA Skills tárházát is kínálja. Utóbbi olyan ismereteket ad az ügynököknek, amelyekkel CUDA-X könyvtárakat használhatnak GPU-gyorsított alkalmazások építéséhez.
Helyi ügynökök és új Nemotron modell
Az NVIDIA több kódolóügynökkel dolgozott együtt, köztük a GitHub Copilottal, a Pi-vel, a Hermesszel és az OpenClaw-val. A fejlesztések között helyi modellekhez készült telepítési receptek, operációs rendszerszintű elkülönítést biztosító megoldások, valamint helyi és felhős modellek között választó promptútválasztók szerepelnek.
A JetBrains natív támogatást indított a Junie Localhoz RTX Sparken. Az ügynök kódot olvas, fájlokat szerkeszt és teszteket futtat úgy, hogy a modell és a kód a gépen marad. Az RTX Spark közös memóriája lehetővé teszi, hogy a rendszer több kódot, eszközkimenetet és beszélgetési előzményt tartson a kontextusban.
Az új Nemotron 3.5 Bolt 74B-A9B 24GB egy 74 milliárd paraméteres, 9 milliárd aktív paraméteres kevert szakértői modell. Kétbites kvantálással 24 GB-ba fér el, és az NVIDIA szerint helyi ügynökökhöz készült. Induláskor a llama.cpp, a vLLM, az Ollama, az Unsloth és az LM Studio támogatja. A modell nyílt forráskódú, beleértve a tanítási adatokat, a súlyokat és a recepteket is.
A döntési modellek támogatása a llama.cpp-ben és az Unslothban is megjelenik RTX Sparken és GeForce RTX GPU-kon. Az NVIDIA szerint ezek az ügynökök számára akár 200-szor gyorsabb döntéshozatalt tehetnek lehetővé a hagyományos következtetési ciklusokhoz képest. Az RTX Spark emellett videó-felskálázást, képkockagenerálást és TrueHDR-t kínáló NVIDIA AI for Media SDK-kat is támogat.
NVIDIA Developer: Code, Test, and Deploy on One Machine with NVIDIA RTX Spark