Az NVIDIA Rubin GPU akár tízszer hatékonyabb lehet az ügynöki AI-ban
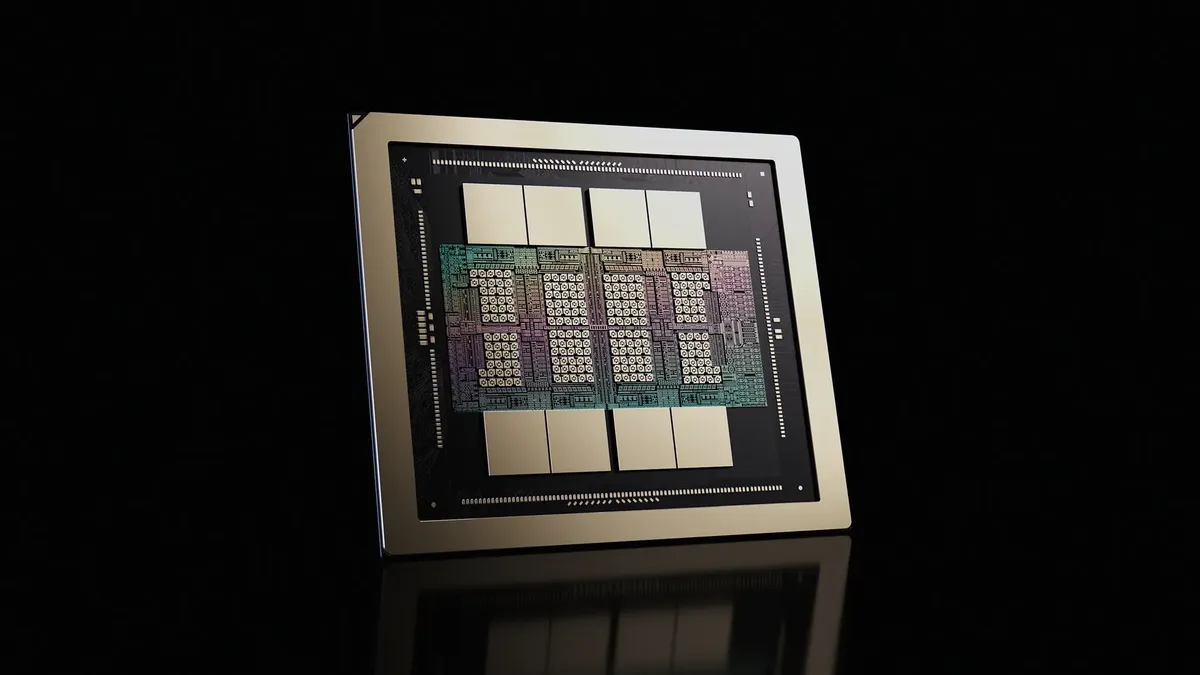
Az NVIDIA részletesen bemutatta a Rubin GPU architektúráját, amelyet az ügynöki mesterséges intelligencia folyamatos, több lépésből álló következtetési feladataira terveztek. A vállalat szerint a Rubin energiaegységenként akár tízszer nagyobb ügynöki AI-átvitelt biztosíthat, mint a Blackwell.
- A Rubin energiaegységenként akár tízszer nagyobb ügynöki AI-átvitelt kínálhat a Blackwellhez képest.
- A GPU 336 milliárd tranzisztort, 224 streaming multiprocesszort és 896 Tensor Core-t tartalmaz.
- A HBM4 memória kapacitása legfeljebb 288 GB, sávszélessége akár 22 TB/s.
- Az NVLink 6 skálázási sávszélessége 3600 GB/s.
- A Rubin fejlesztései az MoE-modellek adatmozgatását és a mátrixműveletek hatékonyságát is célozzák.
Az ügynöki AI igényeire tervezték
Az NVIDIA Developer július 21-én közzétett ismertetője szerint az ügynöki AI-rendszerek feladatai eltérnek az egyszerű kérdés-válasz működéstől. Ezek a rendszerek több lépésben következtetnek, terveket készítenek, eszközöket használnak, ellenőrzik a köztes eredményeket, majd összetett feladatokat hajtanak végre.
Az ilyen munkaterhelésekhez alacsony késleltetés szükséges minden egyes lépésnél, emellett nagy dekódolási átviteli sebesség, hatékony működés hosszú kontextusokkal, nagy KV cache kapacitás és több GPU szoros együttműködése kell. Az NVIDIA szerint ezért az adatközpontot egyetlen számítási egységként kell kezelni. Ezt a megközelítést a Vera Rubin platform valósítja meg.
336 milliárd tranzisztor és HBM4 memória
A Rubin GPU két, retikulum által korlátozott számítási lapkából épül fel, amelyeket az NVIDIA High-Bandwidth Interface, röviden NV-HBI kapcsol össze egyetlen csomagban. A GPU 336 milliárd tranzisztort, 224 streaming multiprocesszort és 896 Tensor Core-t tartalmaz.
A harmadik generációs Transformer Engine különböző numerikus formátumok között képes alkalmazkodni. Az NVIDIA közlése szerint ez akár 50 petaflop NVFP4 teljesítményt tesz lehetővé következtetésnél, miközben a pontosság megőrzésére törekszik.
A Rubin legfeljebb 288 GB HBM4 memóriát használ, akár 22 TB/s csúcsként megadott sávszélességgel. A vállalat szerint ez a többtrillió paraméteres modellek, a nagyobb kontextusablakok és a magas párhuzamosságú következtetés futtatását is segítheti.
Gyorsabb adatmozgás és GPU-k közötti kommunikáció
A Rubin GPU működésében a számítási kapacitás mellett az adatok mozgatása is központi szerepet kap. A továbbfejlesztett Tensor Memory Accelerator összetett memóriaszerkezetek között kezeli az adatmozgást, az NVLink 6 pedig 3600 GB/s skálázási sávszélességet biztosít az NVLink Switch felé, az összes GPU közötti kommunikációhoz.
Az NVIDIA NVLink-C2C kapcsolat 1800 GB/s sebességű koherens CPU és GPU közötti kommunikációt kínál, az x16 PCIe Gen 6 pedig legfeljebb 256 GB/s gazdagépes kapcsolatot biztosít. A Rubin emellett bizalmas számítástechnikai funkciókat is használ. A TEE-I/O célja, hogy az adatokat nyugalmi állapotban, továbbítás közben és használat közben is védje az AI-gyárként leírt végrehajtási környezetben.
Hatékonyabb MoE-modellek és mátrixműveletek
A Rubin egyik fejlesztési területe a mixture-of-experts, vagyis MoE-modellek futtatása. Ezek a modellek a tokeneket dinamikusan irányítják különböző szakértői hálózatokhoz, ezért az egyre több szakértőhöz tartozó súlyok gyors elérése és mozgatása fontos teljesítménytényező.
A Rubin Tensor Memory Accelerator rendszere inline leírófrissítést támogat. Így a kernel egy közös leírót használhat az azonos elrendezésű, de eltérő memóriacímeken található tenzorokhoz, miközben futás közben közvetlenül módosíthat egyes mezőket, például a memóriamutatót és a lépésközt. Az NVIDIA szerint ez csökkenti a metaadat-kezelés és az adatmozgatás többletterhét.
A GPU a Tensor Core-ok órajelenkénti teljesítményét is növeli a K dimenzióban feldolgozható adatmennyiség megduplázásával. Az NVIDIA példája szerint egy olyan GEMM-művelet, amely a Blackwellen négy K-iterációt igényel, Rubinen két iterációval teljesíthető. A Transformer Engine emellett három bites keresőtáblás formátumot is támogat a mátrix B számára, amely az NVIDIA szerint akár az MXFP8 pontosságát is megtarthatja.
NVIDIA Developer: Inside NVIDIA Rubin GPU Architecture: Powering the Era of Agentic AI