NVIDIA Topograph: topológia alapján ütemeznék az AI-terheléseket
Az NVIDIA Topograph azt a problémát célozza, hogy az AI-terhelések ütemezői naprakész képet kapjanak a GPU-k és a hálózati kapcsolatok viszonyairól. A nyílt forrású eszközkészlet Kubernetes, Slurm és Slinky környezetekben is felhasználható topológiai adatokat állít elő.
- A Topograph felhő API-kból vagy helyszíni fabric rendszerekből deríti fel a klasztertopológiát.
- Az eszköz Kubernetes node címkéket, Slurm konfigurációt vagy Slinky ConfigMapeket tud előállítani.
- A támogatott felhőintegrációk között szerepel a Google Cloud, a Lambda, a Nebius, az Nscale és az OCI.
- A Topograph kérésre és klaszterváltozások esetén újragenerálja a topológiai nézetet.
- Kubernetes alatt legalább 1.27-es verziót, Helm 3.10+ vagy 4.x verziót és támogatott providert említ a forrás.
Miért számít a GPU-k elhelyezése?
Az NVIDIA Developer blogon 2026. szeptember 22-én megjelent bejegyzés szerint az AI factory rendszerek teljesítményét erősen befolyásolja, hogy a munkaterhelések hová kerülnek a klaszteren belül. A rossz elhelyezés feldarabolhatja a topológiai tartományokat, a forgalmat megosztott kapcsolatokra kényszerítheti, csökkentheti az áteresztőképességet, növelheti a feladatok költségét, és olyan helyzetet teremthet, amelyben a GPU-k lefoglalt energiát fogyasztanak, miközben adatra várnak.
A forrás szerint a tréning és az inferencia során a GPU-k folyamatosan adatot cserélnek, ezért az elosztott munkaterheléseknek előnyös, ha a kommunikáció helyben, közeli erőforrások között történik. Az NVIDIA NVLink és az NVLink Switch nagy sávszélességű, all-to-all scale-up kapcsolatot ad rack-szintű GPU-tartományokban, míg az NVIDIA Spectrum-X Ethernet kiszámítható, alacsony késleltetésű scale-out hálózatot biztosít rendszerek és rackek között.
Az NVIDIA példája szerint a modern NVIDIA Quantum InfiniBand portok akár 800 Gb/s sebességet is elérhetnek. Az ötödik generációs NVLink, például az NVIDIA Blackwell rendszerekben, mint a GB200 vagy a GB300, GPU-nként 1,8 TB/s kétirányú sávszélességet kínál, a hatodik generációs, Vera Rubin rendszerben pedig 3,6 TB/s értéket említ a cég. A Topograph szerepe ebben az, hogy az ütemezők ne kézzel karbantartott pillanatképből dolgozzanak, hanem a klaszter változásait követő topológiai nézetből.
Mit csinál a Topograph?
A Topograph a klasztertopológiát felhő API-kból vagy helyszíni, on-premises fabric rendszerekből deríti fel, majd közös modellbe rendezi. Ezt azután olyan formában adja tovább, amelyet az adott munkaterhelés-kezelő használni tud: Kubernetes node címkékként, Slurm topológiai konfigurációként vagy Slinky ConfigMapként.
Az NVIDIA leírása szerint az eszköz két fő fogalomra épül: providerekre és engine-ekre. A provider a topológiát fedezi fel és kanonikus modellbe normalizálja. Az engine ezt a modellt alakítja át Slurm konfigurációvá, Kubernetes címkékké, Slinky ConfigMapekké, Node Feature Discovery, röviden NFD erőforrásokká, vagy példányorientált topológiai JSON-ná.
A Topograph a DSX OS klaszter-orkesztrációs rétegen belül a Dynamic Resource Allocation, vagyis DRA, valamint a KAI Scheduler mellett dolgozik, és topológiaérzékeny gang schedulinget tesz lehetővé AI factory infrastruktúrán. A blog szerint a Kubernetes és a Slurm egyaránt támogat topológiaérzékeny allokációt, de az ütemező csak arra a topológiára tud reagálni, amelyet lát. A Topograph kérésre és figyelt klaszterváltozások esetén újragenerálja ezt a nézetet.
Támogatott környezetek és frissülő topológiai nézet
A forrás szerint működő Topograph-integrációval rendelkező felhőszolgáltatók közé tartozik a Google Cloud, a Lambda, a Nebius, az Nscale és az Oracle Cloud Infrastructure, röviden OCI. A táblázatban a Crusoe is szerepel támogatott providerként. A közlemény hozzáteszi, hogy további felhő- és colocation szolgáltatók támogatása fejlesztés alatt áll.
Helyszíni környezetben az InfiniBand provider használható az ibnetdiscover eszközzel, míg Spectrum-X vagy Multi-Node NVLink, röviden MNNVL tartományokhoz a NetQ szerepel. A provider interfész nyitott, így az üzemeltetők saját környezetükhöz is készíthetnek providert, és azt upstream módon is beküldhetik.
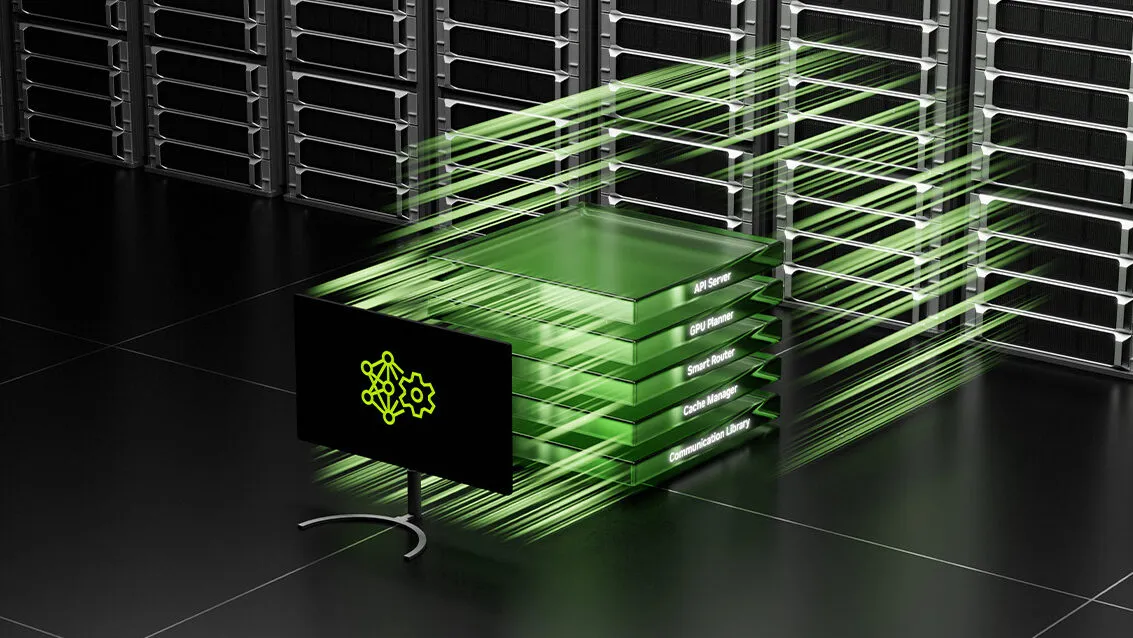
A blog öt komponenst sorol fel, amelyek a nézet frissen tartásában vesznek részt. Az API Server validálja a kéréseket, összegyűjti a duplikátumokat és elindítja a felderítést. A Node Observer Kubernetes node vagy Pod változásokat, illetve API-készenlétet figyel, majd újragenerálást kér. A Node Data Broker csomópontonkénti attribútumokat gyűjt és node annotációkban tárol. A Provider a felhő- vagy fabric-adatokat alakítja kanonikus reprezentációvá. Az Engine olyan formátumot ír ki, amelyet az ütemező ért.
Az API-szerver öt végpontot kínál: POST /v1/generate, GET /v1/topology?uid=<request-id>, POST /v1/lookup, GET /healthz és GET /metrics. A bejegyzés szerint az aggregációs késleltetés szükséges, tipikusan 15 másodperc. Az ismételt azonos kérések egy késleltetett időzítőt állítanak vissza, és egyszer kerülnek feldolgozásra, ami csökkenti a felesleges munkát klaszteresemények hullámainál.
Kubernetes, Slurm és tesztelés gyártási hardver nélkül
Kubernetes alatt a blog szerint az alapértelmezett ütemező nem fedezi fel a fizikai összeköttetések hierarchiáját. A Topograph ezt úgy kezeli, hogy a provider által jelentett topológiát node címkékként publikálja, amelyeket natív affinity szabályok és topológiaérzékeny ütemezők is fogyaszthatnak.
A Kubernetes használathoz a forrás Kubernetes 1.27 vagy újabb verziót, Helm 3.10+ vagy 4.x verziót, kubectl jogosultságokat és támogatott providert említ előfeltételként. A KAI Scheduler vagy a Kueue TAS opcionális lehet a topológiaérzékeny gang schedulinghez. A Topograph Helm chartként telepíthető, a blog példája a topograph Helm repót és az engine.name=k8s, illetve provider.name=<provider> beállításokat használja.
A táblázat szerint a támogatási mátrix a 2026. szeptember 16-i upstream main állapotot tükrözi. A Kubernetes engine node címkéket publikál, az NFD engine pedig az alpha NodeFeatureGroupAPI feature gate-et igényli. A Slurm engine Kubernetesben is futtatható, de írható kötetet igényel a beállított topology.conf kimeneti útvonalhoz. A Crusoe provider a Crusoe Managed Kubernetes node-okról olvassa a fabric és accelerator-domain címkéket, ezért ennél a providernél a Topograph Kubernetesben fut.
Gyártási hardver nélküli teszteléshez a Topograph szimulációs modelleket is támogat. Ezek node és switch hierarchiákat írnak le, a kwok-nodes segédprogram és a Kind/KWOK eszközök pedig virtuális Kubernetes node-okká alakítják őket.
Mit jelent ez az üzemeltetőknek és a felhasználóknak?
A Topograph gyakorlati jelentősége az NVIDIA leírása alapján az, hogy az üzemeltetők egységes topológiai modellt használhatnak többféle környezetben, felhőben és helyszíni klaszterekben is. Ugyanaz a felderített információ több ütemezési rendszer számára is publikálható, Kubernetes címkéktől Slurm konfigurációig.
A felhasználói oldalról a forrásból az következik, hogy a topológiaérzékeny elhelyezés a szorosan összekapcsolt AI-terhelések kommunikációs útvonalait rövidebb, kedvezőbb lokalitási tartományok felé terelheti. Ez segíthet elkerülni azokat a szűk keresztmetszeteket, amelyek akkor jelennek meg, ha egy munkaterhelés távoli topológiai tartományok között oszlik szét.
Az NVIDIA következő lépésként a dsx-ai-factory/topograph GitHub repóból történő telepítést javasolja azoknak, akik topológiaérzékeny ütemezést szeretnének kipróbálni, valamint a DSX OS ökoszisztéma megismerését ajánlja klaszter-orkesztrációhoz.
NVIDIA Developer: Topology-Aware Workload Scheduling with NVIDIA Topograph