Az NVIDIA szerint több AI-token férhet el ugyanabban az energialimitben
Az NVIDIA az AI-infrastruktúra energiahatékonyságát javító új együttműködéseket és mérési eredményeket mutatott be az AI Infra Summit rendezvényen. A vállalat a csúcsteljesítmény helyett egyre inkább az egy megawattból előállítható tokenek számát tekinti fontos mutatónak.
- Az NVIDIA a tokenek megawattankénti számát állítja az AI-infrastruktúra egyik központi mérőszámává.
- A Vera Rubin NVL72 az MLPerf Inference v6.1 előzetesében akár 3,7-szer nagyobb átviteli teljesítményt ért el a GB300 NVL72-nél.
- A Lambda 24 százalékkal növelte a klaszter tokenátviteli teljesítményét, a teljesítmény wattarányosan pedig 23 százalékkal javult.
- A DSX Flex alacsony prioritású AI-feladatokat szabályozhat a villamosenergia-hálózat jelzései alapján.
- Az NVIDIA szerint a DSX MaxLPS megfelelő környezetben akár 40 százalékkal több GPU-t engedhet ugyanabban a megawattkeretben.
A Vera Rubin és a DSX az AI-gyárak energiafelhasználását célozza
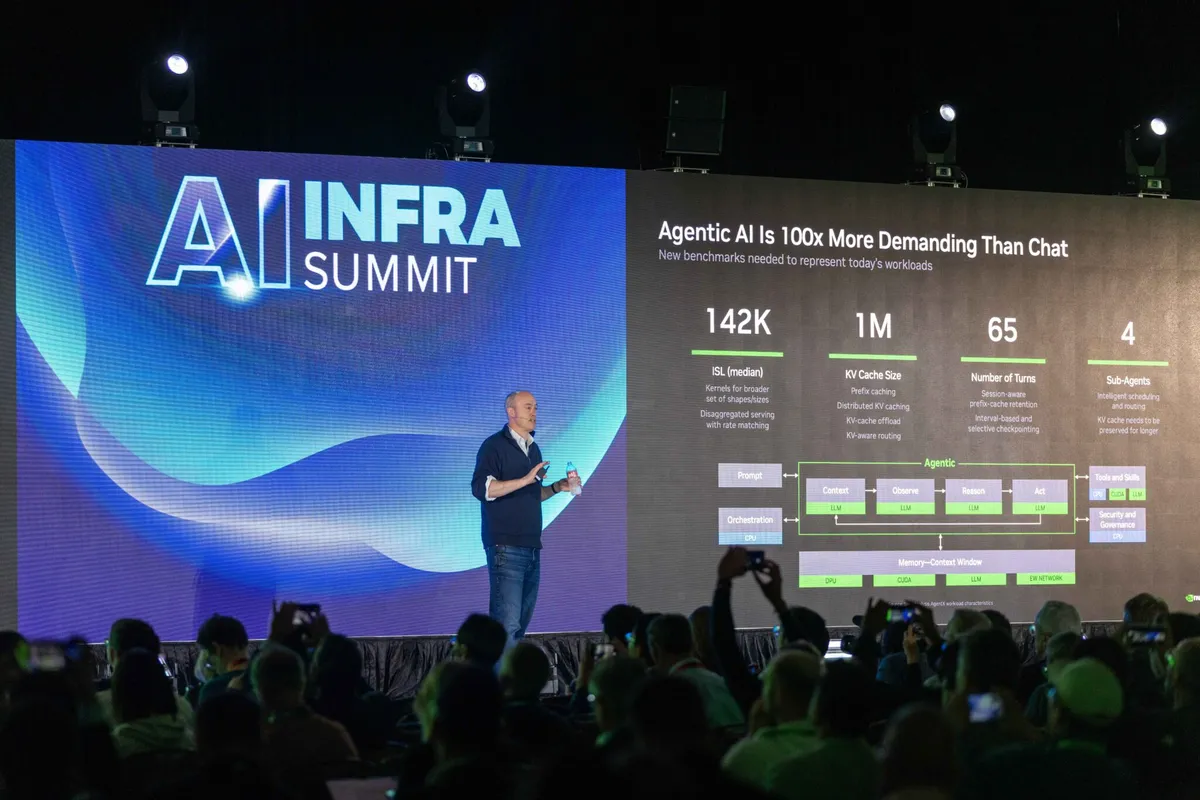
Ian Buck, az NVIDIA hiperskálázott és nagy teljesítményű számítástechnikai üzletágának alelnöke szeptember 15-én beszélt az AI-gyárak hatékonyságáról a vállalat AI Infra Summit rendezvényén. Az eseményen idén több mint 8000 résztvevő volt jelen, szemben a tavalyi 3500-zal.
Az NVIDIA szerint az ügynökalapú mesterséges intelligencia olyan munkaterheléseket hoz, amelyek egyszerre igényelnek nagyobb teljesítményt, hatékonyságot és skálázhatóságot. A vállalat erre teljes veremű platformmal válaszol, amelyben a Vera Rubin rendszerek, a Dynamo következtetési szoftver, a NeMo könyvtárak és az NVIDIA hálózati megoldásai kapnak helyet.
A cég új mérőszámként a validált, ügynökalapú tokenek számát emeli ki megawattanként. Az NVIDIA szerint a DSX MaxLPS gyárszintű energiagazdálkodással akár 1,4-szer több tokent képes előállítani megawattóránként, miközben az NVLink nagy méretű gyorsított számítási rendszereket kapcsol össze.
Új eredmények a teljesítmény és a rugalmas terhelés terén
Az MLPerf Inference v6.1 előzetes eredményeiben a Vera Rubin NVL72 az NVIDIA állítása szerint akár 3,7-szer nagyobb átviteli teljesítményt ért el, mint a GB300 NVL72. A GB300 NVL72 egy 288 GPU-s, négy rackből álló konfigurációban 99 százalékos skálázási hatékonyságot mutatott, miközben az átviteli teljesítmény közel lineárisan nőtt az egyrackes alaphoz képest.
Az NVIDIA beszámolója szerint a szoftveres optimalizációk önmagukban akár 1,6-szoros teljesítménynövekedést hoztak az MLPerf Inference v6.0 eredményeihez képest. A vállalat hangsúlyozza, hogy az AI-infrastruktúra gazdaságosságát a rendszer teljesítménye, a skálázás hatékonysága és a szoftveres fejlesztések sebessége együtt határozza meg.
Az Emerald AI és az NVIDIA a Silicon Valley Powerrel közösen rugalmas terhelési programot demonstrált. A DSX Flex képes valós idejű hálózati jelzések alapján csökkenteni az alacsony prioritású AI-feladatok energiafelhasználását, miközben a kritikus munkák futnak tovább. A rendszer ezután automatikusan visszaállíthatja a korábbi működést.
A Lambda ugyanabból az energiakeretből több számítási kapacitást hozott ki
A Lambda az NVIDIA szerint a DSX MaxLPS első, Blackwell szervereken végzett validációját mutatta be. A megoldás folyamatosan figyeli a GPU-k és rackek energiafogyasztását, majd oda csoportosítja át a rendelkezésre álló teljesítményt, ahol arra éppen nagyobb szükség van.
A szolgáltató 19 csomópontot futtatott ugyanabban az energiakeretben, amelyet jellemzően 16 teljes teljesítményű csomóponthoz használ. A klaszter tokenátviteli teljesítménye 24 százalékkal, körülbelül másodpercenként 4 millióról 5 millió tokenre nőtt, a teljesítmény wattarányosan pedig 23 százalékkal javult.
Az NVIDIA szerint a megfelelő környezetben a DSX MaxLPS a következő generációs Vera Rubin NVL72 AI-gyárakban akár 40 százalékkal több GPU elhelyezését teheti lehetővé ugyanabban a megawattkeretben. Ez az üzemeltetőknek nagyobb AI-kapacitást és tokenátvitelt jelenthet új áramvezetékek kiépítése nélkül.