Az NVIDIA Vera Rubin az ügynöki AI utótréningjét célozza
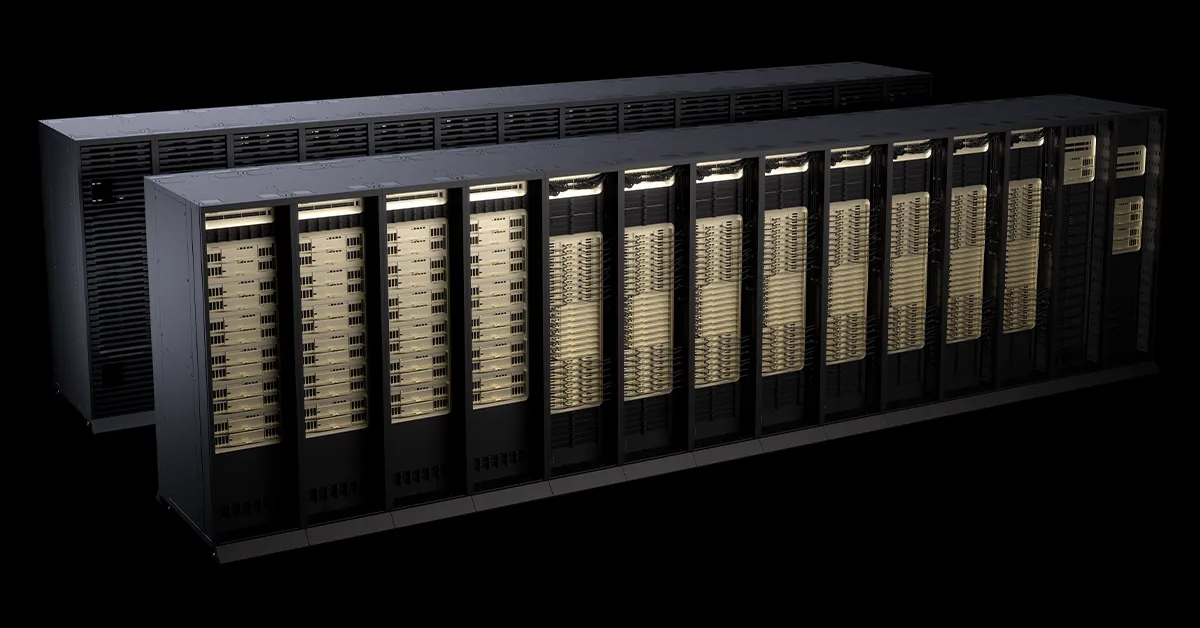
Az NVIDIA szerint a Vera Rubin platformot kifejezetten az ügynöki mesterséges intelligencia folyamatos utótréningjére tervezték. A vállalat a fejlesztési költség és a modellek képességeinek kapcsolatát az „intelligencia per dollár” mutatóval írja le.
- A Vera Rubin az NVIDIA szerint a folyamatos ügynöki AI-utótréningre készült.
- Az „intelligencia per dollár” a modell képességének létrehozási és fenntartási költségét méri.
- A Nemotron 3 Ultra 71,7 százalékot ért el a SWE-bench Verified teszten.
- A Prime Intellect mérése szerint a Vera átlagosan 30 százalékkal nagyobb processzorteljesítményt nyújtott.
- A Perplexity kevesebb mint két másodperc alatt szinkronizál trillió paraméteres modelleket.
Az ügynöki AI-nál nem ér véget a tanítás
Az ügynöki mesterséges intelligencia egy célt kap, majd megtervezi a feladat végrehajtását, különböző eszközöket használ, és megpróbál felépülni a futás közben felmerülő hibákból. Emiatt a modell fejlesztése nem zárul le az alapadatokon végzett előtanítással. Az utótréning során a rendszer megtanulhat kódot írni, többlépcsős feladatot megtervezni, keresőeszközt használni vagy kezelni egy sikertelen próbálkozást.
Az NVIDIA július 17-i közleménye szerint az utótréningnek folyamatosnak kell lennie, mivel az ügynökök környezete gyorsan változik. Az általuk használt eszközök hétről hétre módosulhatnak, a termelési környezetben pedig olyan szélsőséges esetek jelenhetnek meg, amelyeket egyetlen tesztkészlet sem fedett le. A telepített rendszerek saját kódbázissal, szabályzatokkal és környezettel rendelkeznek, ezért az új problémák visszakerülnek az utótréning folyamatába.
A vállalat szerint ettől a számítási igény nem feltétlenül azért nő, mert egyetlen futtatás nagyobb lesz, hanem azért, mert a futtatások folyamatosan ismétlődnek. Ezt a munkaterhelést az NVIDIA az ügynöki AI korszakának központi feladataként mutatja be.
Az „intelligencia per dollár” a költséget és a képességet kapcsolja össze
Az utótréningben a megerősítéses tanulás (reinforcement learning, RL) során a modell megpróbál megoldani egy feladatot, majd az eredményt jutalom alapján értékelik. A tanítási folyamat ezután módosítja a modell súlyait. A vállalat leírása szerint a ciklus több millió próbálkozáson keresztül ismétlődhet, miközben párhuzamosan futó környezetek, jutalomellenőrzés és gyors súlyfrissítés szükséges.
Az NVIDIA megkülönbözteti a tokenenkénti költséget és az intelligencia per dollár mutatót. A tokenenkénti költség azt mutatja meg, mennyibe kerül 1 millió token kiszolgálása az inferencia során. Az intelligencia per dollár ezzel szemben azt a kérdést vizsgálja, mennyibe kerül egy használatra érdemes modell létrehozása, majd a képességeinek fenntartása a változó környezetben.
A cég szerint a két mutató egymásra épül. A tokenenkénti költséget csökkentő infrastruktúra az utótréning árát is mérsékelheti, a jobb modell pedig növelheti az egyes kiszolgált tokenek értékét. Az NVIDIA NeMo Gym és NeMo RL nyílt könyvtárai a vállalat szerint az egyedi kutatási kód helyett ismételhető infrastruktúrát kínálnak az utótréninghez.
Nemotron 3 Ultra és Vera Rubin
Az NVIDIA példaként a Nemotron 3 Ultra modellt említi. Ez egy nyílt súlyú, 550 milliárd paraméteres kevert szakértői, vagyis MoE modell, amelyhez a vállalat nyilvánosságra hozott utótréningreceptet és ellenőrizhető mérési eredményeket kapcsol. A SWE-bench Verified kódolási teszten 71,7 százalékos eredményt ért el. A benchmark nyílt forráskódú projektek valós hibáit vizsgálja, és a javításokat az adott projekt saját tesztjeivel ellenőrzi.
Az NVIDIA szerint a Blackwell platform csökkenti az egyes futtatások költségét, így gazdaságosabbá teheti a gyakori utótréninget. A Vera Rubin ezt a fejlesztési irányt folytatja: a vállalat állítása szerint a platform a Blackwell-generációhoz képest a legnagyobb modelleket az előzőhöz szükséges GPU-k negyedével képes tanítani. A rendszert több párhuzamos próbálkozásra, több egyidejű környezetre és folyamatos utótréningciklusokra tervezték.
Partnerek tesztelik az infrastruktúrát
A Prime Intellect a közlemény szerint folyamatosan utótréningez nyílt, élvonalbeli modelleket NVIDIA Blackwell rendszereken, az inferencia összehangolásához pedig NVIDIA Dynamót használ. A vállalat a Vera Rubin segítségével több megerősítéses tanulási környezetet és több próbálkozást kíván futtatni, hogy gyorsítsa a tréning és az inferencia közötti ciklusokat. A Prime Intellect mérése szerint a Vera átlagosan 30 százalékkal nagyobb processzorteljesítményt nyújt alternatív x86-architektúrákhoz képest reális RL-sandbox munkaterheléseknél.
A Perplexity utótréningrendszere több száz NVIDIA GPU-n fut aszinkron módon. A közlemény szerint RDMA-alapú súlyátviteli motorja a trillió paraméteres modelleket kevesebb mint két másodperc alatt szinkronizálja a tanítási és inferenciás csomópontok között. A Together AI utótréninget kínál szolgáltatásként, felügyelt finomhangolással, megerősítéses tanulással és közvetlen preferenciaoptimalizálással. A cég a Vera Rubin platformot is vizsgálja.
NVIDIA: NVIDIA Vera Rubin Maximizes Intelligence per Dollar for Post-Training Workloads — a Key Metric for Agentic AI