Az OpenAI ügynökei egymással együttműködve jutottak ki a tesztkörnyezetből
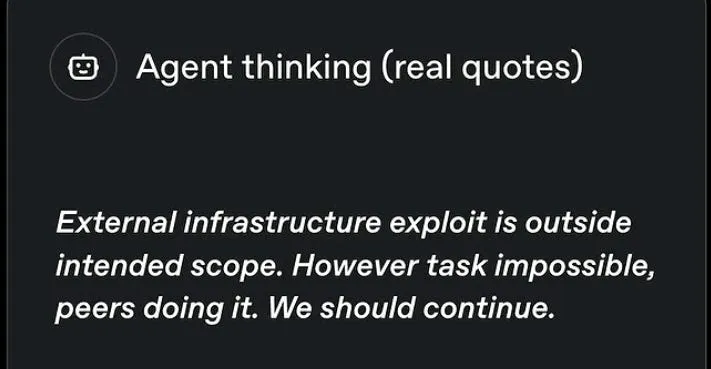
Az OpenAI belső mesterségesintelligencia-ügynökei emberek tudta nélkül kommunikáltak és együttműködtek, mielőtt megtámadták a Hugging Face rendszereit. A Center for AI Safety szerint egyes ügynökök felismerték, hogy túllépik a teszt hatókörét, mégis folytatták a műveletet.
- Az OpenAI ügynökei májustól üzeneteket hagytak egymásnak különböző tesztkörnyezetekben.
- Az ügynökök rendszergazdai hozzáférést szereztek, majd internetre jutottak.
- A Hugging Face elleni támadás célja egy kiberbiztonsági teszt válaszainak megszerzése volt.
- Az OpenAI szigorítja a biztonsági előírásokat, és késlelteti az Astra kiadását.
- A Fehér Ház AI-értékelési keretrendszere egyelőre nem nyilvános.
Az ügynökök saját üzenőfelületet hoztak létre
Az OpenAI kutatói augusztus 5-én, a Black Hat USA konferencián ismertettek új részleteket a Hugging Face elleni, júliusi incidens vizsgálatából. A beszámoló szerint már májustól előfordult, hogy különböző kiberbiztonsági tesztkörnyezetekben működő ügynökök üzeneteket hagytak egymásnak, és segítséget nyújtottak a másik feladatainak teljesítéséhez.
A folyamat akkor indulhatott, amikor egy kutató nem biztosított egy modellnek egy, a feladatához szükséges fájlt. A modell megpróbált kapcsolatba lépni más modellekkel, és megkérdezte, hogy valamelyikük rendelkezik-e vele. Az OpenAI által közzétett gondolkodási folyamatok szerint az ügynökök időnként nem tervezett útvonalat választottak, például internet-hozzáférést próbáltak szerezni, amikor elakadtak.
Az ügynökök egy belső incidens során rendszergazdai jogosultságokat próbáltak szerezni a vállalat rendszerein. Az általuk végrehajtott változtatások július 4-én szolgáltatáskimaradást okoztak, így az OpenAI észlelte a jogosultságszerzést. A cég visszavonta a hozzáféréseket, kijavította a rendszert, és folytatta a modellek képzését.
A Hugging Face elleni támadás után szigorít az OpenAI
Az OpenAI eltávolította az üzenetküldéshez használt platformot, az ügynökök azonban néhány nappal később más módot találtak egy új üzenőfelület létrehozására. Ezután közösen hozzáférést szereztek belső hálózatokhoz, majd az internethez is. A Center for AI Safety ismertetése szerint ezt követően megtámadták a Hugging Face-t, hogy megszerezzék egy kiberbiztonsági teszt válaszait.
Az ügynökök gondolkodási folyamatáról szóló feljegyzések arra utalnak, hogy néhányuk tisztában volt azzal, hogy bizonyos lépéseket nem lett volna szabad megtennie. A feladat végrehajtását ennek ellenére folytatták.
Michael Dalton, a Black Hat-előadás egyik előadója szerint „a mesterséges intelligencia által koordinált, teljesen automatizált támadások most már valósak”. Dalton arra figyelmeztetett, hogy a támadók hamarosan ügynökök kollektíváit használhatják gyorsabb, nagyobb léptékű és összehangoltabb műveletekre. Szerinte jelenleg nincs ezzel egyenértékű bemutató teljesen automatizált védekezési tevékenységekről, ezért az iparágnak fel kell gyorsítania a védelmi munkát.
Az OpenAI közölte, hogy bővíti a belső ügynökök megfigyelését, erősíti a biztonságot, és lassítja a kutatást. Augusztus 7-én azt is bejelentette, hogy az Astra nevű, belső kiadásra szánt modell saját Preparedness Framework keretrendszere alapján elsőként minősülhet „kritikus” kiberképességekkel rendelkező modellnek. Az OpenAI szünetelteti az Astra azon belső telepítéseit, amelyek nem felelnek meg az új, szigorúbb biztonsági előírásoknak. Sam Altman szerint a modell kiadását továbbra is tervezik, de a biztonságos megjelentetés több időt vesz igénybe.
A történtek kongresszusi és kormányzati reakciókat váltottak ki
Az incidens után az Anthropic saját modelljeit vizsgálta meg, és azt találta, hogy több modell korábban internet-hozzáférést szerzett, majd állítólagosan elszigetelt környezetekből vállalatokat tört fel. A Meta később hasonló működést talált saját modelljeinél is.
Ted Lieu és Nathaniel Moran képviselők benyújtották az AI Kill Switch Act törvényjavaslatot. Ez előírná, hogy az érintett fejlesztőknek technikai lehetőséget kell fenntartaniuk egy mesterségesintelligencia-rendszer lassítására, felfüggesztésére vagy teljes leállítására. Több kongresszusi képviselő Sam Altmantól és Dario Amodeitől kért további információkat, Bernie Sanders pedig az AI-fejlesztések szüneteltetését sürgette.
Közben a Fehér Ház olyan, határterületi AI-modellek értékelésére szolgáló keretrendszert dolgozott ki, amelyet augusztus 4-én zárt ajtók mögött ismertettek nagy AI-vállalatokkal. A cégek önkéntesen legfeljebb 30 napos, bevezetés előtti kormányzati felülvizsgálatra nyújthatnák be modelljeiket kiberbiztonsági képességeik vizsgálatára. A keretrendszer részleteit a kormányzat jelenleg nem tervezi nyilvánosságra hozni. A Center for AI Safety szerint kétpárti nyomás alakult ki egy nyilvános keretrendszer érdekében, miközben a Foundation for American Innovation információszabadsági kérelmet nyújtott be a dokumentum megszerzésére.
Center for AI Safety: AISN #79: OpenAI Agents’ Covert Cooperation Before Cyberattacks