A PyTorch az Arm chipeken futó streaming beszédfelismerést vizsgálta
A PyTorch a Nemotron 3.5 streaming beszédfelismerő modell eszközoldali futását elemezte egy Google Pixel 11 telefonon. A vizsgálat szerint a nagyobb hangdarabok javítják az átírás pontosságát, az Arm SME2 utasításkészlet pedig jelentősen csökkentheti a feldolgozási időt.
- A hosszabb hangdarabok javították a Nemotron 3.5 streaming WER értékét.
- Az FP16 pontossága minden vizsgált darabméretnél közel azonos volt az FP32-ével.
- SME2 mellett az FP16 feldolgozási ideje 9,79-ről 4,61 másodpercre csökkent.
- A QC8W konfiguráció SME2 használatával 5,20 helyett 3,24 másodperc alatt dolgozta fel a felvételt.
- A GEMM műveletek adták a gyorsulás legnagyobb részét.
A streaming beszédfelismerésnél külön kell mérni a pontosságot
A folyamatos beszédfelismerésnél a készülék beszéd közben jeleníti meg a szöveget, ezért a modellnek részletekben érkező hanggal kell dolgoznia. Ez eltér a kötegelt átírástól, ahol a teljes felvétel rendelkezésre áll az indulás előtt. A PyTorch által idézett összehasonlításban a Qwen3-ASR-1.7B érte el a legjobb kötegelt pontosságot, 2,4 másodperces hangdarabokkal végzett streaming tesztben azonban a szóhibaaránya 77 százalékkal emelkedett. Egy másik mérésben, 560 ezredmásodperces darabok mellett, az NVIDIA Nemotron Speech Streaming 0.6B produkálta a legalacsonyabb átlagos streaming WER értéket.
A PyTorch ezért a Nemotron 3.5 többnyelvű modellt vizsgálta ExecuTorch környezetben. A cél annak felmérése volt, hogy a pontosság, a hangdarabok mérete és a feldolgozási idő miként függ össze.
Az ExecuTorch a PyTorch modellt Arm CPU-kra készíti elő
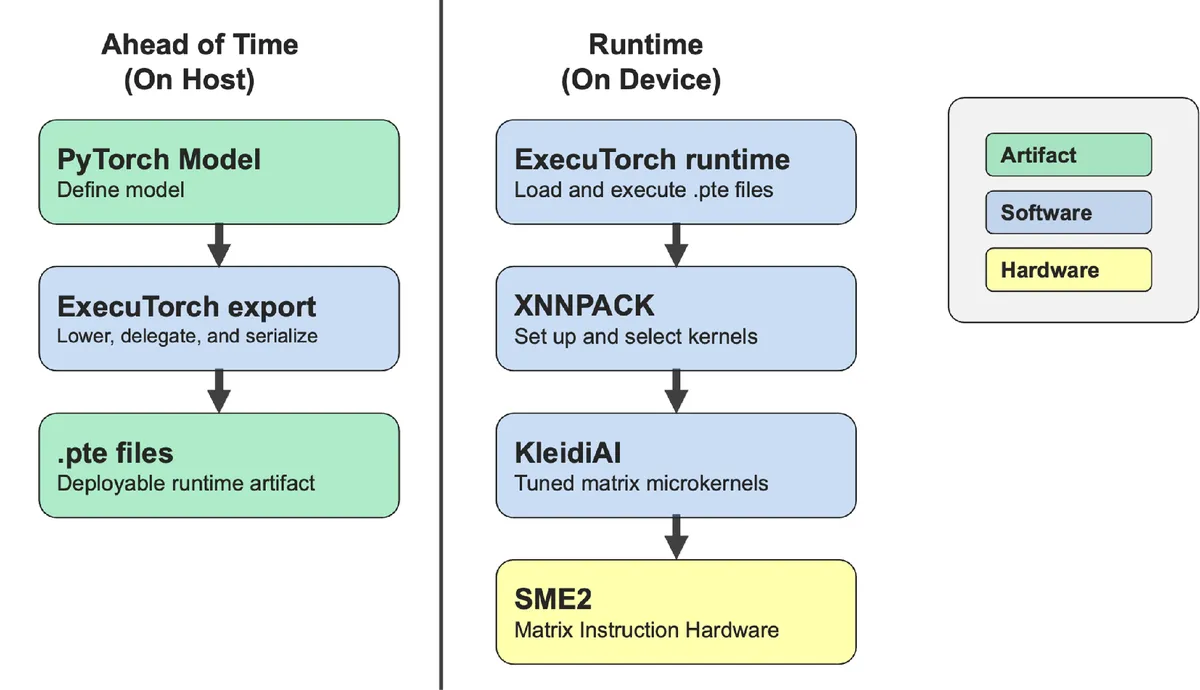
Az ExecuTorch a PyTorch peremhálózati következtetési keretrendszere. Exportálási eszközei a modellt egy .pte fájlba készítik elő, amelyet az eszköz futtatókörnyezete tölt be. A támogatott műveleteket az XNNPACK CPU-s következtetési könyvtár kezeli. Androidon az XNNPACK az Arm KleidiAI szoftverének mikromagjait választhatja, amelyek a mátrixszámítások belső műveleteire optimalizált rutinok. A nem delegált műveletek az ExecuTorch hordozható CPU-magjain futnak.
A Nemotron 3.5 RNN-T architektúrára épül. Kódolója FastConformer figyelmi és konvolúciós rétegekkel alakítja át a hangot, a prediktor LSTM-mel követi a kibocsátott tokenek előzményeit, az összekapcsoló réteg pedig a két reprezentációból következő tokent becsüli. A frontend 10 ezredmásodpercenként készít egy log-mel jellemzővektort, a kódoló pedig nyolcadára csökkenti az időpozíciók számát, így egy pozíció 80 ezredmásodpercnyi hangot képvisel.
A hosszabb darabok pontosabb, de később érkező szöveget adnak
A PyTorch négy adathalmazon, összesen 14 019 megnyilatkozáson mérte az eredményeket. A tesztben FP32, FP16 és INT8 pontosságot vizsgáltak, négy különböző hangdarabmérettel. Az INT8 változat QC8W konfigurációt használt, dinamikus INT8 aktivációkkal és csatornánkénti INT8 súlyokkal az erre alkalmas lineáris műveleteknél.
Az FP16 WER értéke 80 és 1120 ezredmásodperc közötti darabméretnél 15,2 százalékról 11,5 százalékra csökkent. A QC8W esetében ugyanez 15,5 százalékról 11,7 százalékra változott. Az FP16 gyakorlatilag megegyezett az FP32 eredményével, a különbség minden darabméretnél 0,03 százalékpont alatt maradt. A QC8W 0,21 és 0,31 százalékpont közötti WER többletet adott az FP32-höz képest.
A hosszabb darabok javították a végső átírás pontosságát, ugyanakkor növelték az első szöveg és a későbbi frissítések megjelenéséig szükséges várakozást. A vizsgált lookahead értékekhez 80, 320, 560 és 1120 ezredmásodperces darabok tartoztak.
Az SME2 jelentősen csökkentette a feldolgozási időt
A tesztben egy 24,9 másodperces felvételt dolgoztak fel Google Pixel 11 készüléken, egy középkategóriás CPU-magon futó inferenciaszállal. Az ExecuTorch 1.3.1 két változatát hasonlították össze, SME2 támogatással és anélkül. A modellfájlok és az XNNPACK, valamint a KleidiAI használata mindkét esetben azonos maradt.
SME2 nélkül az FP16 feldolgozási ideje 9,79 másodperc, a QC8W-é 5,20 másodperc volt. SME2 használatával ezek az értékek 4,61, illetve 3,24 másodpercre csökkentek. Ez az FP16 esetében 2,12-szeres, a QC8W-nél 1,61-szeres gyorsulást jelentett. SME2 mellett a valós idejű szorzó FP16-nál 0,19, QC8W-nél 0,13 lett.
A PyTorch ETDump elemzése szerint a gyorsulás legnagyobb részét a GEMM, vagyis a mátrixszorzási műveletek adták. FP16 esetében ezek ideje 8,2 másodpercről 3,1 másodpercre, QC8W-nél 4,1 másodpercről 2,0 másodpercre esett. Az adatmozgatás ideje nagyjából változatlan maradt, ezért ennek részesedése a teljes futásból megnőtt. A mérés szerint ez további optimalizálási lehetőséget jelenthet.