Megjelent a PyTorch 2.15, alapértelmezett lett az új NCCL backend
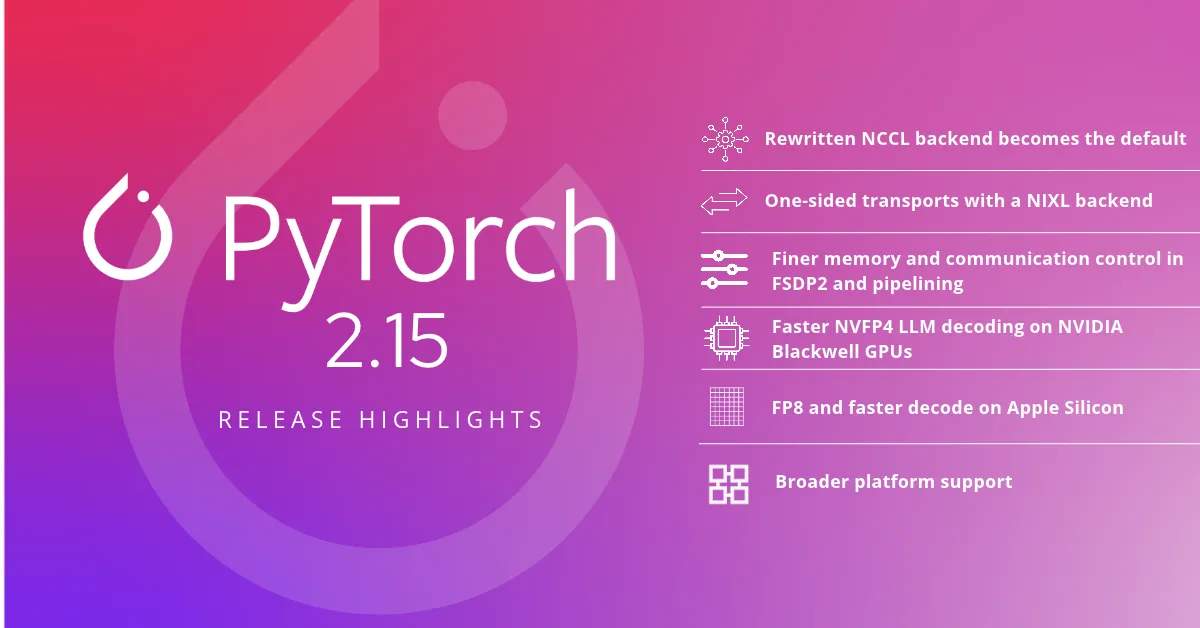
Megjelent a PyTorch 2.15, amelyben az újraírt NCCL backend alapértelmezetté vált az NVIDIA GPU-kat használó elosztott feladatoknál. A kiadás a több GPU-s betanítást, az Apple Silicon teljesítményét, az AMD és Intel támogatását, valamint a CUDA- és Python-kompatibilitást is bővíti.
- Az újraírt NCCL backend alapértelmezett lett az nccl folyamatcsoportoknál.
- A flight recorder elakadt kollektív műveleteknél utólagos hibakeresési adatokat ment.
- Az FSDP2 és a pipeline parallelism részletesebb memória- és kommunikációvezérlést kapott.
- Az Apple Silicon MPS teljesítménye több műveletnél és a MoE-dekódolásnál javult.
- A PyTorch 2.15 CUDA 13.2, ROCm 10.0 és Python 3.15 támogatást is hozzáad.
Az új NCCL backend alapértelmezett lett
A PyTorch 2.15 az újraírt NCCL backendet használja alapértelmezésként minden olyan folyamatcsoportnál, amely az nccl beállítást használja. A backend a PyTorch 2.14-ben még opt-in, vagyis külön bekapcsolható nccl2 megoldásként jelent meg.
A korábbi működéshez két visszaállítási lehetőség marad: a TORCH_DIST_USE_NCCL2=0 környezeti változó, illetve az nccl-legacy backendnév. A kommunikációs folyamatok létrehozása most a folyamatcsoporttal együtt, előre történik. Hibatűrésnél az újrakonfigurálás gyorsított shrink és grow útvonalat is használhat, amennyiben az NCCL 2.29 vagy újabb verziója áll rendelkezésre.
A kiadás egyik fontos újdonsága a backendfüggetlen repülési adatrögzítő, amely egy kollektív kommunikációs művelet elakadása esetén utólagos elemzéshez szükséges állapotot ír lemezre. A hibakereső szerver a watchdog állapotát is közzéteszi, így ha egy rangon időtúllépés történik, minden rangról készülhet ilyen jelentés. A PyTorch szerint ez segíthet feltárni, hogy az elakadás pillanatában mit végzett az egyes GPU-kat kiszolgáló folyamat.
Rugalmasabb elosztott tanítás és csővezetékes feldolgozás
A torch.distributed új Python-alapú átviteli API-t kapott az egyoldalas adatmozgatáshoz. Az első backend a NIXL. A transzportok tárolón keresztül kapcsolódnak a másik félhez, nincs szükségük folyamatcsoportra vagy kollektív műveletekre. A Transport.read_stream és Transport.write_stream CUDA-streamre ütemezi az átvitelt, így azok a torch.cuda.graph segítségével rögzíthetők. Ez az API a kiadásban még instabilnak számít.
Az FSDP2 pontosabb vezérlést ad a paraméterek pontossága és a CUDA-grafikonok rögzítése felett. A pontosságérzékeny paraméterek, például a MoE-routerek kapui és a normálási súlyok, fp32 formátumban maradhatnak, miközben a modell többi része bf16 formátumban tanul. Egy teljes gradiensfelhalmozási lépés egyetlen CUDA-grafikonban is rögzíthető, a gradiens pontossága pedig paraméterenként állítható.
A pipeline parallelism kevesebb előre lefoglalt memóriával dolgozik, és a fogadási puffereket csak közvetlenül az egyes fogadások előtt hozza létre. A rendszer a továbbítások befejezése után felszabadítja a forward kimeneteit, korlátozható a folyamatban lévő küldések száma, az FSDP gradienscsökkentése pedig átfedhető a következő számítási lépésekkel. A PyTorch szerint ezzel a pipelining rögzíthetővé és determinisztikussá válik, miközben több teljesítményhangolási lehetőséget kínál.
Gyorsul az Apple Silicon, bővül a hardvertámogatás
A PyTorch 2.15-ben több MPS-operátor natív Metal-kernelre váltott az MPSGraph helyett. A PyTorch közlése szerint egy 128 256 elemű szókészleten végzett, egyetlen soros softmax akár nyolcszor gyorsabb, az upsample visszaterjesztése pedig legfeljebb 21,7-szer gyorsabb lehet. A normálási teljes redukciók több mint százszoros gyorsulást érhetnek el.
Decode-feladatoknál az F.linear a meglévő gemv-kerneleket használja, ami a PyTorch mérése szerint 1,23-szoros geometriai átlagos gyorsulást, kisebb projekcióknál pedig akár ötszörös gyorsulást ad. Az új grouped_mm gemv-útvonala egy M3 Ultra gépen 1,32 és 1,34 közötti értékkel növelte a MoE-dekódolás tokenenkénti sebességét. Az Apple Silicon támogatása az FP8-cal, a float8_e4m3fn típussal, a _scaled_mm művelettel és a nyilvános torch.mps.Stream API-kkal is bővül.
A kiadás alapértelmezett csomagja CUDA 13.2-re, pontosabban a 13.2.2-es eszközkészletre vált, miközben CUDA 13.4-es csomagok is elérhetők Linux x86_64, Linux aarch64 és Windows rendszerekhez. A CUDA 13.4-es csomagok kísérleti támogatást adnak az NVIDIA Rubin GPU-khoz. AMD oldalon ROCm 10.0-s csomagok érkeznek a PyTorch 2.14-ben bevezetett ROCm 7.14 mellé, az Intel GPU-k pedig egyszerűbb SYCL-kernelfejlesztést és több GPU-s profilozást kapnak.
Új verziók és több mint háromezer változtatás
A PyTorch 2.15 a Python 3.11 és 3.15 közötti verziókat támogatja, beleértve a szálbiztonságra optimalizált, szabad szálkezelésű 3.14t és 3.15t kiadásokat. A Dynamo ebben a verzióban Python 3.15 támogatást kapott, így a torch.compile is használható ezzel a Python-verzióval.
A kiadás az OpenAI által fejlesztett PyTorch 2.14 óta 3117 commitból áll, amelyekhez 583 közreműködő járult hozzá. A PyTorch 2.x sorozat célja a projekt közlése szerint, hogy a kutatásközpontú keretrendszerből egységes, hardverfüggetlen platformmá váljon a nagy léptékű éles betanításhoz és következtetéshez.
A fejlesztők a PyTorch 2.15 kipróbálását és az esetleges problémák jelentését kérik. A kiadásról kérdezni lehet a 2026. november 5-én, csendes-óceáni idő szerint délelőtt 11 órakor kezdődő kérdezz-felelek webináron is. Tristan Rice, Natalia Gimelshein, Huy Do és Jane Xu, mindannyian a Metától, áttekintik a kiadást és válaszolnak a közösség kérdéseire, a moderátor Chris Gottbrath lesz a Gottbrath Tech képviseletében.
PyTorch: PyTorch 2.15 Release Blog