Q2RL: így tanulhatnak tovább a bemutatott mozdulatokból a robotok
A RAI Institute Q2RL nevű módszere lehetővé teszi, hogy a robotok az emberi bemutatásokból megtanult viselkedést online megerősítéses tanulással fejlesszék tovább. A megoldás célja, hogy a robot alkalmazkodjon a megváltozott körülményekhez anélkül, hogy közben elfelejtené a korábban elsajátított mozdulatokat.
- A Q2RL a viselkedésmásolást online megerősítéses tanulással kapcsolja össze.
- A módszer célja a katasztrofális felejtés elkerülése az RL-re való átálláskor.
- Valós roboton a pipe assembly sikeressége 20 százalékról 75 százalékra nőtt.
- Kitting feladatban a teljesítmény 35 százalékról 70 százalékra javult.
- A módszerhez olyan politika kell, amely cselekvési valószínűségeket és entrópiát szolgáltat.
A viselkedésmásolás korlátai
A viselkedésmásolás, angolul Behavior Cloning, során a robot emberi bemutatások alapján tanulja meg az összetett feladatokat. Ez hatékony módja új manipulációs készségek betanításának, a módszer azonban önmagában nem ad lehetőséget arra, hogy a robot a bemutatási adatokon túl is önállóan fejlődjön.
Ez problémát okozhat, ha változik a feladat vagy a környezet. A teljesítmény gyorsan romolhat például akkor, ha elmozdulnak a tárgyak, megváltozik a megvilágítás, vagy a robot olyan helyzettel találkozik, amely a bemutatásokban csak korlátozottan szerepelt. A megerősítéses tanulás, vagyis az RL lehetőséget adna a saját tapasztalatokból való tanulásra, az offline viselkedésmásolásról az online tanulásra való átállás azonban gyakran katasztrofális felejtéshez vezet. Az RL felülírhatja a korábban megtanult jó viselkedéseket.
Két lépésben védi meg a korábbi tudást
A 2026. szeptember 8-án bemutatott Q2RL, vagyis a Q-Estimation and Q-Gating from Behavior Cloning for Reinforcement Learning, ezt az átállást kezeli. A módszert a Robotics: Science and Systems 2026 konferencián mutatták be. A megoldás két szakaszból áll.
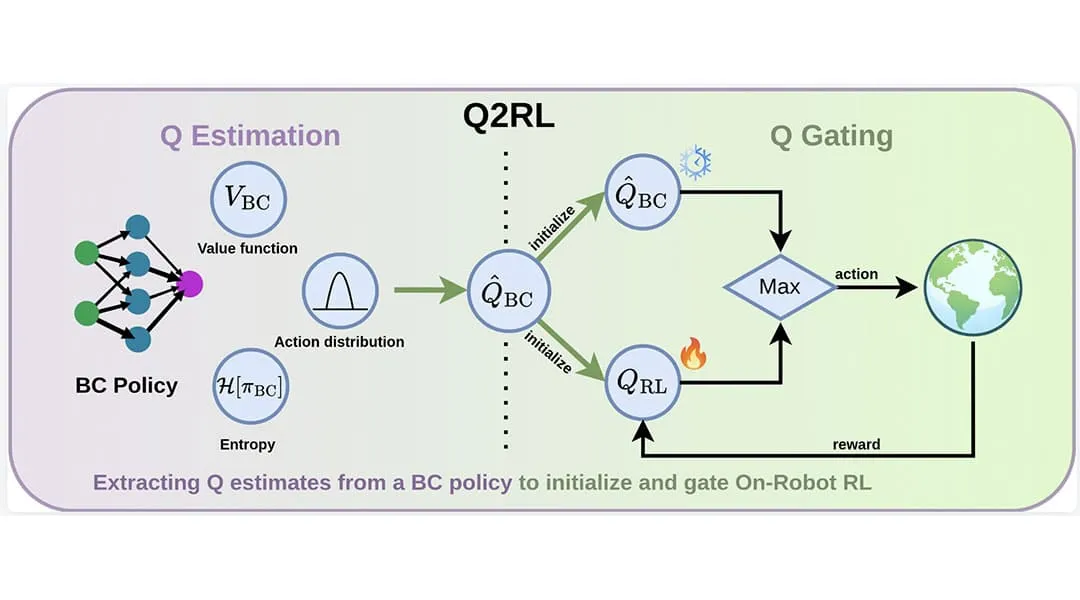
Az első a Q-Estimation. Ebben a már meglévő viselkedésmásoló politika alapján megbecsülik a Q-függvényt, amely az egyes cselekvések várható értékét jelzi. A rendszer a politika cselekvési valószínűségeit, ezen belül a bizonyosságot és az entrópiát elemzi, majd magasabb Q-értéket rendel azokhoz a műveletekhez, amelyekben a politika eleve magabiztos. Ehhez nincs szükség az eredeti, nagy és sokféle tanítási adathalmazra.
A második szakasz a Q-Gating. A rendszer két Q-függvényt tart fenn: az egyik rögzített, és a viselkedésmásolási politikát képviseli, a másik tanulható, és az új RL-politikát írja le. Minden lépésben összehasonlítja a becsült értékeket, majd azt a műveletet hajtja végre, amelyik nagyobb értékűnek tűnik. Így a robot használhatja az RL által megtanult új megoldásokat, miközben megőrzi az emberi bemutatásokból származó jó viselkedéseket.
Szimulációban és valódi roboton is javított
A RAI Institute a Q2RL-t a D4RL és a robomimic szimulációs feladatain értékelte. A módszer általában javított a kezdeti viselkedésmásoló politikán, és több offline, majd online tanulási alapmódszert is felülmúlt a sikerességi arány és a konvergencia sebessége terén. A robomimic feladatain a Q2RL volt az egyetlen olyan módszer, amely offline adatok nélkül is megbízhatóan tanult, miközben adathozzáférés mellett is versenyképes maradt.
A valós kísérletekben egy hét szabadságfokú Franka Panda robotot és Robotiq 2F-85 megfogót használtak. A robot peg insertion, pipe assembly és kitting feladatokat végzett, RGB-kamerák képei alapján. A Q2RL minden feladaton javított 1-2 óra online interakció alatt.
- A peg insertion feladatban 100 százalékos sikerességet ért el.
- A PVC-cső megfogását és behelyezését igénylő pipe assembly feladatban a sikeresség 20 százalékról 75 százalékra nőtt.
- A megváltozott feladateloszlás mellett végzett kitting feladatban az eredmény 35 százalékról 70 százalékra javult.
A robot eldöntheti, mikor kell eltérnie
A rendszer egyik fontos tulajdonsága, hogy nem váltja le teljesen a viselkedésmásolási politikát. A robot például a feladat korai szakaszában, a megfogásnál és a durva illesztésnél a korábbi politikát használhatja, majd a pontos, érintkezésigényes behelyezésnél átválthat az RL által javasolt műveletekre. Így akkor is továbbhaladhat, ha a bemutatásokban látott viselkedés elakad.
A kitting tesztben a betanításkor minden rekeszben egy tárgy volt, a teszteléskor viszont több tárgy került a rekeszekbe. A robot a megszokott mozgásoknál a viselkedésmásolást, a megváltozott helyzetekben pedig az RL-t használta. A módszer a RAI Institute szerint a biztonságos felfedezést is segítette, mivel egy összehasonlított alapmódszer túl nagy erőt fejtett ki a táblára és hibát okozott, Q2RL mellett azonban ilyen biztonsági szabálysértést nem tapasztaltak.
A megoldás korlátja, hogy a viselkedésmásoló politikának cselekvési valószínűségeket és entrópiát kell szolgáltatnia. A kutatók olyan politikaosztályokra szeretnék kiterjeszteni a módszert, amelyek ezeket a mérőszámokat eredendően nem adják meg.
RAI Institute: Q2RL: Reinforcement Learning to Improve Beyond Behavior Cloning