A Sanctuary AI módszere felgyorsítja a robotok tanulását
A Sanctuary AI TIGER nevű módszere sűrű jutalmazási jelet ad a robotoknak a megerősítéses tanulás során, így a rendszer a tesztelt feladatokon 20-57 százalékkal kevesebb interakcióval érte el az 50 százalékos sikerességet. A vállalat szerint a módszer valódi roboton is csökkenti a kezdeti biztonsági leállásokat.
- A TIGER az utánzási politikát sűrű jutalmazási jelként használja.
- A tesztelt feladatokon 20-57 százalékkal kevesebb interakció kellett az 50 százalékos sikerhez.
- Az első 1000 valódi robotos lépésben nulla biztonsági visszaállítást mértek.
- A Robomimic ToolHang feladatán a TIGER 79 százalékos sikerességet ért el.
- A humanoid alakválogató feladatban 93 százalékos sikerességet mértek.
Az utánzás önmagában kevés lehet
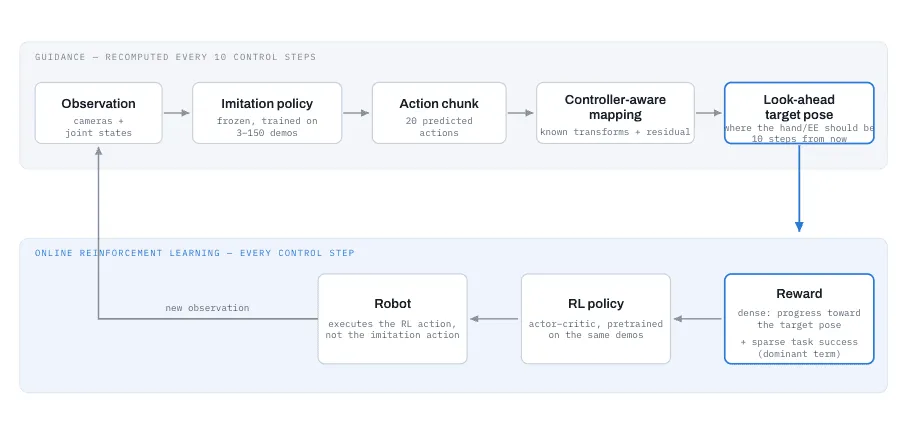
A Sanctuary AI október 2-án ismertette a TIGER, vagyis Task-Space Imitation Guidance for Efficient Reinforcement Learning nevű megközelítését. A módszer lényege, hogy az utánzási politika nem vezérlőként irányítja a robotot, hanem sűrű jutalmazási jelet szolgáltat a megerősítéses tanuláshoz.
Az utánzási tanulás a bemutatott viselkedés reprodukálására törekszik. Ez nem feltétlenül jelenti azt, hogy a robot a feladat sikerét, a változó körülményekhez való alkalmazkodást vagy a rövid ciklusidőt is optimalizálja. A Sanctuary AI szerint ha a bemutató lassú volt, a politika is lassú maradhat, és az ismeretlen zavarokra sem feltétlenül tud megfelelően reagálni.
A megerősítéses tanulás közvetlenül a feladat sikerét próbálja maximalizálni, a ritka jutalom azonban komoly nehézséget okoz. A robot sokáig csak próbálkozik, miközben egy valódi munkakörnyezetben leejtheti a tárgyakat vagy nem biztonságos helyzetbe kerülhet. Ezek a helyzetek emberi beavatkozást és a robotcella visszaállítását igényelhetik.
A TIGER a haladás irányát méri
A modern utánzási politikák nem feltétlenül egyetlen mozdulatot, hanem egy körülbelül egy másodpercre elegendő, húsz akcióból álló akciócsomagot jeleznek előre. A TIGER ezt a csomagot nem végrehajtandó utasításként kezeli. A robot vezérlőjén keresztül leképezi, majd rövid távú végponti referencia, vagyis a robot kezének várható mozgását leíró jel készül belőle.
A jutalmazás az egymást követő lépések közötti pózigazítás változását méri. Így a robot nem pusztán egy referencia közelében lévő kényelmes pozíciót keres, hanem azért kap jutalmat, ha a megfelelő irányba halad. A ritka feladatreward továbbra is meghatározza, mit jelent a siker. A vállalat a sűrű jutalmat úgy skálázza, hogy egy sikertelen epizód teljes jutalma ne haladhassa meg egy siker jutalmát.
A rendszer a robot mozgását a vezérlő skálázásával, a koordinátarendszerekkel, a késleltetéssel és a követési képességgel együtt becsüli. A bemutatókból tanult korrekciót robotonként és vezérlőnként egyszer illesztik, ez a Sanctuary AI szerint egy másodpercnél rövidebb időt vesz igénybe, és körülbelül öt bemutató után telítődik.
Szimulációban és valódi roboton is tesztelték
A TIGER-t hét, ritka jutalmú szimulációs feladaton, a MetaWorld, a Robomimic és egy humanoid alakválogató beillesztési feladat keretében, továbbá mind a tíz LIBERO-Spatial feladaton vizsgálták. Valódi hardveren három, érintkezésben gazdag feladaton tesztelték egy Franka Emika Research 3 robottal. A szimulációs eredmények öt véletlen mag átlagai.
A módszer minden vizsgált feladaton korábban érte el az 50 százalékos sikerességet, mint a hozzá illesztett megerősítéses tanulási háttérrendszer. A szükséges interakciók száma 20-57 százalékkal csökkent. A Robomimic ToolHang feladatán, ahol a robotnak egy legfeljebb 600 vezérlési lépésből álló, kétlépcsős összeállítást kell végrehajtania, a két megerősítéses tanulási alapvonal nem ért el sikert. A TIGER 79 százalékos eredményt ért el, miközben a viselkedésklónozó politika 50 százaléknál állt meg.
A humanoid alakválogató feladatban a viselkedésklónozás 10, a TIGER 93 százalékos sikerességet ért el. A tíz LIBERO-Spatial feladaton, feladatonként tíz bemutatóval, egyetlen megosztott politika 95 százalékos végső sikerességet ért el.
A valódi roboton a korai tanulási szakasz különbségét emelte ki a Sanctuary AI. A véletlenszerűen elhelyezett blokk felvétele a TIGER-rel körülbelül 8000, az alapvonalakkal körülbelül 12 000 környezeti lépés után konvergált. Egy meghatározott, kis fogantyújú fiók nyitása körülbelül 7000, illetve 12 000 lépést igényelt. A vállalat beszámolója szerint az első 1000 valódi robotos lépésben a TIGER-nél nulla biztonsági visszaállítás történt, míg az alapvonalaknál 35-38 ilyen esetet mértek.
Sanctuary AI: TIGER: Task-Space Imitation Guidance for Efficient Reinforcement Learning