A Qodo tesztjén Claude és GLM végzett az AI-kódreview élén
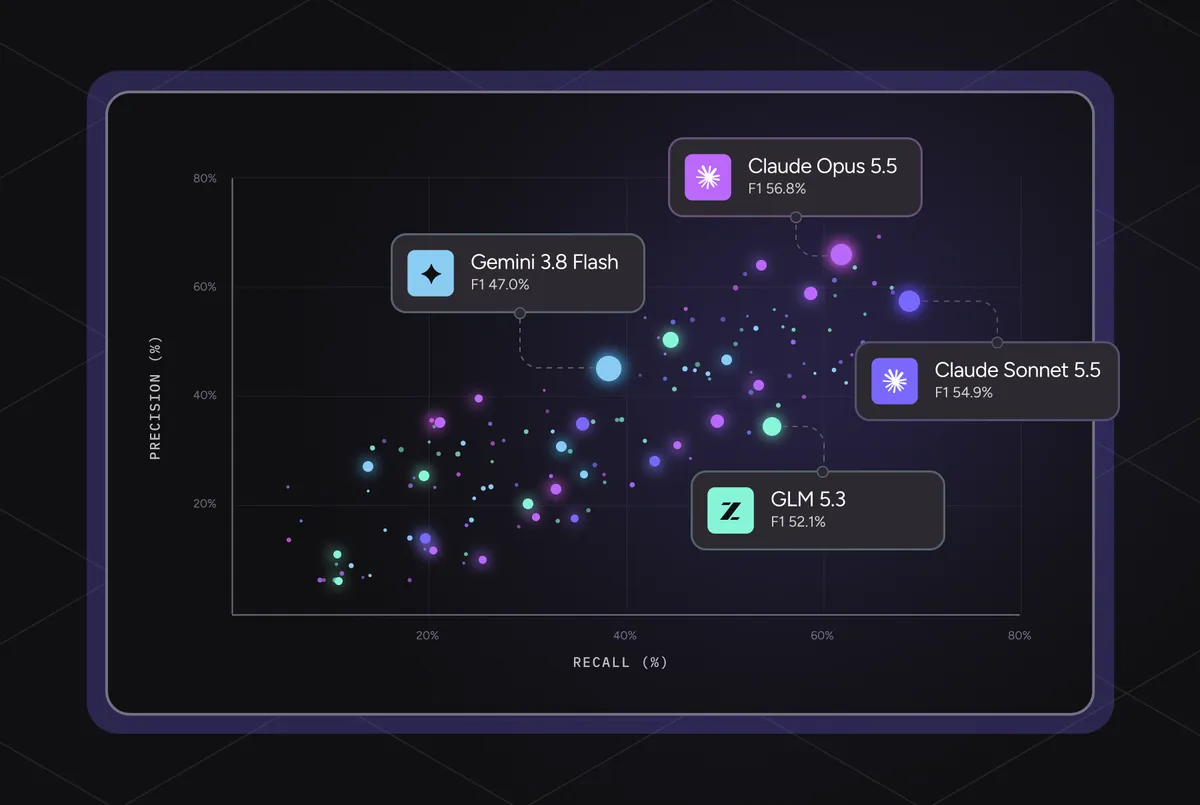
A Claude Opus 5.5 érte el a legmagasabb F1-értéket a Qodo legújabb kódreview-tesztjén, amelyben 13 modellt és 38 modell-, illetve következtetési konfigurációt vizsgáltak. A mérés valódi szoftverhibákból összeállított adathalmazon készült, és a minőség mellett a költséget, valamint a sebességet is figyelembe vette.
- A Claude Opus 5.5 érte el a legmagasabb, 56,8 százalékos F1-értéket.
- A benchmark 125 pull request 703 ismert hibáját használta.
- Az open-weight modellek közül a GLM 5.3 végzett az élen.
- A magasabb következtetési szint költségesebb és lassabb lehet, jobb F1-érték nélkül.
- A Qodo a modellválasztást a review céljaihoz és a mérési eredményekhez igazítja.
Valódi hibákon hasonlították össze a modelleket
A Qodo saját, folyamatosan használt benchmarkjában 125 pull requestet vizsgáltak, amelyekben összesen 703, későbbi javításokból visszakövetett hiba szerepelt. A teszt azt mérte, hogy az egyes modellek az eredeti pull requestek átnézésekor észreveszik-e ezeket a problémákat.
A kutatók minden konfigurációnál egyetlen reviewert, standard ellenőrzési erőfeszítést és kikapcsolt explorer alügynököt használtak. Így a modell és a következtetési szint volt a két fő változó. Az eredményeket egy LLM-es értékelő, a Claude Sonnet 4.6 hasonlította össze az ismert hibákkal.
A fő mérőszám az F1 volt, amely a pontosság és a visszahívás egyensúlyát jelzi. A pontosság azt mutatja, hogy a modell jelzéseinek mekkora része valódi hiba, a visszahívás pedig azt, hogy az ismert hibák mekkora hányadát találta meg.
A Claude modellek kerültek az élre
A táblázat szerint a Claude Opus 5.5 magas következtetési szinten 56,8 százalékos F1-értéket ért el, 60,2 százalékos pontosság és 53,7 százalékos visszahívás mellett. Egy pull request átlagos költsége 1,00 dollár, a medián ellenőrzési idő pedig 144 másodperc volt.
A második helyen a Claude Sonnet 5.5 végzett 54,9 százalékos F1-gyel, ezt a Claude Fable 5.1 követte 53,5 százalékkal. Az open-weight modellek közül a GLM 5.3 szerepelt a legjobban, 52,1 százalékos F1-értékkel, megelőzve az OpenAI és a Google tesztelt konfigurációit.
A következő csoportba a DeepSeek V4 Pro, a Kimi K3, a GPT-6 Sol, a Gemini 3.8 Flash és a GPT-6 Astra került, 46 és 50 százalék közötti eredménnyel. A Qodo szerint egyetlen havi rangsor sem tekinthető véglegesnek, ezért minden jelentős modellkiadás után újrafuttatják a benchmarkot.
A nagyobb következtetési szint nem mindig hoz jobb eredményt
A teszt alapján a magasabb következtetési szint általában növeli a visszahívást, miközben ronthatja a pontosságot. A végeredmény modellenként eltérő. A Qodo példája szerint a GPT-6 Sol medium szinten 48,7 százalékos F1-értéket ért el 0,18 dolláros pull requestenkénti költséggel és 101 másodperces medián idővel. Xhigh szinten az F1 48,4 százalék lett, miközben a költség 0,51 dollárra, az idő pedig 224 másodpercre nőtt.
A költségek között több mint százszoros különbség volt. A táblázatban a GPT-6 Luna 0,02 dollárba került pull requestenként, míg a Gemini 3.8 Flash 3,63 dollárba. A Gemini 3.8 Flash 71,0 százalékos pontossága a táblázatban a legmagasabb volt, ugyanakkor az ismert hibáknak csak 35,1 százalékát találta meg.
Ez azt jelenti, hogy a csapatoknak választaniuk kell a kevés, nagyobb biztonsággal jelzett észrevétel, illetve a szélesebb hibafedettség között. A Qodo szerint nincs minden modellhez egyformán megfelelő következtetési szint.
A Qodo a modellek közötti váltást is automatizálja
A vállalat közlése szerint minden új modellt és következtetési szintet ugyanazon az értékelésen futtatnak át, majd a legjobban teljesítő kombinációt használják a Qodo éles rendszerében. A rangsor változásakor a produkcióban alkalmazott konfiguráció is változhat.
A Qodo több szolgáltató modelljeit és open-weight modelleket is támogat. Az alapértelmezett működésben több szolgáltató modelljei közül választanak az ellenőrzés egyes részeihez, ügyféligény esetén pedig konkrét szolgáltató vagy open-weight modell is használható. A vállalat ezt megfelelőségi, adatlokalizációs vagy meglévő szerződéses szempontokkal indokolja.
A Qodo szerint a rendszer az egyes review-k változó igényeihez igazíthatja a modell- és következtetésiszint-választást, például a lefedettség, a pontosság, a költség vagy a sebesség alapján. A mérési eredmények a 2026 szeptembere és októbere között befejezett futásokból származnak.
Qodo: Which LLM should review your code?