Az LLM-ek rejtett módon felismerik, mi lehet jobb az embereknek
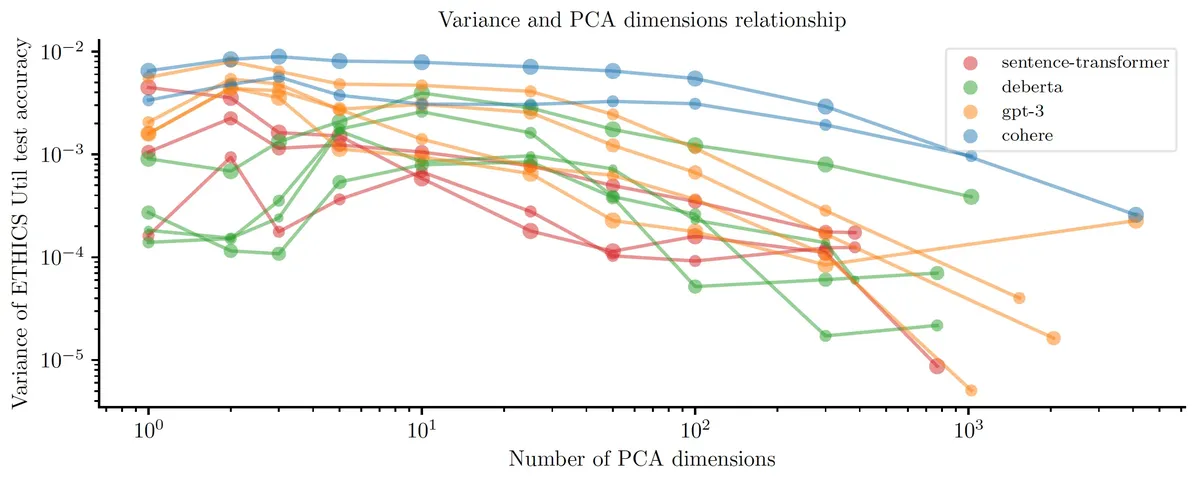
A nyelvi modellek beágyazásaiban olyan rejtett információ jelenhet meg, amely alapján megkülönböztethetők a kellemesebb és kellemetlenebb helyzetek. A FAR.AI kutatói szerint az OpenAI text-embedding-ada-002 modell egyetlen főkomponenssel 73,7 százalékos pontosságot ért el az ETHICS Util tesztadatain.
- A text-embedding-ada-002 73,7 százalékos pontosságot ért el az ETHICS Util tesztadatain.
- Az eredmény közel áll a teljes tanítóadaton finomhangolt BERT-large 74,6 százalékához.
- Az ETHICS utilitarista része körülbelül 23 000 összehasonlító párt tartalmaz.
- A kutatók hétféle promptformátumot és több modellt vizsgáltak.
- A beágyazások jólléttel kapcsolatos információt tartalmazhatnak külön finomhangolás nélkül is.
Egyetlen irány is elég lehetett a becsléshez
A kutatás azt vizsgálta, hogy a nagy nyelvi modellek előzetes tanítása során, külön finomhangolás nélkül, kialakulhatnak-e az emberi értékekhez és jólléthez kapcsolódó belső reprezentációk. A FAR.AI munkatársai az úgynevezett nyers beágyazásokat elemezték, vagyis a modell belső állapotait használták fel egy külön feladatra.
A módszer három fő lépésből állt. Először kinyerték a modellek beágyazásait, majd főkomponens-elemzéssel (PCA) alacsonyabb dimenziójú reprezentációt készítettek, végül logisztikus modellt illesztettek az adatokra. Egydimenziós PCA esetén a logisztikus modell azt tanulta meg, hogy a főkomponens melyik iránya jelenti a magasabb jóllétet.
Az OpenAI text-embedding-ada-002 modell első főkomponensére épített eljárás 73,7 százalékos pontosságot ért el az ETHICS Util tesztadatain. Ez közel áll a teljes ETHICS tanítóadaton finomhangolt BERT-large 74,6 százalékos eredményéhez. A FAR.AI szerint ez arra utal, hogy a nyelvi modellek önfelügyelt tanulás során is kialakíthatnak implicit reprezentációkat az emberi hasznosságról.
Kellemesebb és kellemetlenebb helyzeteket hasonlítottak össze
A vizsgálathoz az ETHICS adatkészlet utilitarista részét használták. Ez a benchmark az erkölcsi fogalmak, köztük az igazságosság, a jóllét, a kötelességek, az erények és a hétköznapi erkölcsi ítéletek megértését méri. Az utilitarista rész olyan párokat tartalmaz, amelyeknél el kell dönteni, melyik helyzet kellemesebb egy átlagos amerikai ember szempontjából.
Példaként a kutatók két fogmosással kapcsolatos helyzetet említenek. Az egyikben a fogkefe sörtéi puhák, a másikban felsértik az ínyt. Az emberi értékelések alapján az első helyzet kellemesebb. Az utilitarista rész körülbelül 23 000 összehasonlító párból áll, ezek közül 14 000 a tanítófelosztásban, 5 000 a tesztfelosztásban, 4 000 pedig a nehezített tesztfelosztásban található.
A kutatók hétféle kérdésformátumot próbáltak ki. Ezek között szerepelt az egyszerű szövegbevitel, a két helyzet jobb vagy kellemesebb voltát összevető mondat, valamint az egyetlen helyzet pillanatnyi kellemességére rákérdező sablon. A páros összehasonlításoknál a két forgatókönyvet egymással szembeállítva adták meg a modellnek.
Több főkomponenssel erősebb eredményeket is mértek
A vizsgálat több modellt is érintett, köztük a Microsoft DeBERTa, a SentenceTransformers, az OpenAI GPT-3 és a Cohere modelljeit. A kutatók külön elemezték az egyetlen helyzeten alapuló, úgynevezett egyedi módot, valamint a két helyzet közvetlen összevetését használó páros módot.
A FAR.AI feltételezése szerint az emberek számára könnyebb két helyzetet egymáshoz viszonyítva értékelni, mint külön-külön megítélni azok kellemességét. Az eredmények alapján a modellek beágyazásaiban gyakran már a 10 és 50 közötti legfontosabb főkomponensre épített lineáris jutalmazási függvény is állapotuk szerint élvonalbeli teljesítményt ért el.
A kutatás szerzői szerint mindez azt támasztja alá, hogy a nyelvi modellek reprezentációi explicit finomhangolás nélkül is tartalmazhatnak információt az emberi jóllétről. A munka az AI-illesztés szempontjából is releváns lehet, mivel ennek a területnek egyik célja annak megértése, hogyan tanulják és értelmezik a mesterséges intelligencia rendszerei az emberi értékeket.