Rekordszámú résztvevővel érkezett az MLPerf Inference v6.1
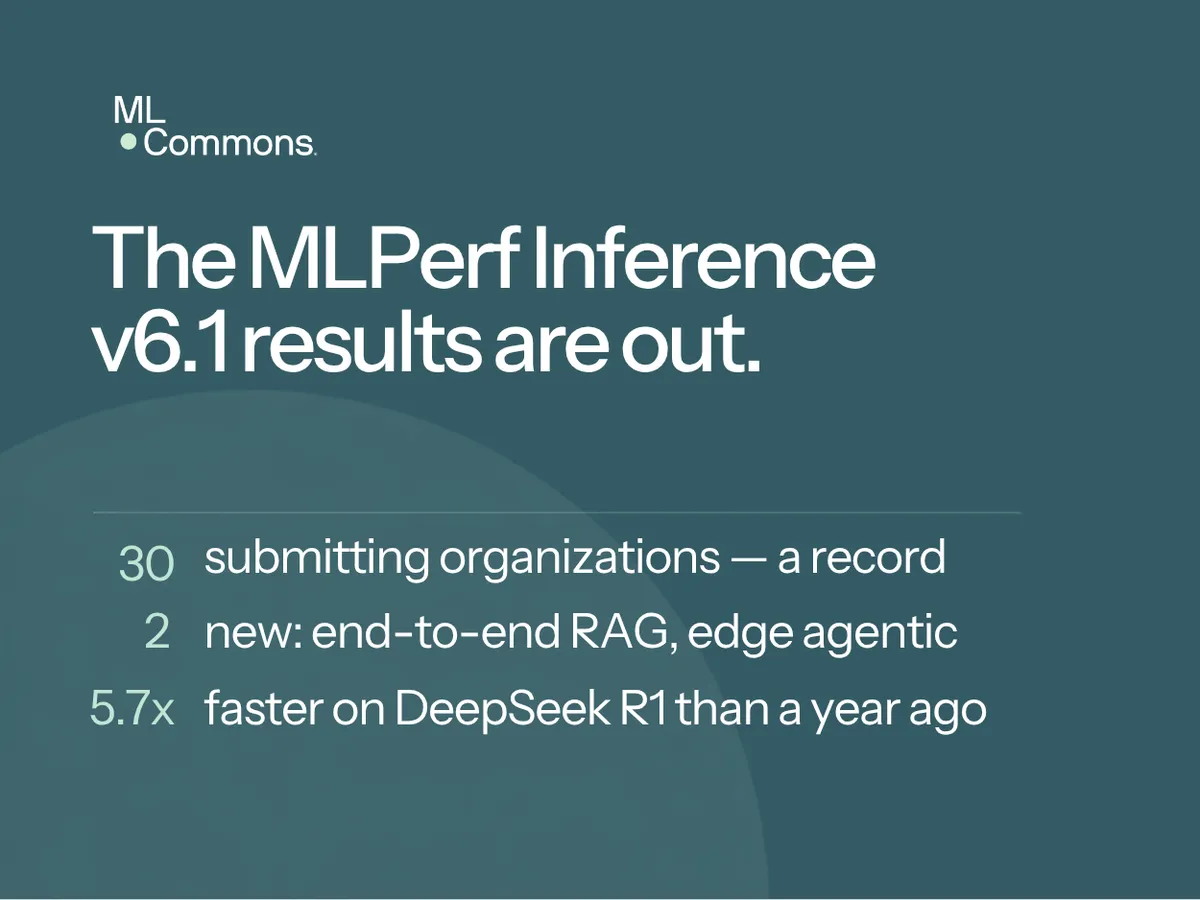
Az MLCommons közzétette az MLPerf Inference v6.1 eredményeit, amelyekben rekordszámú, 30 szervezet vett részt. A kiadás két új tesztet vezetett be, és egyes feladatokban akár 5,7-szeres teljesítménynövekedést mutatott az egy évvel korábbi eredményekhez képest.
- Az MLPerf Inference v6.1 fordulójában 30 szervezet vett részt.
- Két új teszt érkezett, az End-to-End RAG és az Edge Agentic Inference.
- A Deepseek R1 teszt legjobb eredménye egy év alatt 5,7-szer javult.
- A fordulóban először szerepelt több új AMD, Intel és NVIDIA platform.
- A résztvevők több mint fele API-központú tesztkörnyezetet használt.
A több lépésből álló AI-rendszereket is mérik
Az MLPerf Inference nyílt forráskódú benchmarkrendszer architektúrasemleges, reprezentatív és megismételhető módon méri a rendszerek teljesítményét. Az MLCommons szerint a közzétett adatok segíthetik az AI-rendszereket beszerző és üzemeltető ügyfeleket abban, hogy empirikus teljesítményadatokra támaszkodva hozzanak döntéseket.
A v6.1 két új teszttel bővíti a csomagot. Az End-to-End Retrieval-Augmented Generation, vagyis RAG-benchmark olyan kérdés-válasz rendszert vizsgál, amely több AI-modellből és feldolgozási lépésből áll. A lekérdezést egy embeddingmodell vektorrá alakítja, a kereső jelölteket választ ki egy vektoradatbázisból, az újrarangsorolás pontosítja a listát, egy vagy több nagy nyelvi modell pedig ezek alapján állítja elő a választ. A teszt külön méri a dokumentumkorpusz feldolgozását és az előre elkészített vektoradatbázison végzett kérdés-válasz műveleteket.
Az Edge Agentic Inference a többfordulós, ügynökalapú feladatokra összpontosít, például az agentikus kódolásra. A mérés figyelembe veszi a növekvő beszélgetési előzményt, az információgyűjtést és az erre épülő ismételt következtetést. A teszt egyetlen adatfolyamú kódolási munkaterhelést, késleltetési mutatókat, peremhálózati modellt és kvantálást használ, valamint két feladatot tartalmaz: a pontosság vizsgálatát időkorlát mellett, továbbá egy determinisztikus munkafolyamat teljesítménymérését.
Új hardverek és gyorsuló eredmények
Az MLPerf Inference v6.1 támogatja a spekulatív dekódolást is. Ez a gyártási következtetési rendszerekben használt optimalizáció több tokent jósol és ellenőriz egyetlen előreirányú számításban. A megoldás két benchmark interaktív forgatókönyvében kapott támogatást, a GPT-OSS feladatban is.
A beadott rendszerek között gyorsítók, kártyák, munkaállomások és szerverek szerepeltek. Öt új processzor vagy gyorsító jelent meg az eredményekben: az AMD Ryzen AI Max+ 395, az AMD Instinct MI350P, az Intel Arc Pro B70, valamint előzetesként az NVIDIA Rubin és az NVIDIA Vera Rubin NVL72. A fordulóban szerepelt az MLPerf Inference eddigi legnagyobb, 512 gyorsítót használó rendszere is.
A VLM-tesztben a legjobb, gyorsítónkénti szerveres eredmény a v6.0-hoz képest 2,99-szer javult hat hónap alatt. A Deepseek R1 tesztben a legjobb, gyorsítónkénti szerveres eredmény a v5.1-hez képest 5,7-szer volt jobb egy év alatt. Az MLCommons szerint ez több felhasználó kiszolgálását vagy összetettebb következtetési feladatok futtatását teheti lehetővé.
Harminc szervezet nevezett, készül az MLPerf Endpoints
Az MLPerf Inference v6.1 fordulójára 30 résztvevő adott be eredményt. A listán többek között az AMD, az ASUSTeK, a Cisco, a CoreWeave, a Dell, a Google, az Intel, a Microsoft Azure, az NVIDIA, az Oracle és a RedHat szerepel. Első alkalommal nyújtott be eredményt az Atlas Inference, a Crusoe, az Orrick Industries LLC, a ScitiX, a VibeHPC és Naeem Khoshnevis egyéni közreműködő.
A résztvevők több mint fele az új, API-központú tesztkörnyezetet használta. Ez szabványos iparági API-kon keresztül, valódi kliens-szerver architektúrában továbbítja a lekérdezéseket és az eredményeket, így az MLCommons szerint pontosabban tükrözi az adatközponti telepítéseket.
Az MLCommons közlése szerint a jövőben az MLPerf Endpoints váltja fel az Inference benchmarkot az adatközponti tesztek családjában. A v6.1 eredményei az adatközponti és peremhálózati eredményoldalakon, valamint egy interaktív eredmény-irányítópulton érhetők el. A benchmark adatai a beszerzési döntésekhez kínálnak összehasonlítható technikai alapot, miközben az új tesztek az összetettebb, több lépésből álló AI-telepítések teljesítményét is láthatóvá teszik.
MLCommons: MLCommons Sets Participation Record with New MLPerf Inference v6.1 Benchmark Results