A Together AI bemutatja, hogyan tanítható saját Jev-szerű modell 17 dollárból
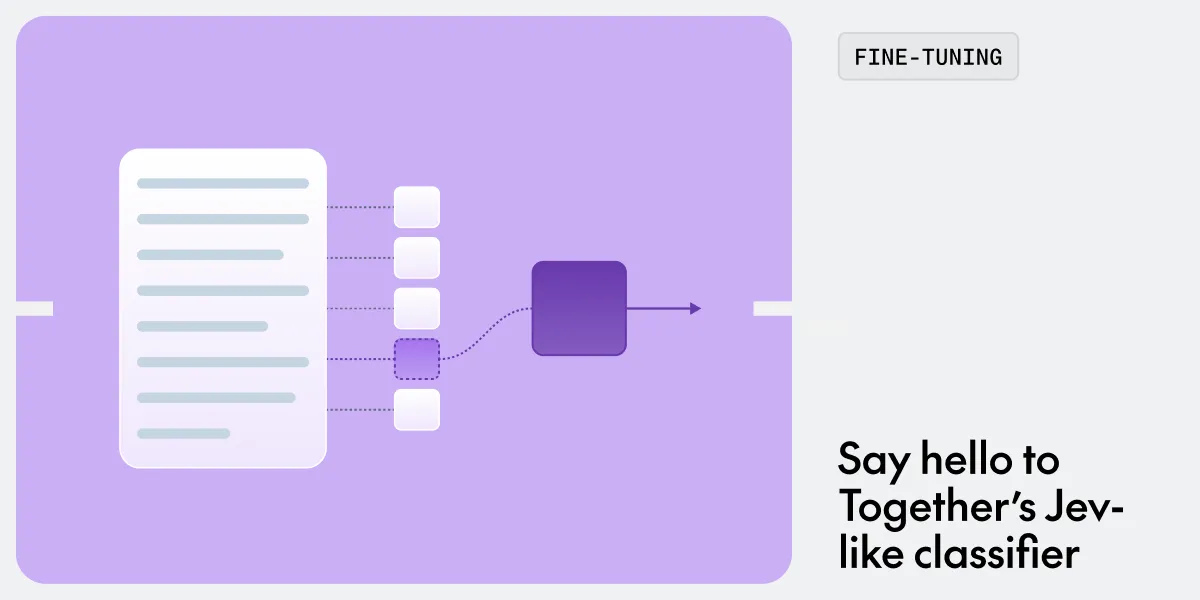
A Together AI bemutatta saját Jev-szerű osztályozó modelljét, a Qwen3.5 4B-re épülő together/Tev1-4B-experimental rendszert. A vállalat útmutatója azt is részletezi, hogyan lehet hasonló modellt finomhangolni és API-végponton elérhetővé tenni körülbelül 17 dollárból.
- A Together AI Qwen3.5 4B-re épülő Jev-szerű osztályozó modellt indított.
- A vállalat útmutatója körülbelül 17 dolláros finomhangolási költséget említ.
- A tanítás a forrás szerint nagyjából 25 percet vesz igénybe.
- A modell JSON-bemenetből címkét, kulcsot vagy más előre meghatározott választ ad.
- A kész modell Together AI dedikált API-végpontján telepíthető.
Gyors válaszokat ad előre megadott lehetőségekre
A Together AI szerint a Jev olyan osztályozó modell, amely állapotleírásból és előre meghatározott kérdésekből gyorsan készít eredményt. A válasz lehet pontszám, logikai érték vagy feleletválasztós eredmény. Ilyen rendszert használhatnak például webáruházak az automatikus visszaküldések értékelésére, gépi tanulással foglalkozó tanulmányok kategorizálására vagy szövegek hangulatelemzésére.
A vállalat saját példájában egy ügyfél azt írja, hogy ugyanazért az októberi előfizetésért kétszer terhelték meg a kártyáját, alkalmanként 19,99 dollárral. A modellnek négy támogatási szándék közül kell kiválasztania a megfelelőt. A finomhangolt rendszer az A választ adta, vagyis azt, hogy az ügyfelet többször terhelték meg.
Qwen3.5 4B és több osztályozási adathalmaz
A bemutatott modell alapja a Qwen3.5 4B. A Together AI több, a Hugging Face-en elérhető adathalmazból válogatott a tanításhoz. Ezek között szerepel a MultiNLI, a BoolQ, a Banking77, az AG News és az SST-5, továbbá programozott szabályokhoz, útválasztási döntésekhez és kutatási taxonómiákhoz kapcsolódó adatok.
A forrás táblázata szerint a felhasznált példák száma összesen 37 840. A MultiNLI 5000, a BoolQ 3000, a Banking77 3000, az AG News 1500, az SST-5 2000, a programozott szabályok 13 500, az útválasztási szabályok 6000, a kutatási taxonómia pedig 3840 példával szerepel. A bejegyzés egy későbbi mondata 38 340 példát említ, ami eltér a táblázat összegétől.
A Together AI szerint a kisebb adathalmaz használata nagyjából 17 dollárba kerül, miközben a nagyobb adathalmazok tanítása drágább és hosszabb ideig tart.
A teljes folyamat a GitHubtól az API-végpontig tart
A vállalat útmutatója a tev1 GitHub-adattár klónozásával kezdődik. A függőségek telepítése után a felhasználónak egy környezeti változókat tartalmazó .env fájlt kell létrehoznia, benne a Together API-kulcsával.
A mellékelt Python-szkriptek letöltik, mintavételezik és egységesítik az adathalmazokat. Ezután a Together AI finomhangolási szolgáltatásán elindítható a tanítás. A bejegyzés szerint a folyamat körülbelül 25 percet vesz igénybe. A tanítás állapota parancssorból vagy a Together AI finomhangolási irányítópultján ellenőrizhető.
A kész modellt dedikált végponton lehet futtatni. A Together AI példája egy NVIDIA H100 80 GB SXM gyorsítót használó végpont létrehozását mutatja be, egyetlen replikával. A modell ezután HTTP-kiszolgálón keresztül érhető el, így szoftverekbe is integrálható.
A kész modell JSON-formátumban válaszol
A finomhangolás során JSON-alapú bemenetet és kimenetet használnak. A bemenetben az állapotleírás, a kérdés, valamint a válaszlehetőségek címkéje, kulcsa és leírása szerepel. A Together AI által közölt példában a modell a duplicate_charge kulcsot és az A címkét adja vissza.
A GitHub-adattár további példákat is tartalmaz szándékfelismeréshez, igen vagy nem típusú szövegértéshez, logikai szabályok ellenőrzéséhez és hangulatelemzéshez. Aki nem szeretné saját maga betanítani a modellt, a Together AI szerver nélküli platformján közvetlenül kipróbálhatja a together/Tev1-4B-experimental modellt.
Together AI: How to train your own Jev for $17