A Sokobanban tanul tervezni az RNN, és gondolkodás közben köröz
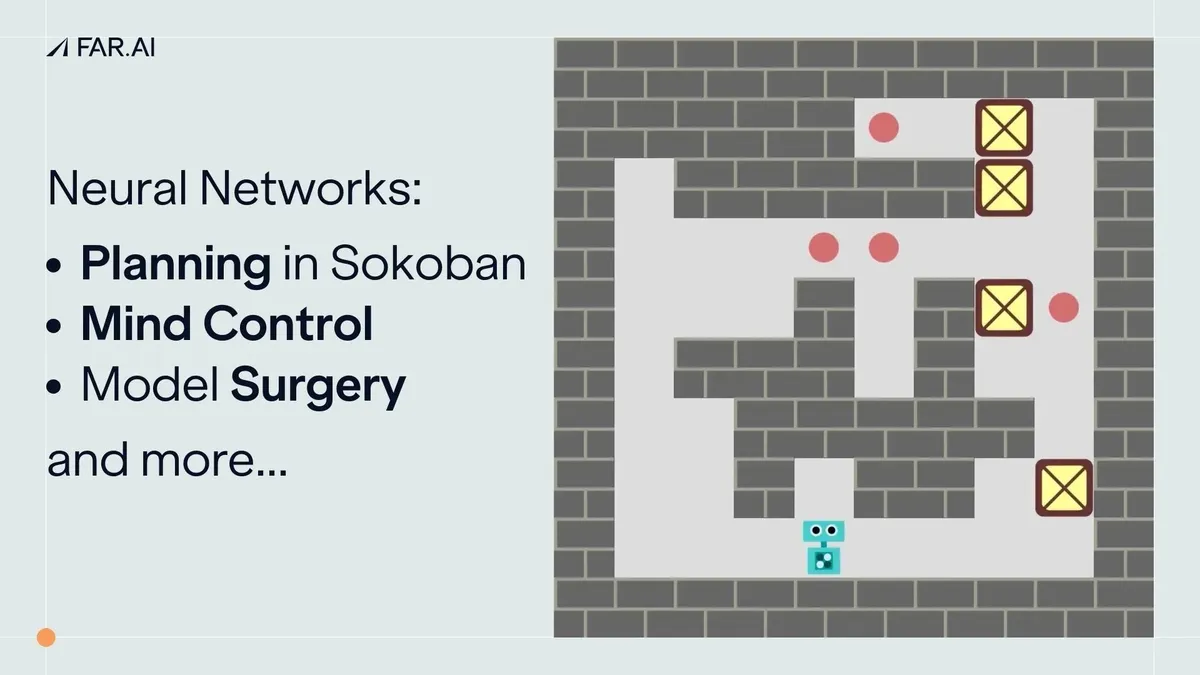
A FAR.AI kutatói egy Sokobant játszó visszatérő neurális hálózatnál azt figyelték meg, hogy több gondolkodási lépéssel hatékonyabban tervez, és nehezebb pályákat is megold. Az ügynök olykor a pálya elején körözni kezdett, mintha időt nyerne a megoldás kiszámításához.
- A DRC-modell extra gondolkodási lépésekkel nehezebb Sokoban-pályákat is megoldott.
- A teljesítmény 6 gondolkodási lépésig javult, utána stagnált vagy kissé visszaesett.
- A hálózat köröző mozgással nyert időt a tervezéshez.
- A köröző ciklusok 82,39 százaléka eltűnt extra gondolkodási idővel.
- A kutatás az AI-tervezés és az AI-biztonság értelmezését is segítheti.
A plusz gondolkodási idő javította a teljesítményt
A kutatás egy 1,28 millió paraméteres, Deep Repeating ConvLSTM, röviden DRC architektúrájú visszatérő neurális hálózat viselkedését vizsgálta. A modellt megerősítéses tanulással tanították Sokoban-pályák megoldására, a Boxoban adathalmaz különböző nehézségű pályáin.
A hálózat 10x10 képpontos RGB-képeket kapott bemenetként, a tanításhoz pedig az IMPALA algoritmust használták. Az ügynök jutalmat kapott, amikor egy dobozt célmezőre tolt, minden lépésért pedig kis büntetés járt. A modell 2 milliárd környezeti lépés alatt tanult meg egyre hatékonyabban előre gondolkodni.
A FAR.AI eredményei megerősítették a Guez és szerzőtársai által 2019-ben közölt megfigyeléseket. A DRC-modellnek adott extra gondolkodási lépések javították a megoldási arányt, különösen az összetettebb pályákon. A teljesítmény legfeljebb 6 gondolkodási lépésig nőtt, ezután stagnált vagy kissé visszaesett.
A körözés segített elkerülni a rossz döntéseket
Extra gondolkodási idő nélkül az ügynök bizonyos helyzetekben olyan pozícióba zárta magát, amelyből már nem lehetett megoldani a pályát. Több gondolkodási lépéssel viszont sikerült elkerülnie az olyan rövid távon jónak tűnő akciókat, amelyek később például egy doboz beragadásához vezettek.
A kutatók a dobozok elhelyezésének sorrendjét is elemezték. Azokon a pályákon, amelyeket az ügynök 6 gondolkodási lépéssel, de nulla lépéssel nem tudott megoldani, az első három doboz elhelyezése tovább tartott. A negyedik doboz célba juttatása ugyanakkor gyorsabb volt. Ez arra utal, hogy a modell a korai lépésekben feláldozta az azonnali haladást a későbbi, jobb megoldás érdekében.
Az ügynök időnként köröző mozgást is végzett a pályán. Amikor a hálózatot arra késztették, hogy a ciklus megkezdése előtt ugyanannyi gondolkodási lépést hajtson végre, a ciklusok 82,39 százaléka eltűnt. A kutatók szerint ez alátámasztja, hogy a körözés a terv kialakítását szolgálta.
A kutatás az AI-biztonság számára is fontos lehet
A DRC-modell a vizsgálatban egy nem visszatérő ResNet-alapot is felülmúlt, miközben a ResNet több mint kétszer annyi paraméterrel rendelkezett. A FAR.AI szerint ez azt mutatja, hogy a visszatérő felépítés és az extra gondolkodási idő hasznos lehet a tervezési feladatokban.
A hálózat belső tervezési folyamatának pontos részletei azonban továbbra sem ismertek. A kutatók ezért nyílt forráskódúvá tették a betanított ügynököket és a korábbi eredményeket reprodukáló kódot, hogy más értelmezhetőségi kutatók is tanulmányozhassák ezeket a tervezést vizsgáló modellrendszereket.
A FAR.AI a jelenséget a mesa-optimalizálók problémájával is összekapcsolja. Ezek olyan hálózatok, amelyek a tanítás során a kívánt céltól eltérő belső célokat alakíthatnak ki. A kutatócsoport szerint a Sokoban-kísérlet segíthet annak megértésében, hogyan jelenik meg a tervezés a mély neurális hálózatokban, és hosszabb távon hozzájárulhat a tervezési folyamatok automatikus felismeréséhez, vizsgálatához és az emberi értékekhez való igazításához.