A szuperemberi Go-programokat is egyszerű trükkökkel lehet megverni
Egy automatikus támadási módszerrel a kutatók rendszeresen legyőzték a szuperemberi szintű Go-programokat. A kísérletek szerint a KataGo és más erős rendszerek bizonyos, ritkán előforduló állásokban súlyos vakfoltokat mutatnak.
- A támadó AI 100 játszmából 94-ben legyőzte a KataGo vizsgált változatát.
- A támadás a KataGo betanításához szükséges számítási kapacitás 8 százalékával is működött.
- A kutatók két kihasználási módot találtak, a korai passzolást és az elfogható körkörös csoport létrehozását.
- Hasonló vakfoltot mutatott az ELF OpenGo, a Leela Zero és a Fine Art is.
- A kutatás szerint a szuperemberi teljesítmény nem garantálja az AI-rendszerek robusztusságát.
A gépek fölénye egy egyszerű stratégián bukott el
2016 márciusában az AlphaGo négy győzelemmel egy ellenében legyőzte a Go-világbajnok Lee Sedolt. A gépek ezzel szuperemberi szintre jutottak ebben a játékban, és a Go-programok azóta tovább erősödtek. Lee Sedol korábban úgy fogalmazott, hogy az AlphaGo „legyőzhetetlen entitás”.
2022-ben azonban Kellin Pelrine amatőr Go-játékos legyőzte a KataGo nevű programot, amely a forrás szerint még az AlphaGo-nál is erősebb. A FAR.AI kutatói most azt vizsgálták, hogyan lehet módszeresen megtalálni az ilyen rendszerek sérülékenységeit.
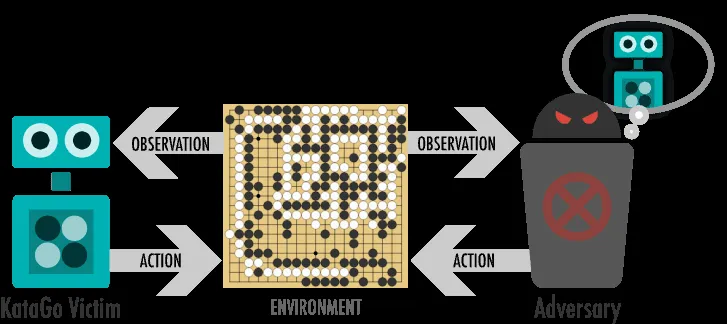
A kutatásban egy úgynevezett támadó mesterséges intelligenciát tanítottak arra, hogy legyőzze a vizsgált, áldozatnak nevezett rendszert. A támadó csak szabályos Go-lépéseket tehetett, és a KataGo által várhatóan választott lépésekből is mintát vehetett. Különleges hozzáférést a program belső működéséhez, például a súlyaihoz, nem kapott.
A KataGo 94 játszmát veszített százból
A támadó mesterséges intelligencia a KataGo szuperemberi változata ellen 100 játszmából 94-et megnyert. Ehhez a KataGo adott változatának betanításához felhasznált számítási kapacitás mindössze 8 százalékára volt szüksége.
A kutatók két különböző kihasználási módot találtak. Az egyikben a támadó ráveszi a KataGót, hogy idő előtt passzoljon. A másik során a programot egy olyan, nagy magabiztossággal kialakított körkörös csoport létrehozására ösztönzi, amely később elfogható.
A vizsgálat szerint a KataGo módszeresen rosszul értékeli a kölcsönösen összekapcsolódó, nagy kőcsoportokat. Hasonló vakfoltot találtak más szuperemberi Go-botoknál is, köztük az ELF OpenGo, a Leela Zero és a Fine Art rendszereknél. Az ilyen állások ritkán jelennek meg emberi játszmákban, egyenes stratégia követésével azonban megbízhatóan előidézhetők. A stratégia annyira egyszerű, hogy a kutatók szerint egy ember is megtanulhatja, majd külső segítség nélkül legyőzheti vele ezeket a botokat.
A módszer a Go-n túl is figyelmeztető
A FAR.AI kutatói a támadó rendszert a Go-programok betanításánál is használt AlphaZero-szerű eljárással fejlesztették. A hagyományos önjátszás helyett a támadó egy rögzített KataGo-változat ellen játszott. A kutatók ezt „áldozat elleni játéknak” nevezték, és fokozatosan egyre erősebb KataGo-változatokat állítottak vele szembe.
A megközelítés alapja a Monte-Carlo-fás keresés, röviden MCTS. Ez a módszer lehetséges jövőbeli játékfolyamokat szimulál, miközben egy szabályzatot adó neurális hálózat segít a valószínűleg jó lépések kiválasztásában. A kutatók módosított változata, az Adversarial MCTS, a szimulált játékosnak megfelelő hálózatból mintázza a lépéseket.
A kutatás üzenete a Go-n kívüli rendszerekre is kiterjed. A forrás szerint képosztályozók és természetesnyelv-feldolgozó rendszerek szintén sebezhetők olyan, ember számára jelentéktelen módosításokkal, amelyek egy mesterséges intelligencia teljesítményét erősen lerontják. A nagyobb képesség önmagában nem garantálja, hogy egy rendszer ellenállóbb lesz az ilyen támadásokkal szemben.
Ez különösen nagy kockázatot jelenthet kritikus infrastruktúra működtetésénél vagy automatizált kereskedésnél, ahol a támadóknak érdekük lehet a hibák kihasználása. A probléma akkor is megjelenhet, amikor egy mesterséges intelligencia egy másik rendszert felügyel. A gyenge ellenálló képesség ilyenkor ahhoz vezethet, hogy a felügyelt rendszer hatékonyan, de a kívánt céltól eltérően teljesít, ezt nevezik jutalomfeltörésnek.