Az AI-védelem új támadásokat szülhet a Go-ban
A Go mesterséges intelligenciái a korábbi támadások kivédése után is sebezhetőek maradtak. A FAR.AI kutatói három védelmi módszert vizsgáltak, és mindegyik esetében új, minőségileg eltérő támadási stratégiákat találtak.
- A FAR.AI három módszert vizsgált a Go-AI-k védelmére.
- Az ismert ciklikus támadás kivédése után új támadások jelentek meg.
- A KataGo egy új támadással 65 százalékos arányban volt legyőzhető 4096 látogatás mellett.
- A Vision Transformer sem szüntette meg a ciklikus támadásokkal szembeni sebezhetőséget.
- Az új támadások nehezebben megtalálhatók, de a védelem nem lett általános.
A szűk területen is nehéz a robusztusság
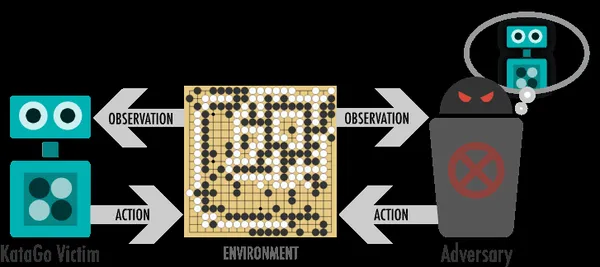
A FAR.AI kutatása azt vizsgálta, hogyan lehet ellenállóbbá tenni a Go-játékra épülő mesterséges intelligenciákat. A kérdés azért fontos a kutatók szerint, mert korábban még emberi amatőrök is képesek voltak legyőzni állítólag emberfeletti Go-AI-kat bizonyos, ciklikus mintákra épülő játékstratégiákkal.
A vizsgálat középpontjában a nyílt forráskódú KataGo állt. A rendszer a lehetséges lépéseket és válaszlépéseket Monte Carlo-fakereséssel, röviden MCTS-sel vizsgálja, miközben egy neurális hálózat javasol lépéseket és értékeli a játékállásokat. A hálózat önjátékkal tanul, vagyis az AI saját maga ellen játszva fejleszti a döntéshozatalát.
A teljesítményt a keresés során kiértékelt lépések száma, a visit count is befolyásolja. A magasabb érték általában erősebb játékhoz vezet, a kutatók szerint azonban ez önmagában nem szünteti meg az algoritmikus vakfoltokat kihasználó támadások veszélyét.
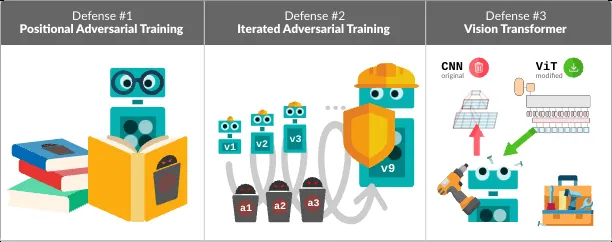
Három védekezési módszert teszteltek
Az első módszer a pozícióalapú ellenséges tanítás volt. Ennek során a fejlesztők kézzel kiválasztott, korábban problémás játékállásokat építettek be a tanítási adatokba. Ez megvédte a rendszert az eredeti ciklikus támadástól, a kutatók azonban új támadót tanítottak, amely a 2023 decemberében elérhető legfrissebb KataGo-modellt is legyőzte.
Az új támadó 65 százalékos győzelmi arányt ért el a 4096 látogatással játszó KataGo ellen, és 27 százalékosat 65 536 látogatás mellett. A kutatók egy nem ciklikus sebezhetőséget is azonosítottak, amelyet „gift attacknek”, vagyis ajándéktámadásnak neveztek el. Ebben a KataGo két követ kínál fel az ellenfélnek, majd a szuperko szabály miatt nem tudja azokat visszaütni.
A második megközelítés az ismételt ellenséges tanítás volt. A folyamatban egy támadót képeznek ki a jelenlegi modell legyőzésére, majd a modellt az új támadás kivédésére finomhangolják. A módszer megvédte az egyes modelleket a korábban látott támadóktól, az ismeretlen stratégiák ellen azonban nem terjedt ki a robusztusság. A v9 jelű modell 65 536 látogatás mellett is az esetek 42 százalékában kikapott az új a9 támadótól.
Harmadikként a kutatók konvolúciós neurális hálózatok helyett Vision Transformert alkalmaztak. A feltételezés szerint a teljes képet egyszerre feldolgozó ViT jobban kezelheti a lokális látómezőnél nagyobb ciklikus mintákat. A szuperemberi szintre tanított új modell azonban alacsony látogatásszám mellett továbbra is sebezhető maradt, és az ellenséges finomhangolás után magasabb értékeknél is legyőzhető volt.
A védekezés csak nehezebbé tette a támadást
A kutatók több új támadási mintát találtak. Az egyik, „atari attack” néven leírt módszer sok olyan követ és csoportot hagy, amelyek a következő lépésben leüthetők. Emellett úgynevezett bambuszkapcsolatokat használ, amelyek normál játékban általában erős alakzatnak számítanak, a támadó azonban a KataGo ellen egy nagy ciklikus csoport kialakítására fordítja őket.
A FAR.AI eredményei szerint a vizsgált ellenvédelmi eljárások kivédték a korábban ismert támadásokat, de nem adtak általános védelmet az új stratégiákkal szemben. Az új támadások megtalálása nehezebb volt, és az ellenfélnek több tanítási számítási erőforrásra volt szüksége, mint egy védelem nélküli KataGo esetében.
A kutatók szerint ez arra utal, hogy a probléma nem kizárólag egy adott neurális hálózati architektúrához kötődik. A sebezhetőség mögött a Go stratégiai dinamikája és az önjátékos tanítás is szerepet játszhat, amely kiszámítható mintákat erősíthet meg. A megállapítás azért lényeges, mert az ilyen jellegű robusztussági problémák a kutatók szerint az AI-rendszerek szélesebb körű, kritikus infrastruktúrában vagy nagy léptékű alkalmazásokban történő használatakor is kihívást jelenthetnek.