Titkosítással védené az AI-tesztek és modellek integritását az MLCommons
Első alkalommal teszteltek kettős vak módszerrel zárt súlyú AI-modellt úgy, hogy a folyamatban részt vevő felek ne férjenek hozzá egymás érzékeny adataihoz. Az MLCommons szerint a megközelítés megbízhatóbb alapot adhat a célzott AI-értékelésekhez.
- Első alkalommal értékeltek kettős vak módszerrel zárt súlyú AI-modellt.
- A tesztben a Google DeepMind, az OpenMined, az AVERI és az MLCommons vett részt.
- Az AILuminate fenntartott promptjai korábban nem voltak kitéve a vizsgált modellnek.
- A módszer védi a tesztadatokat és a modell súlyait a résztvevő felek előtt.
- Az MLCommons egészségügyi informatikai adatokkal is fejleszt hasonló TEE-alapú értékeléseket.
A titkosság önmagában nem elég
Az AI-rendszereket használó vállalatok, például a bankok, azt szeretnék tudni, hogy egy adott rendszer megbízhatóan és biztonságosan működik-e a saját felhasználási esetükben és adataikkal. Egy ilyen vizsgálat azonban több szereplő érzékeny információit érinti. A bevezető vállalatoknak védeniük kell az adataikat, az AI-szolgáltatók, köztük a határmodell-fejlesztők pedig óvják a modell súlyait.
Az MLCommons 2026. augusztus 27-i közleménye szerint a tesztelőknek emellett azt is biztosítaniuk kell, hogy a vizsgált modellek ne tanulhassanak a benchmarkokból, mert ez veszélyeztetné a mérések hitelességét. A szervezet hangsúlyozza, hogy maga az értékelés titkossága nem elegendő. Hosszú távon benchmarkkezelési programra is szükség van az integritás fenntartásához.
Kettős vak próba a Google DeepMind modelljével
Az MLCommons ezért vett részt a Google DeepMinddal, az OpenMineddel és az AVERI-vel közös bizonyítási célú projektben. A kezdeményezés az MLCommons szerint az első kettős vak értékelés volt egy zárt súlyú modell esetében. A módszer kialakítása úgy védi a résztvevőket, hogy nem kizárólag jogi szerződésekre támaszkodik.
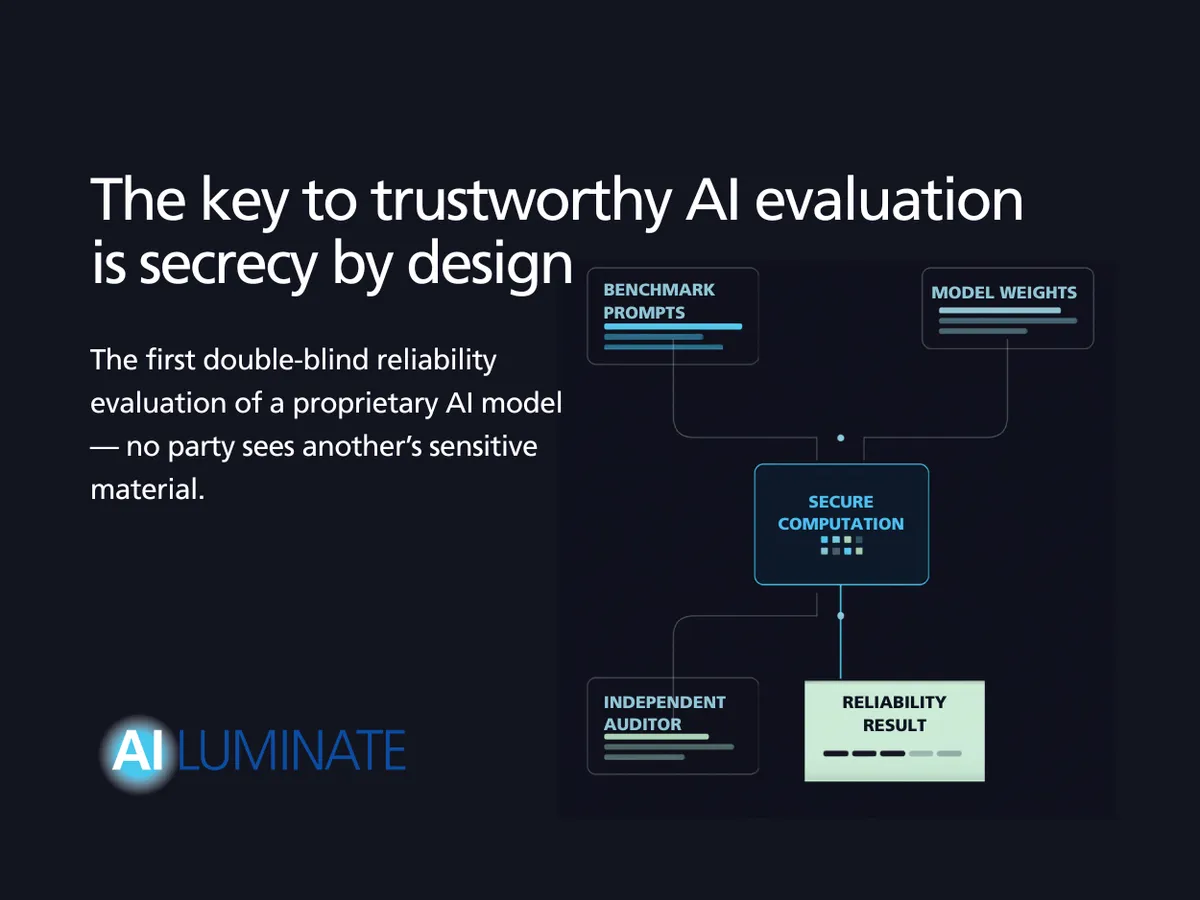
A projektben az MLCommons az AILuminate biztonsági benchmark fenntartott promptkészletét adta át. A szervezet közlése szerint ezt a konkrét értékelési készletet korábban egyetlen Google DeepMind-modell sem látta. Az AVERI az OpenMined biztonságos számítási technológiájával, konténerizált környezetben futtatta a promptokat egy Google DeepMind-modellen.
Az eljárás kriptográfiailag igazolható védelmet biztosított a modell súlyai és az értékelés számára. Az AILuminate így az MLCommons szerint úgy tudta jellemezni az AI-rendszer megbízhatóságát, hogy a tesztadatok nem kerültek a fejlesztőhöz, a fejlesztő tulajdonában álló modell súlyai pedig nem váltak hozzáférhetővé sem az MLCommons, sem az auditor AVERI számára.
Egészségügyi adatokkal is dolgoznak
Az MLCommons ezt a megközelítést olyan tesztelés felé vezető útnak tekinti, amely védi a szellemi tulajdont, és ellenáll annak, hogy a modellek idővel telítődjenek vagy alkalmazkodjanak a benchmarkokhoz. A szervezet szerint az ilyen, célzott AI-vizsgálatoknál fontos, hogy a tesztkészletet egy független szervezet korábban nem látott promptjai adják.
A közlemény szerint az MLCommons már a legérzékenyebb adatok egyik típusán, egészségügyi informatikai adatokon is dolgozik hasonló elven. MedPerf programjukban megbízható végrehajtási környezeteket, vagyis TEE-ket építenek. Ezek lehetővé teszik, hogy több résztvevő titkosított adatokat hozzon össze egy helyen, magas integritású értékelést futtasson, majd eredményt kapjon anélkül, hogy hozzáférne a többi fél érzékeny információihoz.
Az MLCommons célja, hogy az AI-rendszerek bevezetői a közeljövőben gyorsan és egyszerűen végezhessenek megbízható, saját felhasználási céljukra szabott értékeléseket. A szervezet a szakembereket, kutatókat és bevezető vállalatokat arra kéri, hogy tekintsék át a technikai részleteket, és ismerkedjenek meg az AILuminate keretrendszerrel, valamint a Benchmark Stewardship Programmal.
MLCommons: The key to trustworthy AI evaluation is secrecy by design