A videómodellek még látványosan elbuknak a fizika alapjain
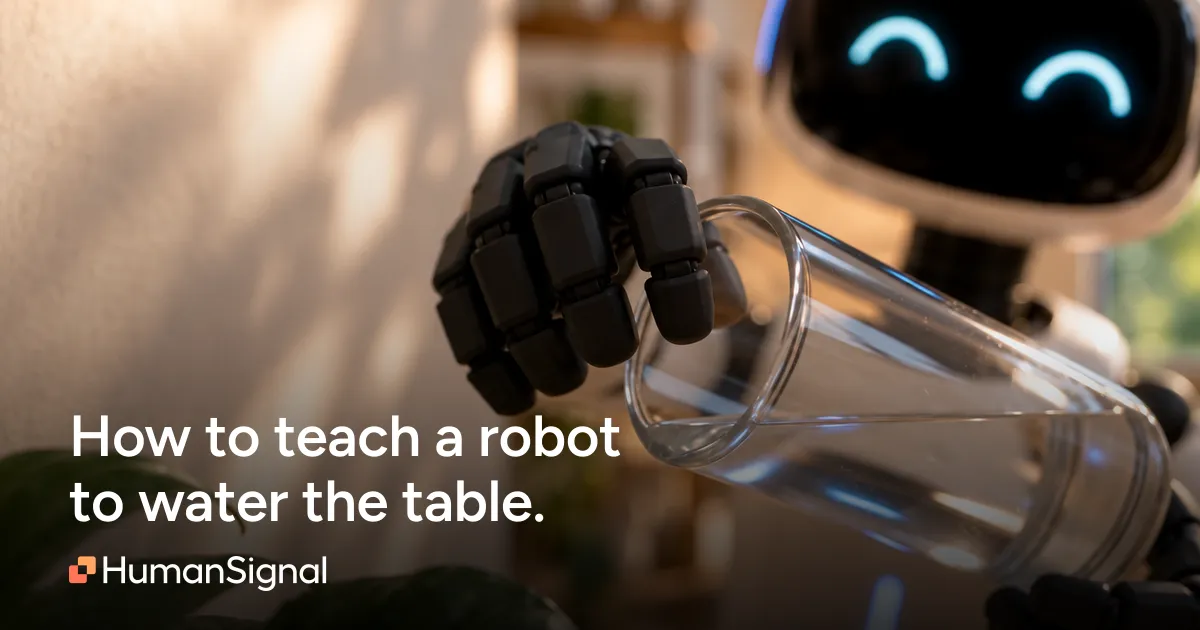
A modern videómodellek meggyőző képkockákat készítenek, de ez nem jelenti azt, hogy következetesen értik a háromdimenziós világot. A HumanSignal kísérletei szerint a folyadékok mozgása, a térbeli viszonyok és a mechanikai szerkezetek továbbra is komoly problémát jelentenek.
- A videómodellek meggyőző képeket készítenek, de a fizikai következetességgel gyakran gondjuk van.
- A HumanSignal reklámkísérletében a szándékosan hihető kudarc bizonyult a legnehezebb feladatnak.
- A Seedance 2.5 stabilan tartotta a robot megjelenését a jelenetek között.
- A Seedance 2.5, a Veo 3.1 és a Kling 3.0 Pro hibázott a víz átöntésének modellezésében.
- Az Armatron-kísérletben a modellek a kívánt célt követték, de eltorzították a robotkar mechanikáját.
Egy reklám, amelynek a kudarctól kellett volna működnie
A HumanSignal szeptember 23-án közzétett beszámolója egy olyan reklámötletből indult ki, amelyben egy háztartási robot első pillantásra sikeresen teljesíti a feladatát. A kamera elfordulásakor azonban kiderül, hogy a robot valójában éppen csak elvéti a célt. Az egyik jelenetben egy növényt öntöz, de a vízsugár teljesen elkerüli a cserepet. Egy másikban kávékkal teli tálcát visz, és egy üvegajtónak sétál neki.
A körülbelül 20 másodperces reklámok elkészítése közben a cég arra jutott, hogy a kameramozgás, a szándékosan elrontott feladat és a folyadékok viselkedése együtt túl nagy kihívást jelent a jelenlegi videómodelleknek. A cég ezt a problémát „failure choreography”, vagyis a kudarc megtervezéseként kezdte emlegetni.
A robot következetes maradt, a fizika nem
A HumanSignal eredetileg attól tartott, hogy a robot külseje és arányai változnak majd az egyes felvételek között. Ehhez több nézetből álló karakterreferenciát készítettek, a környezet stabilizálásához pedig a szobáról is több képet adtak meg a modellnek. A beszámoló szerint a Seedance 2.5 ugyanazt az arcot, testarányokat és ízületi kialakítást tartotta meg a reklám jeleneteiben.
A nehézséget így nem a szereplő állandósága, hanem maga a poén okozta. A modell hajlamos volt a feladatot a megszokott, sikeres módon teljesíteni. Egy robot, egy kancsó és egy növény láttán a víz általában oda került, ahová annak kerülnie kellene. A szándékos, hihető félresikerülés ezzel szembement.
A cég szerint ez a jelenet egyszerre tesztelte a szokatlan feladatvégrehajtást, a térbeli következetességet és a folyadékdinamikát. A kamera elfordulásakor a teljes jelenetnek koherensnek kellett volna maradnia, miközben a vízsugárnak éppen a megfelelő helyet kellett volna elvétenie.
Három modell, két fizikai próba
A HumanSignal azonos kezdőképet és csak a végrehajtandó műveletet leíró utasítást adott három videómodellnek: a ByteDance Seedance 2.5 modelljének, a Google DeepMind Veo 3.1-nek és a Kuaishou Kling 3.0 Pro modelljének. A következményeket, például a vízszint csökkenését, nem írták le külön, így azokat a modelleknek kellett kikövetkeztetniük.
Az első kísérletben egy teli korsóból kellett a víz körülbelül 60 százalékát egy üres pohárba önteni. Mindhárom modell hibázott, eltérő módokon. A közös probléma a víz mennyiségének átvitele volt, a látható vízszintek nem változtak az elvárható módon. A HumanSignal szerint a Kling 3.0 Pro eredménye különösen jól mutatta a különbséget a látványos megjelenítés és a tényleges megértés között: az öntés hihetőnek látszott, a jelenet végén azonban lényegében két pohárnyi víz jelent meg.
A második tesztben egy Radio Shack Armatron játékrobot-karnak kellett felvennie egy kék labdát, majd egy műanyag pohárba ejtenie. A modellek többnyire a megfelelő cél felé haladtak, közben azonban megváltoztatták a szerkezet mechanikáját. A csukló és a kar geometriája eltorzult, két modell pedig úgy oldotta meg a feladatot, mintha az egész játékrobot közelebb ugrott volna a pohárhoz.
A meggyőző kép nem azonos a világ megértésével
A HumanSignal a videómodellek két eltérő képességét választja szét. A realizmushoz tartozik a textúrák, a fények és a mozgáselmosódás hiteles megjelenítése. A világ megértése viszont tartós objektumokat, állandó mennyiségeket és következetes geometriát feltételez.
A beszámoló szerint egy modell képes lehet meggyőző képpontokat előállítani úgy, hogy közben megkettőzi a vizet, vagy olyan ízületet hajlít meg, amely valójában nem létezik. A HumanSignal által idézett Physics-IQ és VideoPhy-2 kutatások szintén hiányosságokat találtak a fizikai alapelvek és a fizikai józan ész kezelésében. A cég három kísérlete alapján a videómodellek 2026 végén még látványosan dolgoznak a fizika következetes megjelenítésén.
HumanSignal (Label Studio): Teaching a video model to fail convincingly