Vízjelet kapott a vLLM szöveggenerálása, így ellenőrizhető lehet az eredet
A vLLM olyan szöveges vízjelezési módszert mutatott be, amely a nyelvi modellek generálásának véletlenszerűségét használja az eredet jelezésére. A megoldás a szolgáltatás sebességét és a modell kimeneti eloszlásának megőrzését is figyelembe veszi.
- A vLLM szöveges vízjelezése a generálás véletlenszerűségére épül.
- A módszer titkos kulccsal és alapértelmezés szerint 4 tokenes kontextussal dolgozik.
- Az ellenőrzéshez nincs szükség a modell súlyaira vagy logitjaira.
- A felismerés hosszabb, nagyobb entrópiájú szövegeknél erősebb.
- Kalibrált tesztnél a vízjel nélküli szövegek körülbelül 1 százaléka lehet téves pozitív.
Miért nehéz szöveget vízjelezni?
A digitális tartalmak eredetének ellenőrzése fontos a megosztott információk iránti bizalom és az elszámoltathatóság szempontjából. Képeknél és hanganyagoknál a vízjel finom módosításként kerülhet a tartalomba, a szöveg esetében azonban ez a módszer nem alkalmazható közvetlenül, mivel a szöveg diszkrét természetű.
A vLLM szerint egy használható szöveges vízjelnek több, egymással feszültségben álló követelménynek kell megfelelnie. Nem torzíthatja rendszeresen a modell válaszait, például bizonyos szavak, stílusok vagy megoldások előnyben részesítésével. A jelnek lehetőleg szerkesztés, rövidítés, más korpuszokkal való keverés vagy egy másik nagy nyelvi modell általi átfogalmazás után is fenn kell maradnia. Emellett a vízjelezésnek kevés késleltetést és memóriahasználatot kell hozzáadnia a generáláshoz és az ellenőrzéshez.
A korábbi megközelítések között vannak olyanok, amelyek módosíthatják a kimeneti eloszlást, könnyen eltávolíthatók, vagy nehezen illeszthetők be hatékonyan a következtetésbe. A vLLM ezért a nyelvi modellek generálásának egyik természetes tulajdonságára, a véletlenszerűségre épít.
A vízjel a tokenválasztásban jelenik meg
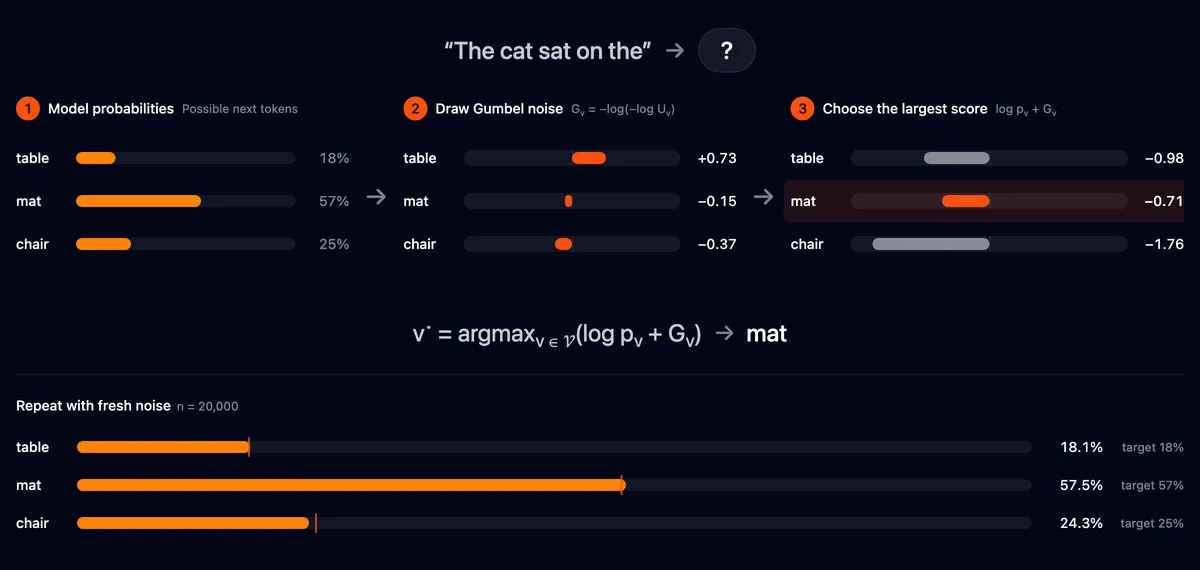
A modell minden generálási lépésben valószínűséget rendel a következő tokenekhez, majd ezek közül választ. A vLLM megoldása a szokásos, új véletlenértékeket használó mintavétel helyett a legutóbbi kontextusból és minden jelölt tokenből reprodukálható, kulcsolt értékeket számít. Alapértelmezés szerint a legutóbbi 4 token kerül a vízjelezési kontextusba.
A rendszer egy titkos kulcsot, a kontextust és a tokenazonosítót használja pszeudovéletlen függvény bemeneteként. Ezután a tokenek logaritmikus valószínűségeihez Gumbel-zajt ad, és a legnagyobb értékű jelöltet választja. A Gumbel-max trükk lényege, hogy az így kapott mintavétel ugyanazt a kategorikus eloszlást adja, mint a hagyományos véletlen mintavétel. A vLLM szerint a kulcsok feletti várható értékben ezért a tokenválasztás valószínűsége pontosan változatlan marad.
A teljes sorozatok esetében ez önmagában még nem garantálja a torzításmentességet, a forrás szerint a megoldás ezt a korlátot külön is tárgyalja. A bemutatott Qwen3.5-27B összehasonlításban a vízjelezett és vízjel nélküli eredmények hibasávjai átfedtek. A GSM8K eredménye 93,0, illetve 94,2 százalék, az MBPP-é 79,2, illetve 77,2 százalék, az IFEvalé pedig 90,7, illetve 91,9 százalék volt.
Kulcs kell az ellenőrzéshez
A vízjel felismeréséhez nincs szükség a modell súlyaira vagy logitjaira, de kell a titkos kulcs és a tokenizer. Az ellenőrző a szöveget tokenazonosítókká alakítja, majd minden tokennél újraszámolja a megelőző kontextushoz tartozó pszeudovéletlen értéket.
Vízjel nélküli szövegben a tokenek és a kulcsolt értékek függetlenek egymástól. Vízjelezett generálásnál viszont a választott tokenek gyakrabban igazodnak a nagyobb értékekhez. Az ellenőrző tokenenként pontszámot számít, ezeket összeadja, majd egy p-értékkel becsüli meg, milyen valószínű, hogy vízjel nélküli szöveg véletlenül legalább ilyen erős jelet adna.
A küszöb megválasztása a téves pozitív és téves negatív találatok arányát szabályozza. Kalibrált tesztnél a rendszer a vízjel nélküli szövegek körülbelül 1 százalékát jelöli pozitívként. Ha több kulcsot, tokenizálót vagy vízjelezési beállítást vizsgálnak, többszörös tesztelési korrekcióra van szükség, ami csökkenti a felismerés erejét.
A jel hosszabb szövegeknél erősödik, és a nagyobb entrópiájú generálási lépések több lehetőséget adnak a vízjel hatására. A rövid vagy kiszámítható szövegek ezért gyengébb jelet adnak. Egy kellően hosszú szöveg kimásolása megőrzi a bizonyítékot, a módosított tokenek környezetében viszont romlik a pontszám. A jel a forrás szerint később ismét megmaradhat, amikor a módosított tokenek kikerülnek a következő tokenek friss kontextusából.
vLLM: Watermarking in vLLM