A vLLM 5000 tokent ért el GPU-nként a Qwen3.8-2.4T kiszolgálásában
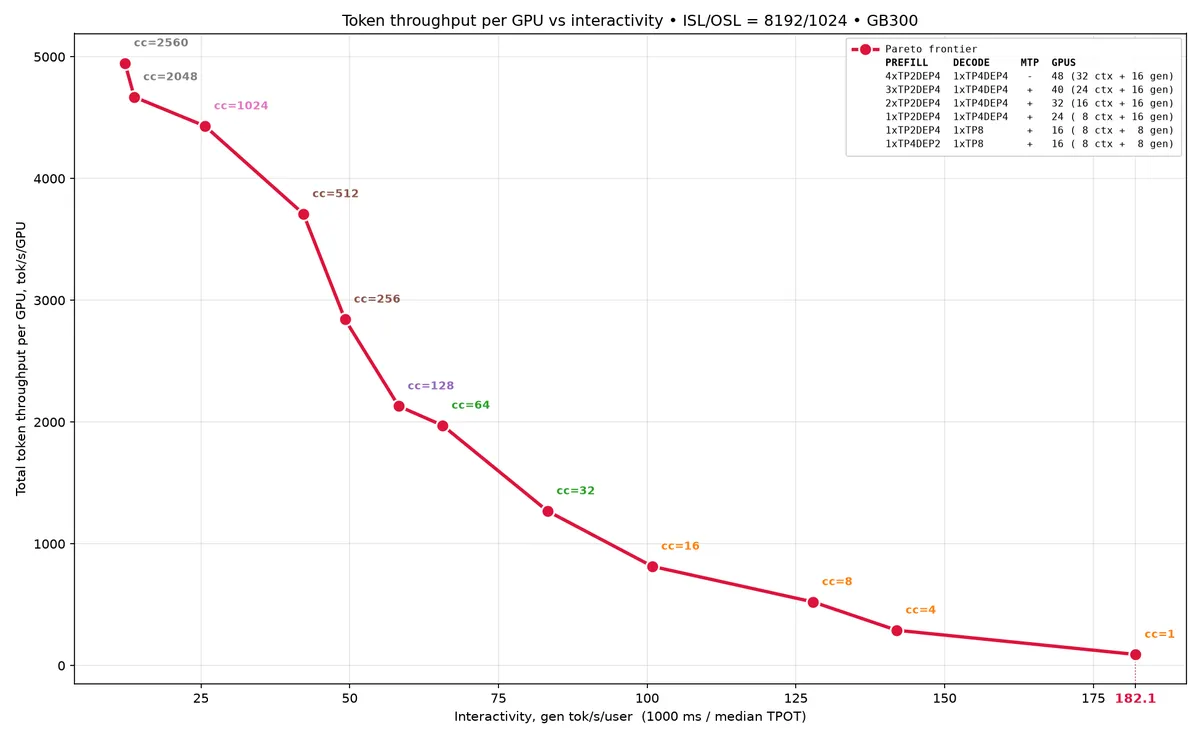
A vLLM közzétette a Qwen3.8-2.4T modell szétválasztott előfeldolgozás és dekódolás alapú kiszolgálásának eredményeit. A GB300 NVL72 fürtön végzett mérésben nagy áteresztés mellett GPU-nként 5000 összesített tokenes teljesítményt, alacsony késleltetésnél pedig felhasználónként 180 generált tokent értek el.
- A vLLM GB300 NVL72 fürtön tesztelte a Qwen3.8-2.4T PD serving kiszolgálását.
- Nagy áteresztés mellett GPU-nként 5000 összesített tokenes teljesítményt közöltek.
- Alacsony késleltetésnél 180 generált tokent értek el felhasználónként.
- A modell 92 réteget, 69 GDN- és 23 Full-Attn-réteget tartalmaz.
- A bejegyzés srt-slurm recepteket és a teljesítményhangolás módszerét is bemutatja.
Teljesítménymérés két eltérő célra
A vLLM szeptember 21-én ismertette a Qwen3.8-2.4T modellen végzett mérését. A vizsgálat 8K bemeneti és 1K kimeneti tokenből álló terhelést használt, amelyet a bejegyzés hosszú bemeneti szekvenciás, dekódolás-központú tesztforgatókönyvként ír le.
A vállalat két teljesítménycélt különített el. Nagy áteresztésű beállításban a teljes tokenátvitelt maximalizálták, ebben az esetben 5000 összesített token jutott egy GPU-ra. Az alacsony késleltetésű oldalon az interaktivitást, vagyis az egy felhasználóra jutó generált tokenek sebességét vizsgálták, itt 180 generált tokenes értéket közöltek felhasználónként. Az eredményeket pareto-frontierként, vagyis az áteresztés és a késleltetés közötti optimális kompromisszumokat bemutató görbeként ábrázolták.
A Qwen3.8-2.4T memóriaigénye
A bejegyzés szerint a Qwen3.8-2.4T 92 rétegből áll. Ezek közül 69 GDN-, 23 pedig teljes figyelmi, Full-Attn-réteg, és minden rétegben Mixture of Experts, vagyis MoE blokk található. A modell összesen 92 × 512 szakértőt használ. A GDN- és Full-Attn-részek BF16, a szakértői súlyok NVFP4 formátumban vannak.
A vLLM számítása szerint a modell 91 GiB nem szakértői súlyt és 1242 GiB szakértői súlyt tartalmaz. A memóriaigény meghatározásánál fontos különbség van a két rétegtípus között. A Full-Attn állapota tokenenként növekszik, míg a GDN állapota kérésenként tárolódik.
Egy token Full-Attn állapota rétegenként 2 KiB. A GDN állapotának két része van: a konvolúciós állapot 120 KiB, az SSM-állapot pedig 4 MiB. A teljes GDN-állapot így 4216 KiB kérésenként. A vLLM ezt blokkokban foglalja le, ezért a GDN-állapot határozza meg a blokk méretét. A számítás szerint egy blokk 2112 tokent, vagyis 4,125 MiB adatot tartalmaz.
A méréshez használt memóriafelosztás
A vLLM a maximális párhuzamosság becsléséhez először azt vizsgálta, mennyi memória marad a modell betöltése és a kiszolgáló egyéb foglalásai után. A GB300 279 GB-os memóriakapacitásából a meghajtóprogram 2,28 GiB-ot használ fel, így a vLLM indulásakor 276,62 GiB áll rendelkezésre. A CUDA-környezet ezt megelőzően további 3,13 GiB-ot foglal le.
A vLLM alapértelmezés szerint a 276,62 GiB-os kiindulási érték 8 százalékát tartalékolja a nehezen előre jelezhető fogyasztásra, például a csúcsterhelés alatti aktivációkra. Az NCCL-pufferek, a memóriaallokátor és más, PyTorchon kívüli elemek további 2,90 GiB-ot igényelnek. A súlyok betöltése előtt így 248 GiB marad a vLLM számítása szerint.
A közzétett tesztekben az egyes dekódoló motorok csúcsidejű aktivációigénye 0,56 és 2,24 GiB között alakult. A legnagyobb, 2,24 GiB-os értéket TP4DP4 topológiánál, 272-es maximális kérés- és 1104-es maximális kötegelt tokenbeállítás mellett mérték.
Reprodukálható beállítások a PD servinghez
A vLLM szerint a bejegyzés célja nem kizárólag a végső teljesítményszámok közlése. A projekt részletesen bemutatja, hogyan választották ki a mérendő paramétereket, hogyan azonosították a szűk keresztmetszeteket, és miként finomították a szétválasztott kiszolgálás, vagyis a prefill és a decode külön motoron futó konfigurációit.
A bejegyzés szerint a szerzők srt-slurm recepteket is közölnek, amelyekkel a mérések helyi kiszolgálással ellenőrizhetők és reprodukálhatók. Külön felhívják a figyelmet arra, hogy a prefill és a decode külön számítja ki a blokkméretet, a KV-gyorsítótár átviteléhez azonban a két oldalnak egyeznie kell. Eltérés esetén a --block-size paraméter kézi beállítását javasolják olyan értékre, amely mindkét oldalon elég nagy a GDN-állapot tárolásához, ez azonban a KV-gyorsítótár egy részének kihasználatlanul maradásával járhat.
A vLLM állítása szerint a lépésenként ismertetett munkafolyamat más modellek kiszolgálási teljesítményének hangolásához is felhasználható. A közölt eredmények ezért a Qwen3.8-2.4T konkrét számai mellett a memóriafoglalás és a PD-konfigurációk megtervezésének módszerét is megmutatják a felhasználóknak.
vLLM: PD Serving of Qwen3.8-2.4T