A vLLM a DeepSeek saját motorjának teljesítményét célozza meg
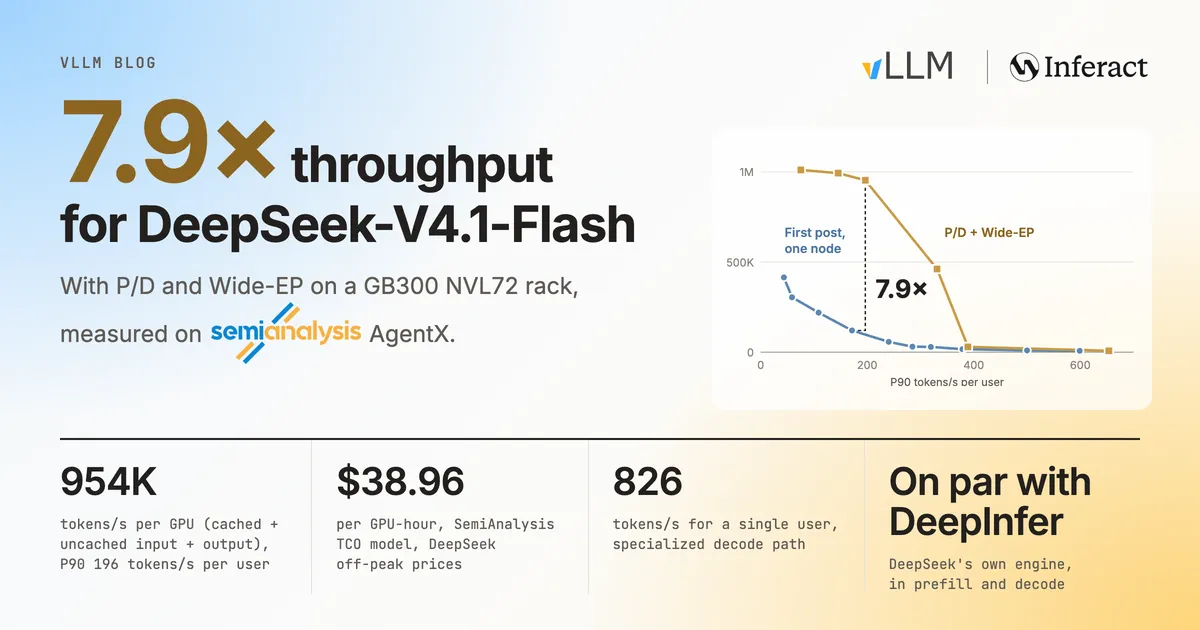
A vLLM szerint a DeepSeek-V4.1-Flash egy NVIDIA GB300 NVL72 racken, párhuzamos prefillinggel és dekódolással, GPU-nként 954 ezer token/másodperc sebességgel futtatható. A rendszer a DeepSeek saját DeepInfer motorjának dekódolási teljesítményétől a vizsgált terheléseken legfeljebb 6 százalékkal maradt el.
- A vLLM 954 ezer token/másodperc teljesítményt mért GPU-nként GB300 NVL72 rendszeren.
- A dekódolás 8 és 256 közötti kötegméreteknél 6 százalékon belül volt a DeepInfer eredményeihez képest.
- A hosszú kontextus csak mérsékelten növelte a célmodell dekódolási késleltetését.
- A vLLM méréseiben a DEP2 hatékonyabb prefillelést adott, mint a DEP4.
- Az SWA korlátozott visszajátszásának kiterjesztése 19,9 százalékos javulást hozott 32 ezer új tokennél.
A vLLM közel került a DeepSeek saját motorjához
A vLLM október 23-án közzétett teljesítményvizsgálata a DeepSeek-V4.1-Flash nagy léptékű kiszolgálását mutatja be. A mérésben a vLLM párhuzamos prefillinget és dekódolást, valamint Wide-EP eljárást használt egy NVIDIA GB300 NVL72 racken. A SemiAnalysis AgentX terhelésen így GPU-nként 954 ezer token/másodperc értéket mértek, felhasználónkénti 90. percentilisben 196 token/másodperc mellett.
A vLLM közlése szerint ez 7,9-szerese a korábbi, egyetlen csomóponton végzett mérésüknek. A bejegyzés 38,96 dolláros GPU-óránkénti költséget is megad a DeepSeek csúcsidőn kívüli áraival számolva. Egyetlen felhasználó esetén egy külön dekódolási útvonal 826 token/másodperc sebességet ért el.
A dekódolási eredmények 6 százalékon belül vannak
A legfontosabb összehasonlítási alap a DeepInfer, a DeepSeek DeepSeek-V4.1-Flashhoz kiadott, offline használatra szánt saját következtetési motorja. A vLLM GB200 rendszeren, 131 ezer tokenes kontextussal és nextn=3 beállítással mérte a dekódolást. A 8 és 256 közötti kötegméreteknél a vLLM teljesítménye a DeepInfer közzétett eredményeinek 6 százalékán belül volt.
A prefillelésnél a vLLM DEP2 beállítása GB300 hardveren követte a DeepInfer közzétett görbéjét. A két mérés konfigurációja eltért: a DeepInfer EP4DP4-et, 32 redundáns szakértőt és 140 tokenes korlátozott visszajátszást használt, míg a vLLM DEP2-t, redundáns szakértők nélkül, 128 tokenes visszajátszással. Emiatt a vLLM nem tekinti a görbék közötti különbséget közvetlen motorok közötti sebességelőnynek.
A két rendszer technológiai kapcsolatban áll egymással. A DeepInfer eredetileg vLLM-re épült, miközben a vLLM a DeepSeek által nyílt forráskódúvá tett MegaAttn, MegaMoE és Mega-mHC kerneleket is integrálta.
Miért működik a modell nagy kontextus mellett is?
A vLLM mérései szerint a DeepSeek-V4.1-Flash globális kulcsérték-gyorsítótára tokenenként 890 bájtot használ. Ezt a rétegek közötti KV-megosztás és az FP4 tömörítés teszi lehetővé. A modell több figyelmi rétege tömörítést alkalmaz, a 20. réteg pedig a teljes bemenethez ír globális KV-t, miközben a további számításokat csak az utolsó 128 tokenen végzi.
A dekódolás hosszú kontextusnál is elsősorban a kevert szakértői modell, vagyis az MoE oldalán terheli a rendszert. A vLLM DEP4 mérésében, 128 ezer tokenes kontextus és 64 kérés mellett, az MoE a lépés idejének 62 százalékát tette ki, míg a figyelem és az indexelő együtt 13 százalékot.
GB300-on DEP32 beállítással, 16 kérésenként és kérésenként hat tokennel, a kontextus 128 ezerről 855 ezer tokenre növelése csak 0,6 milliszekundummal, 7 százalékkal emelte a célmodell dekódolási késleltetését. A vLLM szerint ezek a tulajdonságok indokolják, hogy a prefilleléshez kisebb DEP-méretet, a dekódoláshoz pedig Wide-EP-t használjanak.
A kisebb DEP-méret előnyösebb a prefilleléshez
Az AgentX prefilleléses mérésében, 256-os konkurenciánál, a DEP4 GPU-nként 53,3 ezer token/másodpercet ért el, ami a DEP2 teljesítményének 83 százaléka volt. A vLLM szerint az eltérés mögött a DP-terhelés kiegyenlítetlensége állhat. Amikor a rangok eltérő időben kapták meg ugyanazokat a kéréseket, a DEP4 teljesítménye 13,6 százalékkal csökkent.
- DEP2, kiegyensúlyozott terhelés: 138,7 ezer token/másodperc.
- DEP2, kiegyensúlyozatlan terhelés: 130,5 ezer token/másodperc, 5,9 százalékos visszaesés.
- DEP4, kiegyensúlyozott terhelés: 267,6 ezer token/másodperc.
- DEP4, kiegyensúlyozatlan terhelés: 231,1 ezer token/másodperc, 13,6 százalékos visszaesés.
A vLLM további optimalizálásként kiterjesztette a korlátozott SWA-visszajátszást a 20. rétegre. A cég szerint ez 32 ezer új tokennél 19,9 százalékkal javította a prefillelés teljesítményét, a gyorsulás pedig 4 ezer tokennél mért 10,1 százalékról 64 ezer tokennél 23,1 százalékra nőtt.