Az AI-biztonságot a teljes rendszerben kell tesztelni
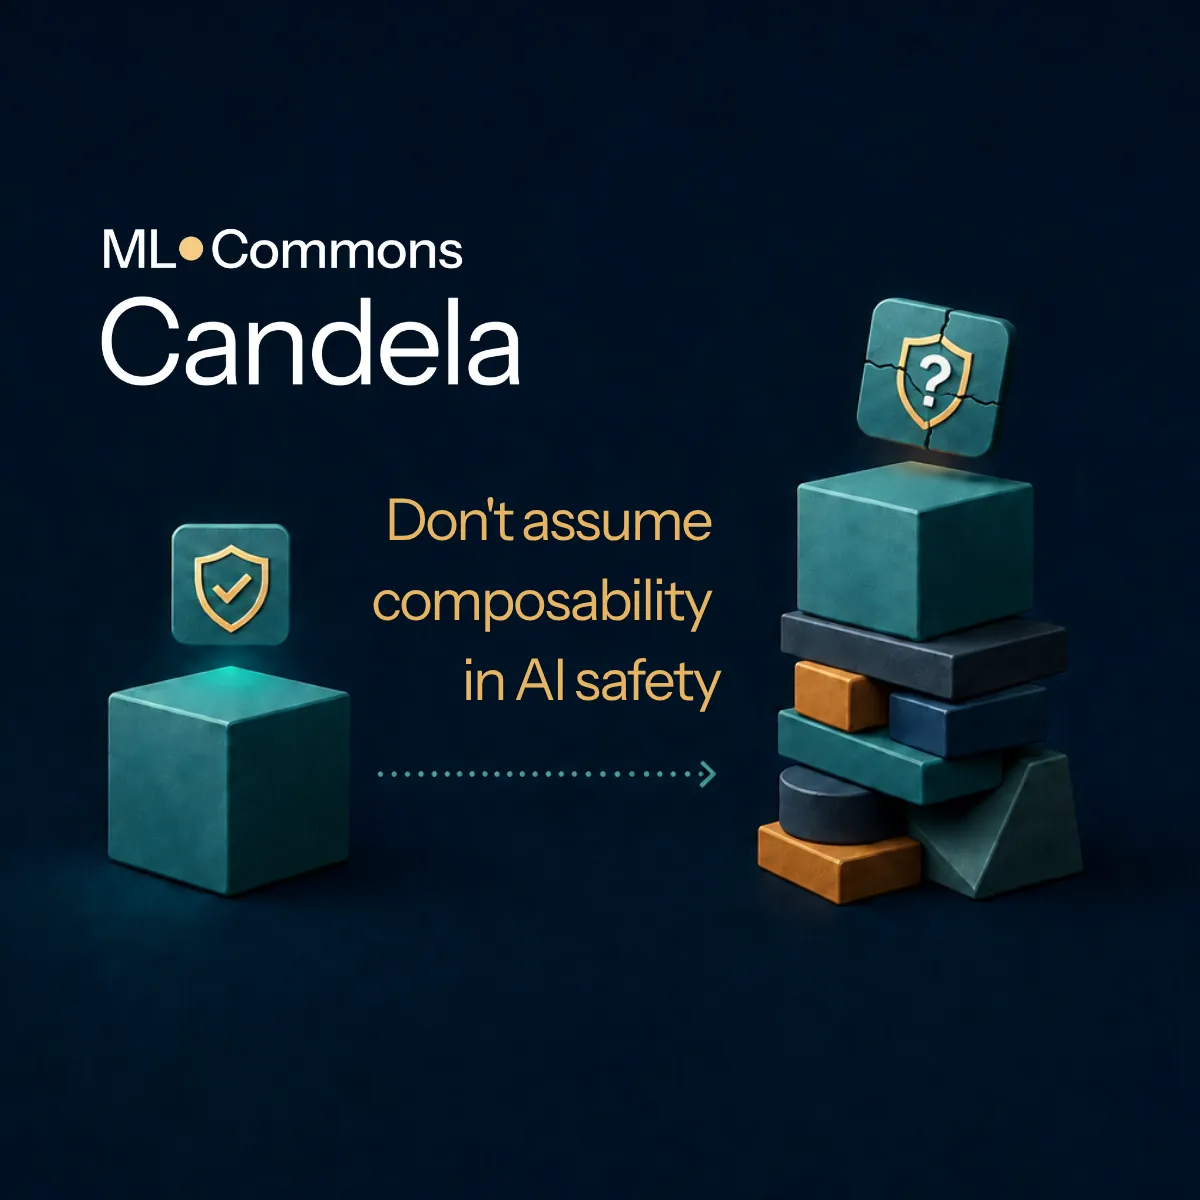
Az MLCommons szerint az AI-rendszerek biztonsága nem öröklődik automatikusan a bázismodelltől a telepített rendszerre. A szervezet ezért a teljes konfiguráció tesztelését sürgeti, beleértve a rendszerpromptot, a védelmi rétegeket, a visszakeresést, az eszközöket és a szűrőket.
- A telepített AI-rendszer biztonsági viselkedése eltérhet a bázismodellétől.
- A finomhangolás iránya és mértéke nem jelzi megbízhatóan a biztonsági változást.
- A Candela a teljes, élesben használt AI-konfigurációt teszteli.
- Az AILuminate következő kiadásai hibahatárokat is közölnek majd.
A bázismodell pontszáma nem elég
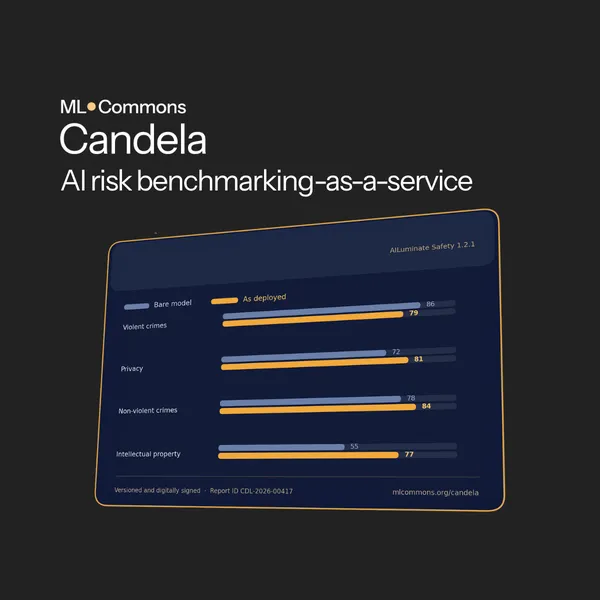
A telepített AI-rendszer másképp viselkedhet, mint az alapjául szolgáló modell. A viselkedés a rendszerprompt, a visszakeresési rétegek, a finomhangolás és más módosítások hatására is változhat. Az MLCommons szerint ennek ellenére a biztonsági értékelésekben gyakran a bázismodell rendszerkártyáján szereplő pontszámot használják a modellre épített teljes rendszer jellemzésére.
A szervezet ezt a problémát a rendszer összeállíthatóságának, angolul composabilitynek nevezi. A kérdés az, hogy egy korábbi rendszerre vagy modellre elvégzett értékelés eredménye mennyire vihető át egy másik környezetben működő, arra épülő konfigurációra. Az MLCommons szerint az AI-biztonságban a megfelelő tesztelés nélkül ez gyakran nem működik.
A módosítás iránya és mértéke sem jósolható meg
A CDT AI Governance Lab és az MIT Algorithmic Alignment Group nyilvánosan elérhető orvosi és jogi finomhangolásokat hasonlított össze a bázismodellekkel. Egyes finomhangolt modellek biztonságosabbnak bizonyultak, mások kevésbé biztonságosnak, és egyetlen finomhangolási döntés sem jelezte előre megbízhatóan, merre változik az eredmény.
A módosítás nagysága sem jelezte előre a biztonsági változás mértékét. Az MLCommons szerint bizonyos beavatkozások ronthatják a biztonságot, ugyanakkor az ellenkező irányú változásra is van példa. A nyílt súlyú modellekhez hozzáadott futásidejű védelmi korlátok általában javítják a biztonsági pontszámokat, de a javulás módja és mértéke megfelelő tesztelés nélkül nem állapítható meg megbízhatóan.
Az MLCommons teljes rendszereket mérne
Az MLCommons szerint a széles körben használt mérési eljárások egy része túl zajos ahhoz, hogy megbízhatóan lehessen összehasonlítani a telepítés előtti és utáni rendszereket, az időbeli változásokat vagy két különböző rendszert. Az eredményt befolyásolhatja például a kiválasztott tesztpromptok köre, a megfogalmazásuk és az értékelő személye vagy rendszere.
A szervezet új, Candela nevű benchmarking as a service szolgáltatása az AILuminate méréseit a vállalatok által élesben használt teljes összeállításon végzi. A teszt a bázismodell mellett a rendszerpromptot, a védelmi korlátokat, a visszakeresést, az eszközöket és a szűrőket is figyelembe veszi, privát módon, az ügyfél saját környezetében.
Az MLCommons közlése szerint az értékelő módosításai között szerepel az LLM-ek helyett osztályozók használata, valamint az Item Response Theory módszertana a benchmarkok tartalmának fejlesztéséhez. Az AILuminate Safety és Jailbreak következő, novemberi kiadásai hibahatárokat is közölnek majd, amelyek az értékelési folyamat változékonyságát veszik figyelembe.
Mit jelent ez a fejlesztőknek és az üzemeltetőknek?
Az MLCommons szerint a teljes rendszer összehasonlítható mérése segíthet megállapítani, hogy egy módosítás valóban megváltoztatta-e a biztonsági pontszámot, vagy csak a mérés zaját látjuk. Ha később azonosíthatóvá válnak azok a változtatások, amelyek megőrzik egy eredmény érvényességét, a csapatok eldönthetik, mely módosításokat telepítik további teszt nélkül, melyeket vetik alá gyors ellenőrzésnek, és melyekhez készítenek részletes jelentést.
A Candela már használható a rendszereiket telepítő csapatok számára. Az AI-értékelések mérési hibáival és az összeállíthatósággal foglalkozó kutatók az MLCommons AIRR Analytics Working Group munkájához csatlakozhatnak.