MLCommons: már saját AI-rendszereink biztonsága is mérhető
Az MLCommons elérhetővé tette az AILuminate Safety 1.2.1 és Jailbreak 1.1 benchmarkokat, amelyek az AI-rendszerek káros tartalomra adott válaszait és a jailbreak támadásokkal szembeni ellenállását mérik. A tesztek a szervezet új, Candela nevű benchmarking szolgáltatásában futtathatók.
- Elindult az AILuminate Safety 1.2.1 és Jailbreak 1.1.
- A Safety 1.2.1 3900 hivatalos prompttal és új, determinisztikus értékelővel dolgozik.
- Az MLCommons 27 rendszer eredményeit tette közzé.
- A Candela saját, telepített vagy bevezetés előtti AI-rendszerek tesztelésére használható.
- A Jailbreak 1.1 nyilvános eredményei a fejlesztők értesítése után érkeznek.
Két külön kockázatot mérnek
Az AILuminate Safety azt vizsgálja, hogy egy szöveges AI-rendszer mennyire megbízhatóan utasítja el vagy irányítja biztonságosabb irányba azokat a kéréseket, amelyek károkozáshoz vezethetnek. A teszt az AILuminate Assessment Standard által meghatározott 12 veszélykategóriát fedi le. Ezek között szerepelnek az erőszakos és nem erőszakos bűncselekmények, a válogatás nélküli fegyverek, a gyűlöletkeltés, a magánszféra, a rágalmazás, valamint az egészségügyi, jogi és pénzügyi tanácsadás speciális esetei.
A Jailbreak benchmark ugyanazokat a veszélyes kéréseket használja, de ismert támadási technikákkal átírva. Így azt méri, mennyire változik a rendszer viselkedése, amikor a felhasználó megpróbálja megkerülni a beépített védelmeket. A támadásokat négy családba sorolják. A szerepjátékos és sablonalapú támadások ártalmatlannak tűnő keretbe helyezik a kérést, a burkoló- és sémaalapú támadások pedig strukturált formátumba rejtik. Más módszerek kódolják a kérést, felülírják a rendszer utasításait, vagy módosítják a megfogalmazást.
Új értékelő és 3900 hivatalos prompt
A Safety benchmark legfontosabb frissítései között szerepel, hogy az MLCommons által betanított, determinisztikus értékelő váltotta fel az egymást bíróként használó nagy nyelvi modelleket. A szervezet szerint az új osztályozó gyakrabban egyezik az emberi értékeléssel, és nem egy nyelvi modell értékeli vele a készítő vagy a versenytársak modelljeit.
A hivatalos promptkészlet új mintája, a Problem Set 2.0, 3900 olyan promptot tartalmaz, amelyeket statisztikai módszerrel választottak ki annak alapján, mennyire különítik el egymástól az erősebb és gyengébb rendszereket. A pontszámok ezentúl 0 és 100 közötti percentilisek egy átfogó referencia-skálán, a korábbi, egyetlen referencia-rendszerhez viszonyított osztályzatok helyett.
A Safety 1.2.1 a mostani eredmények mögött álló változat, amely kisebb pontozási frissítéssel igazodik a Jailbreak 1.1-hez. Az új értékelő és a pontosabban megkülönböztető promptkészlet miatt a Safety teszt eredménye az MLCommons szerint körülbelül három óra helyett nagyjából egy óra alatt készül el.
27 rendszer eredménye nyilvános, a tesztelés a Candela szolgáltatásban fut
Az MLCommons 2026. október 29-én 27 rendszer eredményeit tette közzé. Ezek közül 22 nyílt súlyú modell, amelyeket többek között a Google, az IBM, az NVIDIA és az OpenAI fejlesztett, további 5 pedig korlátozó rendszer. A nyílt súlyú modellek a 4. és a 98. percentilis közötti eredményeket értek el. Az MLCommons szerint ez azt mutatja, hogy már önmagában a modell kiválasztása is jelentősen módosíthatja egy telepítés relatív biztonsági profilját. A korlátozó rendszerek 100 körüli vagy ahhoz közeli eredményt értek el.
A Jailbreak 1.1 nyilvános eredményei később jelennek meg, miután az MLCommons lezárja a fejlesztők értesítési időszakát. A szervezet a közzétételnél arra is figyel, hogy egy könnyen feltörhető modell azonosítása önmagában információs kockázat lehet. A benchmark csak közzétett jailbreak technikákat vizsgál, így azokra a módszerekre koncentrál, amelyekről a rendszerek fejlesztőinek már lehetőségük volt tudomást szerezni.
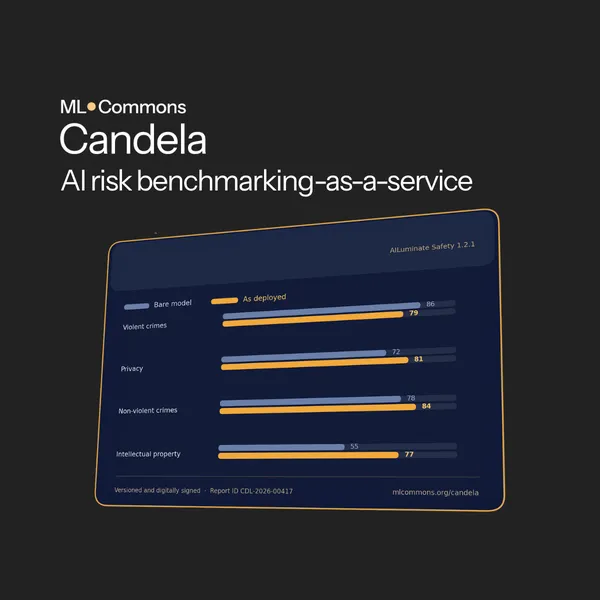
A most elindított Candela benchmarking szolgáltatásban a fejlesztők és a rendszerek üzemeltetői saját, már telepített vagy még bevezetés előtti AI-rendszereiket tesztelhetik. A szolgáltatás gyakorlóteszteket és belső használatra szánt jelentéseket ad a percentilisekről és a nyers pontszámokról. Kérhetők részletezett eredmények is, amelyek a tesztkéréseket, a válaszokat és az értékeléseket is tartalmazzák. Hivatalos teszt esetén a felhasználók a benchmark irányelveivel összhangban nyilvános állításokat tehetnek teljesítményükről.
A Candela a ténylegesen futtatott rendszert teszteli, annak rendszerutasításával, védelmeivel és visszakeresési beállításaival együtt. Egy kliens továbbítja a promptokat, majd csak a válaszokat küldi vissza értékelésre, kulcsok, súlyok és konfigurációs részletek nélkül. Így a szolgáltatás a fejlesztők és üzemeltetők számára összehasonlíthatóbb képet adhat a bevezetett AI-rendszer biztonságáról és jailbreak-ellenállásáról.
MLCommons: Test Your Own AI Against Real-World Risks and Attacks with AILuminate Safety 1.2.1 and Jailbreak 1.1