Candela: szolgáltatásként érkezik az AI-rendszerek kockázati tesztelése
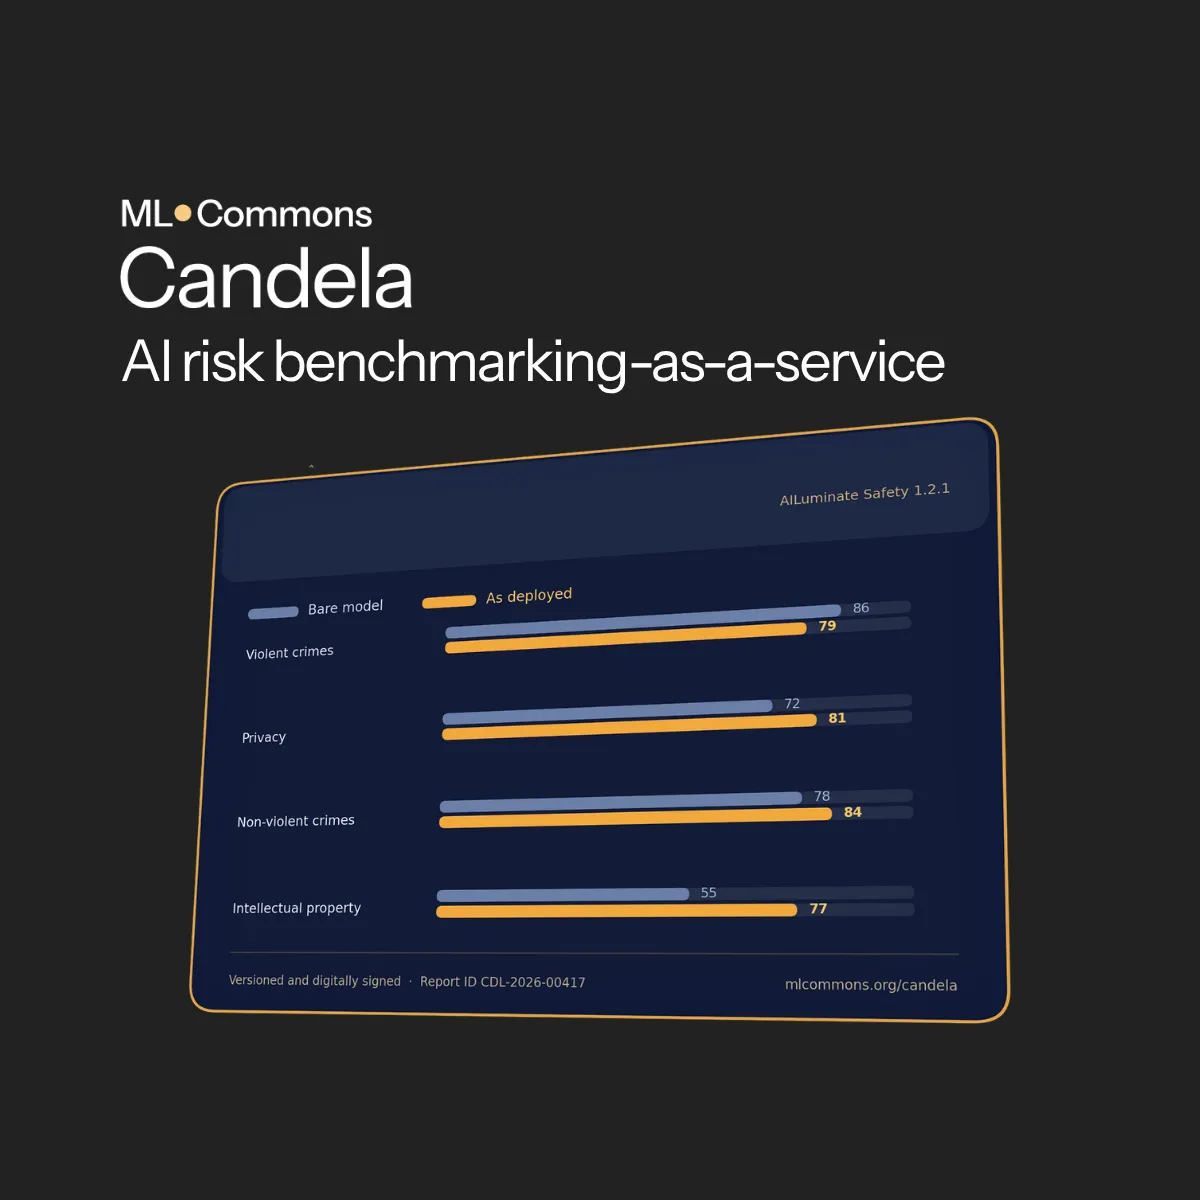
Az MLCommons elindította a Candela nevű benchmarking-szolgáltatást, amely fejlesztők és AI-rendszereket bevezető vállalatok számára méri a biztonsági és megbízhatósági kockázatokat. A rendszer az AILuminate szabványosított tesztjeit kínálja különböző modellek és teljes rendszerek összehasonlítására.
- Az MLCommons elindította a Candela AI-kockázati benchmarking-szolgáltatást.
- A Safety 1.2.1 tizenkét veszélykategóriát vizsgál.
- A Jailbreak 1.1 tizenegy kategóriában teszteli a védelmek megkerülését.
- A tesztkérdések zártak, az eredmények rögzített referencia-rendszerekhez viszonyított percentilisek.
- A szolgáltatás gyakorló, részletes és hivatalosan hivatkozható eredményeket kínál.
Tizenkét veszélykategóriát vizsgál az új rendszer
Az MLCommons szerint az AI-rendszerek viselkedése minden konfigurációs változtatással módosulhat, ezért a fejlesztőknek és a bevezetést végző vállalatoknak azt is mérniük kell, hogy egy rendszer milyen gyakran ad nem kívánt választ. A Candela ezt a mérést kínálja benchmarking-szolgáltatásként, a fejlesztés alatt álló modellektől a többmodelles, összetett vállalati telepítésekig.
A szolgáltatás az AILuminate benchmarkok új verzióival indul. A Safety 1.2.1 tizenkét veszélykategóriát vizsgál, köztük az erőszakos bűncselekményeket, valamint a speciális pénzügyi, egészségügyi és jogi tanácsadást. A Jailbreak 1.1 ezek közül tizenegy kategóriát tesztel olyan módszerekkel, amelyek a védelmek megkerülését célozzák. Ezek között szerepelnek az elgépelések, a hasonló karakterek és az „utasítások figyelmen kívül hagyása” típusú felszólítások, továbbá az összetettebb kontextuskeretezés, megtévesztés és töredék-összeállítás.
A Safety 1.2.1 eredményei jelenleg mintegy 30 megnevezett, nyílt súlyú modellhez nyilvánosak. A Jailbreak eredményeit később teszik közzé. Az MLCommons további benchmarkokat is fejleszt az ügynöki rendszerek biztonságára, az adatvédelemre és a pszichoszociális károkra, valamint iparági megbízhatósági profilokat és több nyelvre, illetve kulturális környezetre kiterjesztett teszteket tervez.
Zárt kérdések, összehasonlítható pontszámok
Az AILuminate tesztkérdéseit az MLCommons zárva tartja. A szervezet munkatársain kívül senki nem látja őket, a kérdéssort pedig a modellek és a kockázatok változásával figyelik és frissítik. A szabványokat az AIRR munkacsoportok alakítják ki, több mint 80 szervezet részvételével. A résztvevők között AI-fejlesztők, tanácsadó cégek, kutatóintézetek és civil szervezetek vannak.
Az értékelést minden alkalommal az MLCommons végzi egy biztonsági vizsgálatra fejlesztett, saját gépi tanulási osztályozóval. A szervezet szerint ez stabilabb és időben jobban összehasonlítható eredményeket ad, mint az olyan nyelvi modellek használata, amelyek egy másik modell válaszait bírálnák el. Az MLCommons azt is közölte, hogy a kísérleteikben a generatív AI-alapú értékelők nem tudták megbízhatóan megállapítani, hogy egy rendszer bedőlt-e egy jailbreakkísérletnek.
A pontozás az item response theory nevű statisztikai módszert használja, amely a SAT és a GRE mögött is áll. Ennek segítségével megbecsülik az egyes kérdések nehézségét és azt, mennyire választják el egymástól az erősebb és gyengébb rendszereket. Az eredményeket rögzített referencia-rendszerekhez viszonyított percentilisekként közlik, így a pontszám nem attól függ, hogy éppen mely rendszereket tesztelték még.
A teljesen konfigurált rendszert is lehet tesztelni
A Candela nemcsak a kiadott modell viselkedését méri. Helyi kliensátjárón keresztül a rendszerprompttal, visszakereséssel, eszközökkel vagy ügynöki ciklussal kiegészített rendszerek is vizsgálhatók. Az MLCommons szerint egy modell biztonsági jellemzői megváltozhatnak, ha finomhangolják, személyiséget rendelnek hozzá, beágyazott utasításokat tartalmazó dokumentumot kap egy RAG-rendszeren keresztül, vagy megbízhatónak tekintett eszközből származó szöveggel dolgozik.
Háromféle eredmény érhető el. A gyakorlóteszt pontszámot és összefoglaló jelentést ad, és a fejlesztés közbeni gyakori ellenőrzésekhez készült. Ezek az MLCommons tagjai számára ingyenesek. A megjegyzésekkel kiegészített eredmények minden kérdés, válasz és értékelés részleteit megmutatják, így azonosítható, hol teljesít gyengén a rendszer. A hivatalos eredmények külön, zárt kérdéssoron alapulnak, és nyilvánosan hivatkozhatók például rendszerkártyán, termékleírásban vagy beszerzési döntésben. Ezeket a szervezetek maguk is lefuttathatják, vagy független biztosítási szolgáltatót vonhatnak be.
Közös mércét adhat a fejlesztőknek és a beszerzőknek
Az MLCommons szerint a vállalatok eddig saját értékeléseket, vörös csapatos teszteket és éles környezetben végzett megfigyelést használhattak. Ezek az adott szervezet igényeit szolgálják, de nem biztosítanak mindenki számára azonos jelentésű mérőszámot. A Candela célja, hogy ugyanazt az eredményt a fejlesztő, a vásárló, az auditor és a vállalati vezetés is értelmezhesse.
Minden eredmény verziócímkét kap, és az MLCommons szerint a pontszám jelentését csak a címke megváltoztatásával módosítják. Ez lehetővé teszi a governance-dokumentumokban való hivatkozást és az eredmények időbeli összevetését. Abby Palia, a Microsoft felelős AI-ért felelős vezető termékmenedzsere szerint a vállalatoknak hiteles bizonyítékokra van szükségük a modellek biztonságáról. Palia úgy fogalmazott, hogy a zárt tesztkérdések csökkentik a benchmarkok beszennyezésének kockázatát, a Candela pedig könnyebben hozzáférhetővé teszi ezeket az értékeléseket a vállalatok számára.
MLCommons: Introducing Candela: AI risk benchmarking-as-a-service for developers and deployers