Az AI-képeknek gyakran nincs visszakövethető szerzőjük
Az MIT CSAIL kutatói szerint a nagy adathalmazokon betanított képgeneráló modellek kimenete gyakran nem köthető egyetlen tanítóképes példához, művészhez vagy személyhez. A jelenséget attribution decaynek, vagyis az attribúció elhalásának nevezték el.
- Nagy adathalmazoknál egyetlen tanítókép eltávolítása gyakran nem módosítja a generált képet.
- A kutatók ezt attribution decaynek, az attribúció elhalásának nevezték.
- A diffusion ensemble újratanítás nélkül teszi vizsgálhatóvá egy adat kihagyásának hatását.
- Az eredmény a szerzői jogi felelősség és a modellkimenetek eredetiségének kérdését is érinti.
- A kutatás diffúziós modellekre vonatkozik, a nagy nyelvi modellekre való alkalmazhatóság nyitott.
Eltűnik a kapcsolat a tanítóadat és a kép között
A kutatás központi kérdése az volt, hogy egy mesterséges intelligencia által készített portré vagy más kép létrehozásához pontosan mely tanítóadatok járultak hozzá. Az MIT Computer Science and Artificial Intelligence Laboratory kutatói arra jutottak, hogy nagy méretű adathalmazoknál gyakran nincs egyértelmű válasz.
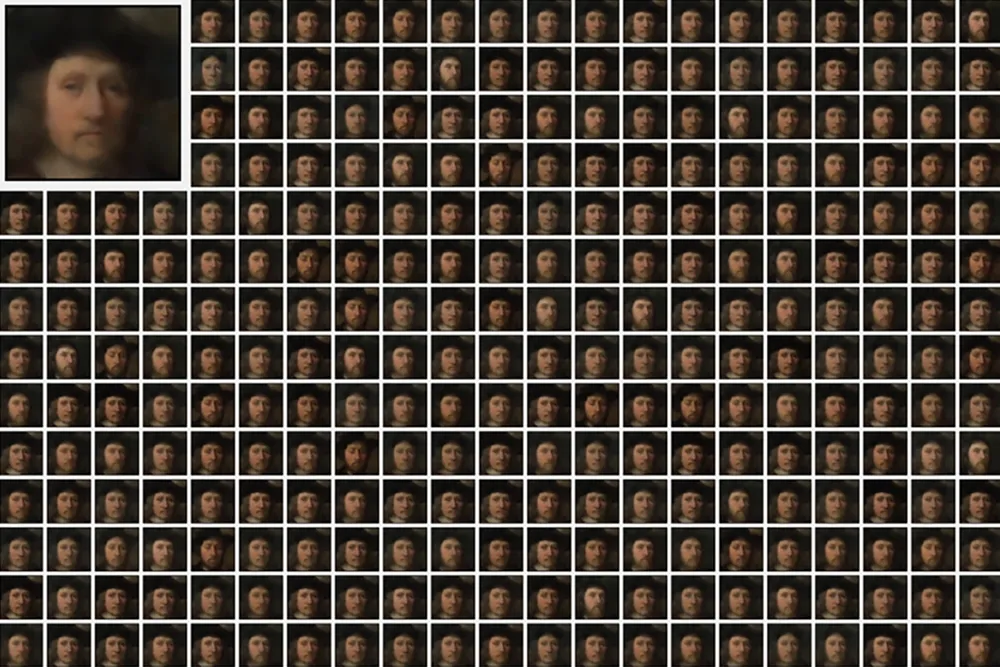
A vizsgálat szerint egyetlen kép eltávolítása a tanítóadatokból sok esetben nem változtatja meg érzékelhetően a generált eredményt. Ugyanez igaz lehet akkor is, ha egy adott művész összes képét, vagy egy adott személyről készült összes fényképet hagyják ki. A kutatók ezt attribution decaynek nevezik: minél több adatból tanul a modell, annál kevésbé számít bármelyik egyedi példa egy konkrét kimenetnél.
Zheng Dai, a tanulmány vezető szerzője szerint ha egy adat eltávolítása nem módosítja a modell eredményét, akkor az adat nem befolyásolta azt. David Gifford, az MIT professzora úgy fogalmazott, hogy a korábbi módszerek csak közelítően becsülték az egyes tanítóadatok hatását, míg az új eljárás ténylegesen törli a bemeneteket és azok minden befolyását.
A diffusion ensemble valódi ellenpéldákat készít
A kérdés közvetlen megválaszolásához azt kellene megvizsgálni, mit készített volna a modell, ha soha nem találkozik egy adott képpel. Ehhez hagyományosan minden egyes kép kihagyásával újra kellene tanítani a modellt, ami több millió példa esetén rendkívül költséges lenne.
A kutatók ezért egy diffusion ensemble nevű architektúrát építettek. Ez nem egyetlen nagy modellből áll, hanem több kisebb komponensből, amelyek az adatok különböző részein tanulnak. Egy kép hatásának vizsgálatakor egyszerűen kikapcsolhatók azok a részek, amelyek az adott képet látták. Így újratanítás és becslés nélkül állítható elő az a modell, amely valóban nem használta a kérdéses adatot.
A csapat 24 hagyományos diffúziós modellel hasonlította össze az ensemble modelleket, azonos tanítóadatok használatával. A képek a szokásos mérőszámok alapján hasonló minőségűek voltak. A kutatók szerint az ensemble modellek kevés adatnál gyengén teljesítettek, nagyobb adathalmazoknál azonban jobban skálázódtak.
Jogi és adatvédelmi kérdéseket is felvet az eredmény
A kutatók 24 ensemble modellt tanítottak 256 képtől több mint 160 000 képig terjedő adathalmazokon. A képek hét nyilvános gyűjteményből származtak, köztük a CIFAR-10, a CelebA, a MetFaces és az ArtBench adataiból. Az eredmény következetes volt: ahogy nőtt a tanítóadatok mennyisége, úgy csökkent annak a legnagyobb különbsége, amelyet egyetlen adat eltávolítása okozhatott.
A kutatók kis léptékben 1282 külön modellt is betanítottak, és az elhalás így is megjelent. A hatás többféle mérési módszer, rögzített tanítási ciklusszám, szöveges utasításokkal működő modellek és osztályfeltételes modellek mellett is fennmaradt.
David Gifford szerint az eredmény érinti azt a jogi kérdést, hogy a modell kimenetei származékos műveknek számítanak-e. James Grimmelmann, a Cornell Law School jogászprofesszora szerint a tanulmány alapján az attribúció érdekes modelleknél kudarcot vallhat, ezért a technológusoknak és a bíróságoknak más módszereket kell használniuk a másolás megítélésére. A kutatás diffúziós modelleket vizsgált, az eredmény pedig a nagy nyelvi modellekre egyelőre nyitott kérdés marad.
MIT Schwarzman College of Computing: When AI art has no author: Study finds generated images often can’t be traced to training data