A képességfejlesztés is alakíthatja az AI biztonsági határát
A mesterséges intelligencia képességeit fejlesztő kutatások is tágíthatják a biztonság és hasznosság közötti lehetőségeket, de a fejlesztők ettől még veszélyesebb rendszereket választhatnak. A Redwood Research új elemzése szerint ezért önmagában nem elég azt vizsgálni, hogy egy kutatás javítja-e a biztonságot.
- A Redwood Research szerint a képességkutatás is tágíthatja a biztonság és hasznosság Pareto-határát.
- Az új képességek azonban veszélyesebb modellek választására ösztönözhetik a fejlesztőket.
- A következtetés gyorsítása adott hasznosság mellett biztonsági előnyöket is teremthet.
- A szervezet szerint jelenleg valószínűleg káros a képességkutatás az élvonalbeli AI-cégeknél.
A biztonság és a hasznosság közötti határ
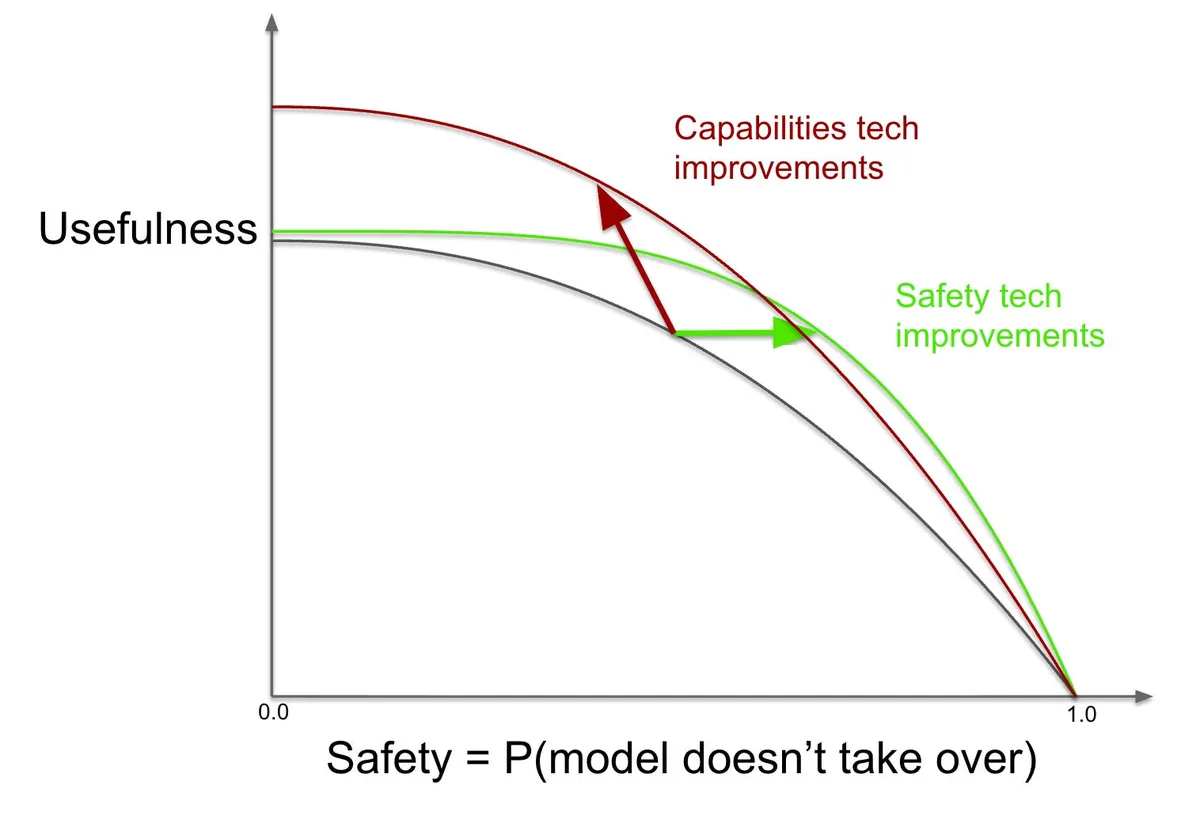
A Redwood Research október 2-án közzétett elemzése a biztonság és a hasznosság Pareto-határának fogalmából indul ki. Ez azt mutatja meg, hogy egy adott hasznossági szint mellett mekkora biztonság érhető el, illetve milyen kombinációk közül választhatnak az AI-fejlesztők.
Elsőre úgy tűnhet, hogy minden olyan kutatás biztonsági kutatás, amely egy adott hasznosság mellett biztonságosabb rendszerek létrehozását teszi lehetővé. A Redwood Research szerint ez a meghatározás túl tág lenne, mivel lényegében minden sikeres képességfejlesztés új lehetőségeket teremt. Például a következtetés hatékonyságának javítása lehetővé teheti gyengébb, biztonságosabb modellek szélesebb körű használatát.
A kutatócsoport szerint azonban a fejlesztőknek végül egy konkrét pontot kell választaniuk ezen a határon. A kutatás hatása ezért attól is függ, hogyan változik a lehetőségek alakja, és milyen ösztönzőket teremt a fejlesztők számára.
A képességkutatás veszélyesebb irányba tolhatja a döntést
A Redwood Research modellje szerint a biztonsági kutatás jellemzően új biztonsági lehetőségeket teremt anélkül, hogy jelentősen növelné a hasznosságot. A képességkutatás ezzel szemben főként a hasznosságot bővíti, miközben nem biztosít hasonló mértékű új biztonsági lehetőségeket.
Az elemzés a biztonságot úgy definiálja, mint annak valószínűségét, hogy a modell nem veszi át az irányítást. A Redwood Research szerint ez a meghatározás akkor válik különösen fontossá, amikor a mesterséges intelligencia közvetlen átvételi kockázatot jelenthet. A közelebbi rendszereknél kisebb kontrollvesztési eseményeket, például ellenőrizetlen belső telepítéseket is lehet mérni.
A fejlesztőknek nem kell önzetlennek lenniük ahhoz, hogy törődjenek a biztonsággal, hiszen ők sem szeretnék, hogy az AI átvegye felettük az irányítást. Ugyanakkor a fejlesztők nem tökéletes információk alapján döntenek, és többféle módon is irracionálisan viselkedhetnek. A hasznosság növelésére irányuló új lehetőségek ezért arra ösztönözhetik őket, hogy kevesebb biztonságot válasszanak.
Példa az RLVR-re és a következtetés gyorsítására
A Redwood Research egy lehetséges példaként olyan RLVR-környezetek létrehozását említi, amelyek közül sok kijátszható. Ez megkönnyítheti egy hasznosabb modell betanítását, miközben csak kis mértékben teszi könnyebbé biztonságosabb modell fejlesztését. A fejlesztők elméletileg kiszűrhetnék agresszívebben a kijátszható környezeteket, és így egy adott hasznosság mellett valamivel biztonságosabb rendszert hozhatnának létre. A Redwood Research szerint azonban a jelenlegi vezető AI-fejlesztők várhatóan inkább a nagyobb képességű és veszélyesebb modell betanítására használnák az új környezeteket.
Más képességkutatások jelentősebb biztonsági előnyöket is lehetővé tehetnek. Ilyen lehet a következtetés áteresztőképességének gyorsítása. A Redwood Research szerint egy adott hasznossági szinten biztonságosabb lehet egy gyengébb modell használata több következtetési időre fordított számítással, mint egy hasonlóan hasznos, de erősebb modellé.
A gyorsabb következtetés emellett erősebb ellenőrzési protokollokat is lehetővé tehet. Egy gyanús műveleteket újramintázó protokoll például annál biztonságosabb lehet, minél több műveletet lehet újramintázni egy folyamatban. A nagyobb következtetési teljesítmény ezt változatlan hasznosság mellett is támogathatja.
A szerzők jelenleg nem javasolják a képességkutatás bővítését
A Redwood Research hangsúlyozza, hogy az elemzés nem amellett érvel, hogy több embernek kellene képességkutatással foglalkoznia. A szervezet szerint jelenleg valószínűleg káros a képességkutatás bármely, élvonalbeli AI-cégnél.
A bejegyzés célja inkább annak vizsgálata, mikor és miért szolgálhatja a biztonságot vagy a képességek fejlesztése. A Redwood Research szerint egy olyan jövőbeli rendszerben, ahol a politikai akarat jóval erősebb a jelenleginél, bizonyos képességkutatások hatékony eszközt jelenthetnek a biztonság javítására. A mostani állítás lényege, hogy a kutatás biztonsági hatását nem lehet pusztán az új lehetőségek számából megítélni, azt is vizsgálni kell, milyen döntések felé tereli a fejlesztőket.
Redwood Research: Capabilities research expands the safety-usefulness Pareto frontier too