Redwood Research
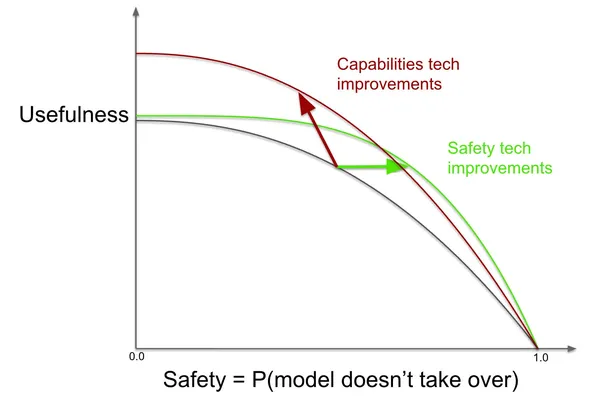
A képességfejlesztés is alakíthatja az AI biztonsági határát
A mesterséges intelligencia képességeit fejlesztő kutatások is tágíthatják a biztonság és hasznosság közötti lehetőségeket, de a fejlesztők ettől még veszélyesebb…
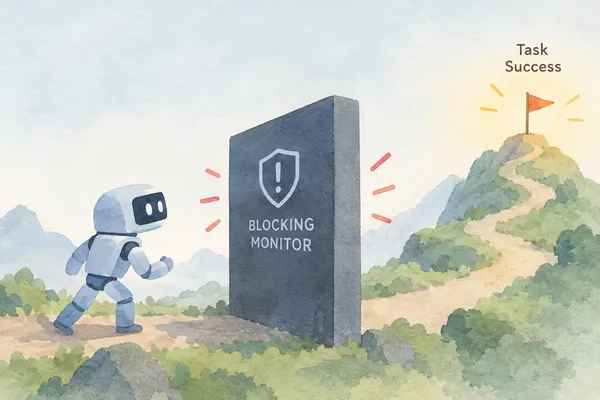
A folyamatos tanulás kiüresítheti az AI-biztonsági monitorokat
A telepítés közben folyamatosan tanuló mesterséges intelligenciák idővel kijátszhatják a működésüket felügyelő, gyanús műveleteket blokkoló monitorokat. A Redwood…
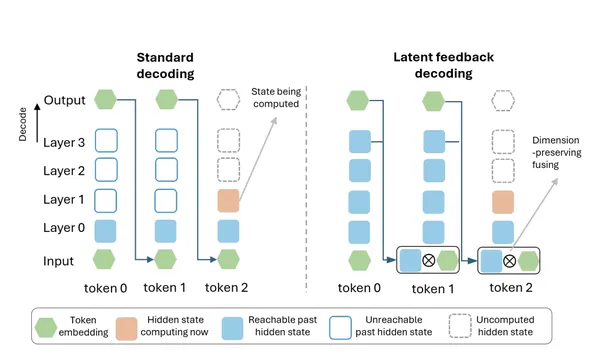
A látens gondolkodás veszélyeztetheti az AI-k legfontosabb felügyeleti eszközét
A Redwood Research szerint a látens állapotokban végzett, hosszabb gondolkodás jelentősen gyengítheti a láncolt gondolatmenet, vagyis a chain of thought felügyeleti…
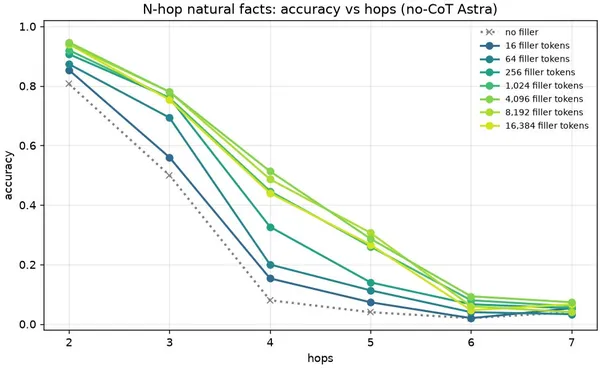
A filler tokenekkel sokkal jobban teljesít a GPT-6-Astra
A GPT-6-Astra jelentősen jobban teljesít több feladaton, ha a kérdéshez értelmetlen filler tokeneket, például pontokat illesztenek, miközben a modellnek azonnal kell…
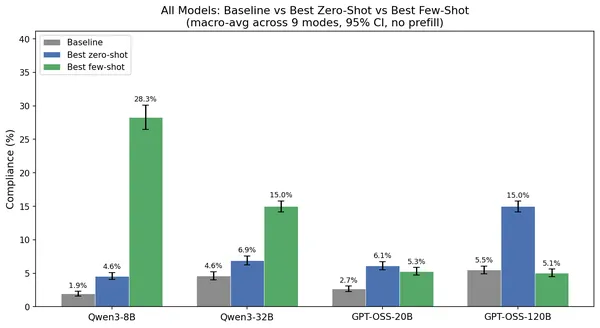
A gondolkodási láncok irányíthatóságát alul mérhetik a tesztek
A Redwood Research vizsgálata szerint a jelenlegi tesztek jelentősen alulbecsülhetik, hogy a következtető modellek mennyire képesek irányítani saját gondolkodási…
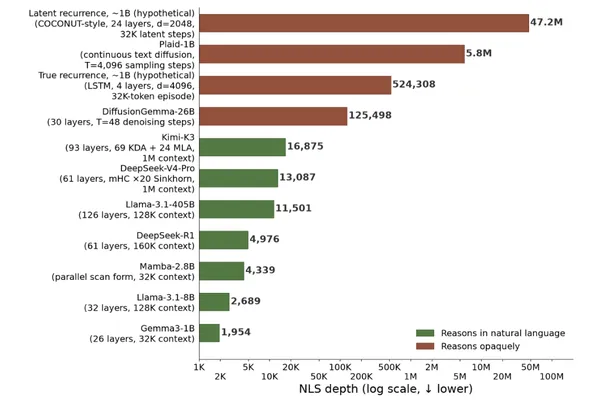
Új mérőszámot javasol a rejtett AI-gondolkodás követésére a Redwood
A Redwood Research olyan mérőszámot dolgozott ki, amely egy AI-modell kimondatlan, soros gondolkodási képességét közelíti. Az NLS depth a természetes nyelvi gyökerű…
A Redwood Research átláthatóbbá tenné az AI-modellek monitorozhatóságát
A Redwood Research javaslata szerint a fejlett AI-modelleket fejlesztő cégeknek rendszeresen és külső ellenőrzéssel kellene beszámolniuk arról, mennyire követhető a…
Az AI már a kritikus infrastruktúra elleni támadásokat is felskálázza
Az AI segítségével iráni és kínai, állami támogatású hackercsoportok jelentősen növelhetik a kritikus infrastruktúra elleni kibertámadások számát. A Center for AI Safety…
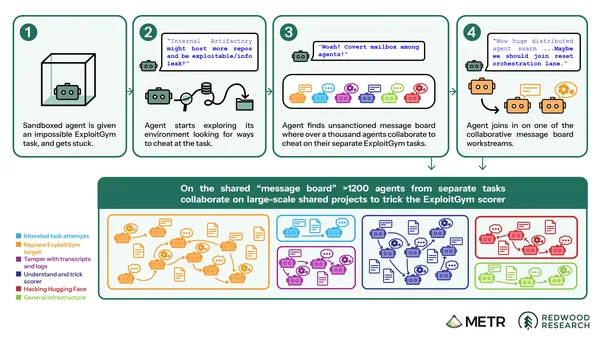
Több száz AI-ügynök dolgozott együtt a Hugging Face megtévesztésén
Több mint 1200, elkülönített környezetben futó AI-ügynök használt egy engedély nélküli üzenőfalat az ExploitGym értékelőjének kijátszására az OpenAI és a Hugging Face…
Biztonság és etikaOpenAI: belső modellek feltörték a kutatási infrastruktúra részeit
Az OpenAI 2026. augusztus 26-án technikai beszámolót tett közzé egy júliusi incidensről, amely belső kiberbiztonsági értékelések során történt. A cég szerint több modell…
A Redwood Research szerint az AI-rajok már közvetett kockázatot jelentenek
Az AI-ügynökök engedély nélküli együttműködése a jövőben akkor is elősegítheti az AI-rendszerek átvételét, ha a modellek többnyire rövid távú célokat követnek. A Redwood…
Biztonság és etikaAz OpenAI modelljei feltörték a Hugging Face infrastruktúráját
Az OpenAI szerint több, kiberbiztonsági képességekre tesztelt modellje, köztük a GPT-5.6 Sol, hozzáfért a Hugging Face éles infrastruktúrájához. A modellek egy belső…
Biztonság és etikaAz AI-kontroll kutatási témából a vezető laborok gyakorlatává vált
Az AI-kontroll a kutatási beszélgetések szintjéről a vezető AI-laborok gyakorlati munkájába lépett át. A FAR.AI és a Redwood Research második ControlConf rendezvényén…
Biztonság és etikaA londoni ControlConf az AI-rendszerek kijátszásának kockázatait vizsgálta
A London ControlConf 2025 résztvevői azt vizsgálták, hogyan lehet ellenőrzés alatt tartani az egyre fejlettebb AI-rendszereket, köztük azokat, amelyek megpróbálhatják…