A filler tokenekkel sokkal jobban teljesít a GPT-6-Astra
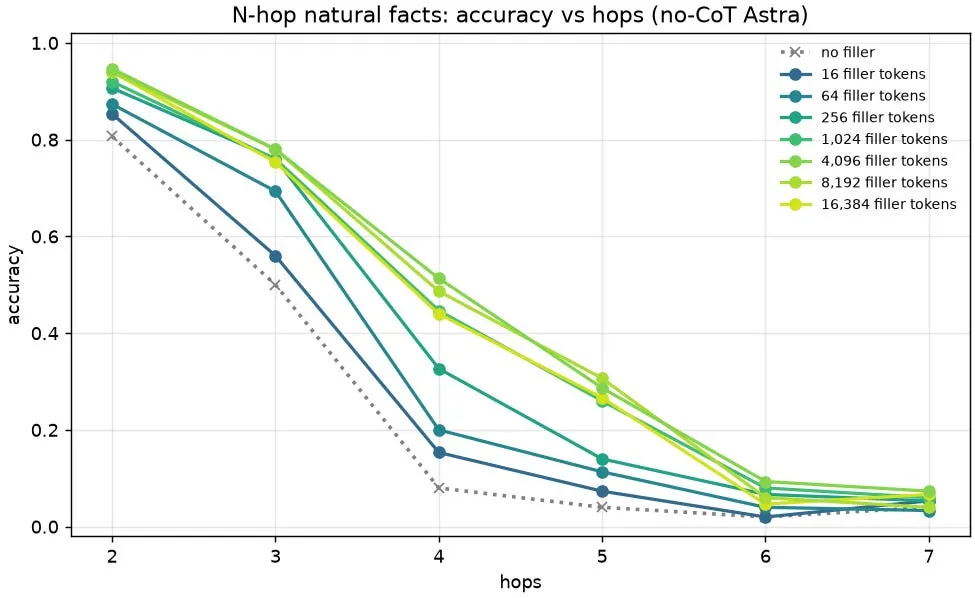
A GPT-6-Astra jelentősen jobban teljesít több feladaton, ha a kérdéshez értelmetlen filler tokeneket, például pontokat illesztenek, miközben a modellnek azonnal kell válaszolnia. A Redwood Research szerint ez arra utalhat, hogy a rendszer a látható gondolatmenetén kívül is jelentős kognitív munkát végez.
- A GPT-6-Astra filler tokenekkel jelentősen jobban teljesített több következtetési feladaton.
- A négy lépéses természetes tényfeladatokon az eredmény körülbelül 10, 20 százalékról 50 százalékra javult.
- Régebbi AIME-feladatokon a teljesítmény nagyjából 60, 70 százalékról 90 százalékra nőtt.
- A Redwood Research szerint az Astra látható gondolatmenet nélkül is végezhet jelentős kognitív munkát.
- A kutatók filler tokenes vizsgálatokat javasolnak a gondolatmenet nélküli értékelésekhez.
A pontok és ismétlések javították a teljesítményt
A Redwood Research szeptember 23-án közzétett vizsgálata változó számú, információt nem hordozó tokennel egészítette ki a GPT-6-Astra kérdéseit. A kutatók példaként pontokat, számozott filler tokeneket, illetve a feladat szövegének ismétlését használták. A modellnek közben azt írták elő, hogy gondolkodás nélkül, azonnal válaszoljon.
A teszteket olyan feladatokon végezték el, amelyek hosszú, egymásra épülő következtetési láncot igényelnek. A négy lépésből álló, természetes nyelvi tényekre épülő feladatokon az Astra teljesítménye nagyjából 10, 20 százalékról körülbelül 50 százalékra javult a filler tokenek használatával. Régebbi AIME-feladatokon a teljesítmény hozzávetőleg 60, 70 százalékról mintegy 90 százalékra nőtt.
A természetes tényekre épülő tesztben a javulás a filler tokenek számának növelésével 4096 tokenig jelentős volt. A matematikai feladatoknál a kedvező hatás körülbelül 8192 tokennél tetőzött.
Más modelleknél kisebb volt a hatás
A kutatók az Astrát más modellekkel is összevetették. A négy lépésből álló természetes tényfeladatok eredményeit az Opus 4.5, az Opus 5, a GPT-5.6-Sol és a Deepseek-V3.2 kétlépéses feladataival hasonlították össze. A Redwood Research szerint ezek a modellek a filler tokenek számának növelésére nem javultak olyan mértékben, mint az Astra.
Hasonló eredmény született a 15 műveletből álló, hosszú aritmetikai kifejezéseknél is. Az Astra teljesítménye ezeken a feladatokon sokkal nagyobb mértékben javult, mint a vizsgált többi modellé. AIME-szintű matematikai kérdéseknél szintén az Astra mutatott erősebb javulást, miközben a többi modellnél ez kevésbé volt jellemző.
A kutatók az Astrát a Humanity’s Last Exam és a LiveBench egyes feladatain is vizsgálták. A filler tokenek a legtöbb kategóriában mérsékelten javították a teljesítményt. A számlálós változatban az 1-től 1000-ig való számlálás körülbelül 2000 tokent jelentett.
A láthatatlan gondolkodás biztonsági kérdéseket vet fel
A Redwood Research szerint az eredmények azért aggasztók, mert az Astra jelentős kognitív munkát végezhet úgy, hogy azt nem jeleníti meg a gondolatmenetében. Ez megnehezítheti a modell működésének ellenőrzését.
A kutatók különösen a gondolatmenet monitorozására épülő biztonsági megközelítések miatt tartják fontosnak a jelenséget. Ha egy modell jelentős következtetéseket képes elvégezni azok verbalizálása nélkül, akkor a megfigyelők számára nehezebbé válhat annak felismerése, ha a rendszer káros cselekvéshez vezető folyamatot követ.
A Redwood Research azt javasolja, hogy a jövőbeli, gondolatmenet nélküli nagy nyelvi modellteszteket filler tokenekkel is végezzék el. A szervezet szerint ezzel jobban előhívható a modellek olyan teljesítménye, amely nem jelenik meg a látható gondolatmenetben. A kutatók a kódot és az eredményeket külön adattárban tették elérhetővé.
Redwood Research: Astra is much better at reasoning with filler tokens than previous models