Az AI21 olcsóbb modellekkel ért el 80,8 százalékos SWE-Bench-eredményt
Az AI21 Labs többmodellű kódolási architektúrával 80,8 százalékos felbontási arányt ért el a SWE-Bench Pro teszten, miközben egy feladat átlagos költsége 5,99 dollár volt. A rendszer az olcsóbb modelleket használja felderítésre és kontextusgyűjtésre, a drágább frontier modellt pedig csak a végső javítás elkészítésére hívja meg.
- Az AI21 rendszere 80,8 százalékos felbontási arányt ért el a SWE-Bench Pro teszten.
- A Fable 5-tel futtatott többmodellű folyamat költsége 5,99 dollár volt feladatonként.
- A MiniMax-M3 a kódtár felderítését és a megoldási kísérleteket végzi.
- A GPT-5.2 a javításhoz szükséges kontextust állítja össze.
- A frontier modell csak az előkészített kontextus alapján készíti el a végső javítást.
A feladatot több modell között osztják fel
Az AI21 Labs július 15-i bejegyzése szerint a megközelítés az úgynevezett végrehajtó és koordinátor modellekre épülő architektúrák továbbgondolása. A frontier modell feladata általában a probléma felmérése, a terv elkészítése és a kisebb végrehajtó modellek irányítása. Az AI21 szerint a költség tovább csökkenthető, ha a teljes folyamatot úgy alakítják ki, hogy az olcsóbb modellek kapják az első lépéseket.
A vállalat rendszerében ezek a modellek párhuzamosan vizsgálják a teljes kódtárat, megoldási kísérleteket készítenek és teszteket futtatnak. Ezután egy erősebb modell összegzi a kísérleteket, feltárja az érintett függvényeket, a hívókat és a kapcsolódó teszteket. A legdrágább modell csak ezután készíti el egyszer a végleges javítást, az előkészített kontextus alapján.
Az AI21 ezt egy junior, senior és principal szerepkörből álló csapathoz hasonlítja. A junior szerepet a MiniMax-M3 tölti be, a senior feladatokat a GPT-5.2 végzi, a végső javítást pedig az Opus 4.8 vagy a Fable 5 készíti el.
80,8 százalékos eredmény a SWE-Bench Pro teszten
A kísérletben használt szabványos kódolóügynök-beállítás szerint a rendszer természetes nyelvű hibaleírást kap, egy Docker-konténerben dolgozik a célként megadott kódtáron, terminálparancsokat használ, majd git-javítást ad ki. A megoldást rejtett tesztek alapján értékelik.
Az AI21 alapvonalként egy klasszikus ReAct, vagyis Reasoning + Acting ciklust használt, amelynek egyetlen eszköze a Docker-terminál volt. A nyílt forráskódú MiniMax-M3 önálló futtatása a teljes, nyilvános SWE-Bench Pro készlet 57 százalékát oldotta meg.
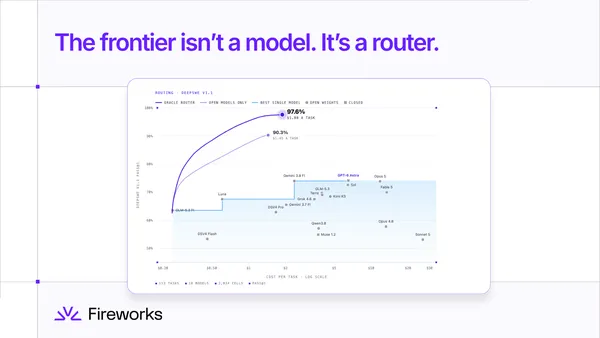
A többmodellű folyamat az AI21 szerint 80,8 százalékos felbontási arányt ért el a SWE-Bench Pro teszten, miközben a Fable 5-tel futtatott rendszer feladatonként 5,99 dollárba került. A vállalat ezt állítja szembe azzal, hogy a Fireworks AI korábbi beszámolója alapján egy önálló Opus 4.8 ügynök 18,28 dollárt költött egy teljes feladatra.
A költségcsökkentés kulcsa a kontextus szűrése
Az AI21 vizsgálta azt is, hogy az előkészített kontextus valóban tartalmazza-e a javításhoz szükséges kódot. Ehhez a SWE-Bench Pro úgynevezett aranyjavításait használták viszonyítási alapként, és azt mérték, hogy az aranyjavítás által érintett sorok mekkora része jelenik meg az összegyűjtött kontextusban. Az elemzés 731 nyilvános SWE-Bench Pro-feladatra vonatkozott.
A párhuzamos MiniMax-M3-futtatások számának növelésével egyre több releváns kódrészlet kerülhet elő. A GPT-5.2 erre építve a javításhoz szükséges környező kódot is összegyűjti. A módosított vagy törölt soroknál a párhuzamos futtatások és a kontextuskinyerés együtt körülbelül 90 százalékos lefedettséget ért el. Az újonnan hozzáadott kódsoroknál ez az arány körülbelül 71 százalék volt.
Az AI21 szerint a megoldási javítások akár több tízezer tokent is elérhetnek, ezért a felesleges kontextus növelheti a költséget, és elterelheti a modellt a megfelelő megoldástól. A rendszerben a frontier modellek a teljes költségvetés 25 százalékát használják fel, a többi munkát olcsóbb modellek végzik.
A frontier modell csak a nehéz részhez kell
Az AI21 következtetése szerint a modelleket az egyes munkafázisokhoz kell igazítani. A gyengébb, nyílt modellek a vállalat szerint már alkalmasak kódtárak keresésére és több megoldási kísérlet létrehozására, miközben kevesebbe kerülnek. A frontier modell így azokra a feladatokra maradhat, amelyeknél a kisebb modellek még nehezebben teljesítenek.
A cég további fejlesztési iránya a forráskontextus-kinyerési lépés betanítása, hogy nagyobb lefedettséget érjenek el. Az AI21 által bemutatott rendszer lényege, hogy a korábbi próbálkozásokat nem dobja el, hanem ezekből készít térképet a javításhoz szükséges kódról, majd erre alapozza a végső modell munkáját.