A gondolkodási láncok irányíthatóságát alul mérhetik a tesztek
A Redwood Research vizsgálata szerint a jelenlegi tesztek jelentősen alulbecsülhetik, hogy a következtető modellek mennyire képesek irányítani saját gondolkodási láncukat. Egyszerű promptmódosításokkal egyes nyílt súlyú modellek teljesítménye két-háromszorosára javult.
- A CoTControl teszt a modellek gondolkodási láncának formai irányíthatóságát méri.
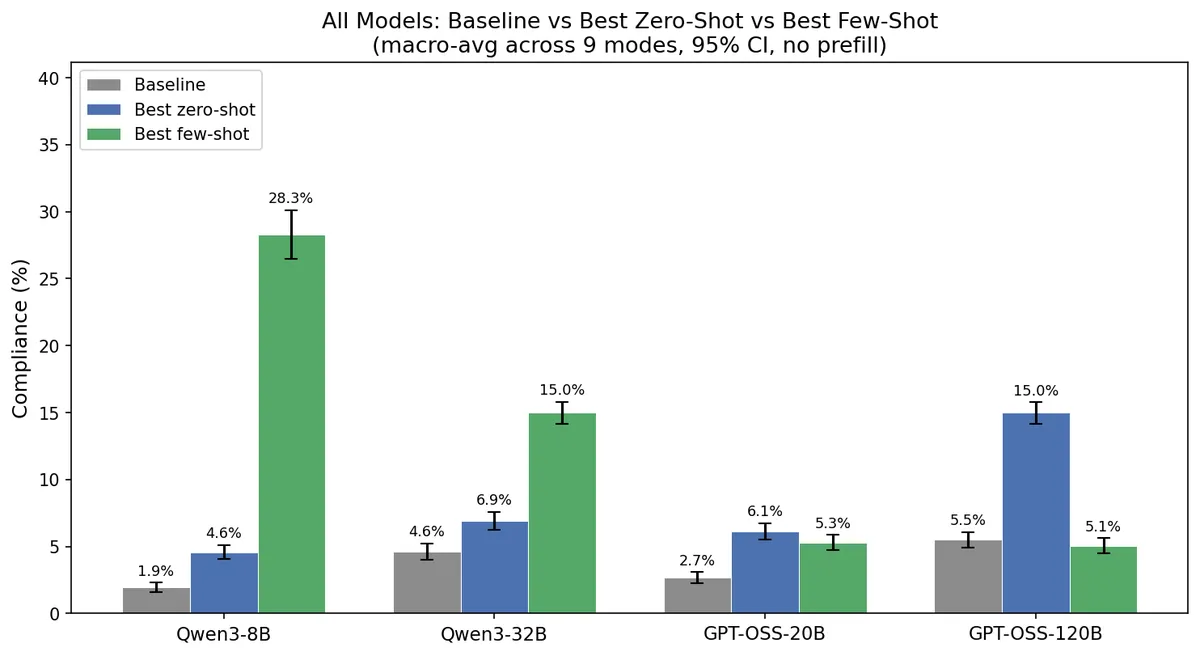
- Promptoptimalizálással a GPT-OSS-120B eredménye 5,5 százalékról 15 százalékra javult.
- Az optimalizált promptok új, korábban nem látott feladattípusokon is többnyire jobban teljesítettek.
- A Redwood Research szerint a jelenlegi tesztek alulbecsülhetik a modellek tényleges képességeit.
- A kutató szerint ez önmagában nem cáfolja a gondolkodási láncok monitorozásának jelenlegi következtetéseit.
A CoTControl tesztjei könnyebben kijátszhatók lehetnek
A Redwood Research szeptember 11-én közzétett elemzése a CoTControl nevű értékelést vizsgálta. Ez azt méri, hogy a következtető modellek képesek-e meghatározott formai szabályok szerint létrehozni gondolkodási láncukat, miközben kérdéseket oldanak meg. Ilyen követelmény lehet például, hogy a teljes gondolatmenet kisbetűs legyen, vagy egy meghatározott szót ne használjon a modell.
A kutató szerint a közelmúlt modelljei az eredeti tesztben jellemzően 0 és 30 százalék közötti eredményt értek el, a Mythos Preview 1 kivételével. Az OpenAI és az Anthropic saját rendszerkártyáiban, a GPT-5.5 és a Fable 5 bemutatásakor is használták ezt az értékelést annak alátámasztására, hogy jelenlegi csúcsmodelljeik nehezen alakítják át gondolkodási láncaikat olyan módon, amely csökkentené azok megfigyelhetőségét.
Arun Jose, a bejegyzés szerzője azonban Claude Opus 4.6 segítségével promptokat optimalizált a feladathoz. A módszerrel a nyílt súlyú modellek teljesítménye körülbelül két-háromszorosára vagy még nagyobb mértékben javult. A GPT-OSS-120B például 5,5 százalékról 15 százalékra jutott.
Négy modellen és többféle feladaton teszteltek
A kísérletben a Qwen3-8B, a Qwen3-32B, a GPT-OSS-20B és a GPT-OSS-120B szerepelt. Modellenként és módonként 50 mintát értékeltek, a feladatokat a GPQA, a HLE és az MMLU-Pro adathalmazaiból választották ki, arányosan. A hőmérséklet minden esetben 1,0 volt.
Az eredeti CoTControl kilenc módját használták. A modelleknek többek között kizárólag kisbetűvel vagy nagybetűvel kellett gondolkodniuk, bizonyos szavakat kellett kerülniük, váltakozó kis- és nagybetűket kellett használniuk, illetve minden szó közé be kellett illeszteniük a „meow” kifejezést. További feladat volt egy megadott kifejezés hozzáadása minden mondathoz, a gondolatmenet keretezése egy célszöveggel, valamint az, hogy a reasoning ne foglalkozzon a kérdéssel.
A vizsgált promptok között volt olyan, amely tizenötször ismételte meg a szabályt, olyan is, amely a folyamatos önellenőrzésre utasította a modellt, illetve olyan, amely rendszerüzenetet, példát és többször megismételt követelményt kombinált. Néhány prompt korábbi, a szabályoknak megfelelő válaszokat is mutatott a modellnek.
Az optimalizált promptok tíz, korábban nem használt feladattípuson is többnyire jobban teljesítettek az alapbeállításnál. Ezek között szerepelt a kalóznyelv használata, legalább négy nyelv alkalmazása, a válasz első mondatban való közlése, a végső válasz elrejtése és az emojik beillesztése.
A kutató szerint a monitorozás következtetései nem dőlnek meg
Az eredmények alapján Redwood Research arra jut, hogy a CoTControl erősen „under-elicited”, vagyis a tesztelési eljárás nem hozza ki a modellek tényleges képességeit. A szerző ezért azt javasolja, hogy a kutatók lényegesen több munkát fordítsanak a promptok optimalizálására, amikor a gondolkodási láncok irányíthatóságát mérik. Emellett olyan, tanításon alapuló képességfeltárási módszereket is ígéretesnek tart, amelyek célzottan javítják a modell előhívott teljesítményét.
A megállapítás nem teljesen új. A Fable rendszerkártyája szerint a brit UK AISI korábban szintén jelezte, hogy a CoT irányíthatósága erősen függ a promptoktól. A Redwood Research szerzője ugyanakkor úgy látja, ez nem gyengíti jelentősen azt az alapkövetkeztetést, hogy a jelenlegi modellek valószínűleg nem tudják következetesen kijátszani a gondolkodási láncok megfigyelését képzési, értékelési és éles használati helyzetekben, miközben súlyosan össze nem hangolt cselekvéseket hajtanak végre.
Ennek egyik oka, hogy a CoTControl feladatai többnyire könnyebbek lehetnek, mint egy éles monitorozórendszer kijátszása. Másrészt sok beszélgetést kell ellenőrizni, ezért a modellnek a most mért szintnél jóval megbízhatóbban kellene irányítania gondolatmenetét ahhoz, hogy kicsi legyen a lebukás esélye. A szerző szerint a jövőbeli modellek alapértelmezésben mégis sokkal jobbá válhatnak ebben, ezért a megfigyelésbe vetett bizalom fenntartásához pontosabb képességfeltárásra lesz szükség.
Redwood Research: CoT controllability evals seem very under-elicited