Az Amazon módszerével újratanítás nélkül alakíthatók át az AI-modellek
Az Amazon Web Services olyan módszert mutatott be, amely előtanított Transformer-modellekből kiindulva teszi lehetővé hibrid architektúrák létrehozását. A Priming nevű eljárás a vállalat szerint több mint 99 százalékkal csökkenti az előtanítás költségét.
- A Priming előtanított Transformer-súlyokra épít hibrid modelleket.
- Az Amazon szerint az előtanítás költsége több mint 99 százalékkal csökkenthető.
- A Gated KalmaNet teljesített a legjobban a vizsgált állapottér-modellek között.
- Egy 32 milliárd paraméteres GKA-alapú modell akár kétszer gyorsabban dekódolt.
- Az Amazon modelleket, kódot és vLLM-bővítményt tett közzé Apache 2.0 licenc alatt.
A hosszabb kontextus egyre nagyobb memóriaigényt jelent
Az AI-ügynökök egyre hosszabb munkamenetekben, összetettebb következtetési láncokkal és nagyobb önállósággal működnek. Az alapjukat adó Transformer-architektúra azonban memória szempontjából egyre drágább, ahogy nő a feldolgozott tokenek száma.
A Transformer figyelmi mechanizmusa minden új tokennél azt számítja ki, hogy a korábban látott tokenek közül melyek relevánsak. Ehhez három vektort használ: a lekérdezést, a kulcsot és az értéket. A rendszer a korábbi tokenek kulcs- és értékvektorait egy KV cache-ben tárolja, így a kontextus bővülésével a memóriaigény is növekszik.
Az Amazon Science szerint a különböző rétegek eltérő feladatokat végeznek. Egyesek több tízezer tokenen átívelő keresést hajtanak végre, míg mások inkább helyi műveleteket végeznek. Az előbbieknek szükségük lehet a múlt tokenjeinek pontos megőrzésére, az utóbbiaknál viszont elegendő lehet egy rögzített méretű összefoglaló állapot.
A Priming előtanított súlyokra épít
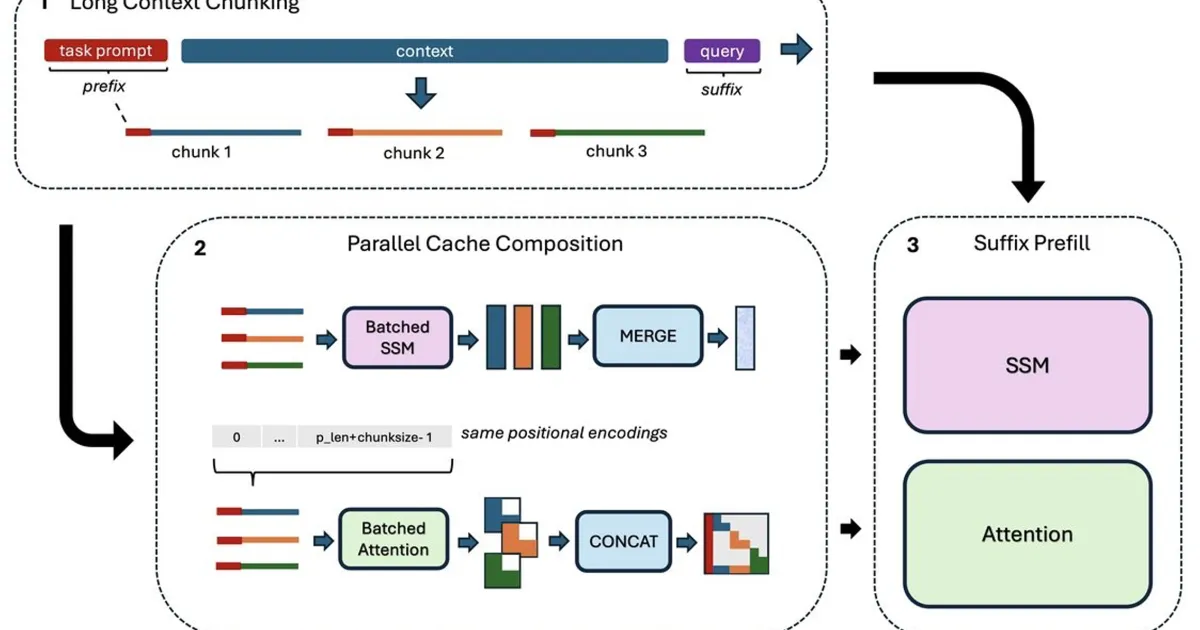
A hibrid modellek a figyelmi rétegeket és az állapottér-modelleket kombinálják. Az állapottér-modellek a teljes előzményt egy rögzített méretű állapotba tömörítik, ezért kisebb memóriaigényt kínálhatnak, miközben a figyelmi rétegek ott maradhatnak, ahol szükség van a pontos, hosszú távú visszakeresésre.
Eddig az új hibrid konfigurációk összehasonlításához minden változatot a nulláról kellett előtanítani. Ez az Amazon szerint trilliónyi token és több százezer GPU-óra felhasználását jelenthette. A Priming az előtanított Transformer súlyait használja kiindulópontként, így csak az állapottér-rétegek saját paramétereit kell megtanítani.
Az eljárás három lépésből áll. Először kiválasztják azokat a rétegeket, amelyek rögzített méretű állapottal is megfelelően tömöríthetők. Ezután a megfelelő Transformer-rétegek súlyai alapján inicializálják az állapottér-rétegeket, majd rövid lepárlási folyamattal a lecserélt réteg viselkedéséhez igazítják őket. Végül a teljes hibrid modellt finomhangolják a következő token előrejelzésére.
A teljes folyamat a forrásmodell előtanításához felhasznált tokenmennyiség kevesebb mint 0,5 százalékát igényli. Az Amazon szerint a módszer Qwen, Llama és Mistral Transformer-családokon, sűrű és MoE-modelleken, valamint 8 milliárd és 32 milliárd paraméteres méretekben, illetve ennél nagyobb léptékben is működik.
A vizsgált modellek és a közzétett eredmények
Az Amazon kutatói három állapottér-modellcsaládot hasonlítottak össze: a Gated KalmaNetet, a Gated DeltaNetet és a Mamba-2-t. A vállalat által ismertetett, kontrollált összevetésben a Gated KalmaNet, röviden GKA teljesített a legjobban, ezt követte a Gated DeltaNet, majd a Mamba-2.
Az Amazon szerint a GKA különlegessége, hogy újratanítás nélkül változtatható hosszúságú következtetési számítást kínál, és közvetlen kontrollt ad a sebesség és a pontosság közötti kompromisszum felett. A kutatás másik megállapítása szerint az állapottér-modellek következetesen felülmúlták a csúszóablakos figyelmet, még akkor is, amikor ez utóbbi kétszer akkora memóriakeretet kapott.
Egy 32 milliárd paraméteres, GKA-alapú hibrid modell az Amazon beszámolója szerint a következtetési benchmarkokon elérte a forrásul szolgáló Transformer szintjét. 128 000 tokenes kontextus mellett a dekódolás akár kétszer gyorsabb volt, a helyes válaszok pedig akár a korábbi falióra-idő kétharmada alatt megszülettek.
Kutatási eszközök és modellek az Apache 2.0 licenc alatt
Az Amazon Web Services a további kutatások támogatására közzétett egy hibridmodell-gyűjteményt 8 milliárd és 32 milliárd paraméteres méretben. A modelleket hosszú kontextusú következtetésre és utasításkövetésre szánják.
A csomag a modellek mellett tanítókódot, optimalizált kerneleket és egy vLLM-kiszolgáló bővítményt is tartalmaz. A közzétett anyagok Apache 2.0 licenc alatt érhetők el. Ez lehetőséget ad a fejlesztőknek és kutatóknak arra, hogy azonos kiindulópontból vizsgálják a rétegtípusokat, a hibrid modellek arányát és a rétegek elhelyezését, a nulláról induló előtanításnál jóval kisebb képzési költség mellett.
Amazon Science: Can we change an AI model’s architecture without retraining it from scratch?