Az Anyscale szerint 90 százalékkal csökkenthető a kódoló ügynökök költsége
Az Anyscale olyan útmutatót tett közzé, amelyben a kódoló ügynökök saját GPU-kon történő futtatását mutatja be Ray és vLLM segítségével. A vállalat költségmodellje szerint az önálló kiszolgálás a használattól függően jelentősen olcsóbb lehet a tokenalapú API-knál.
- Az Anyscale szerint az önálló kiszolgálás költsége 17 és 58 dollár között lehet fejlesztőnként havonta.
- A költségmodell 50 fejlesztő és egy megosztott GPU használatával számol.
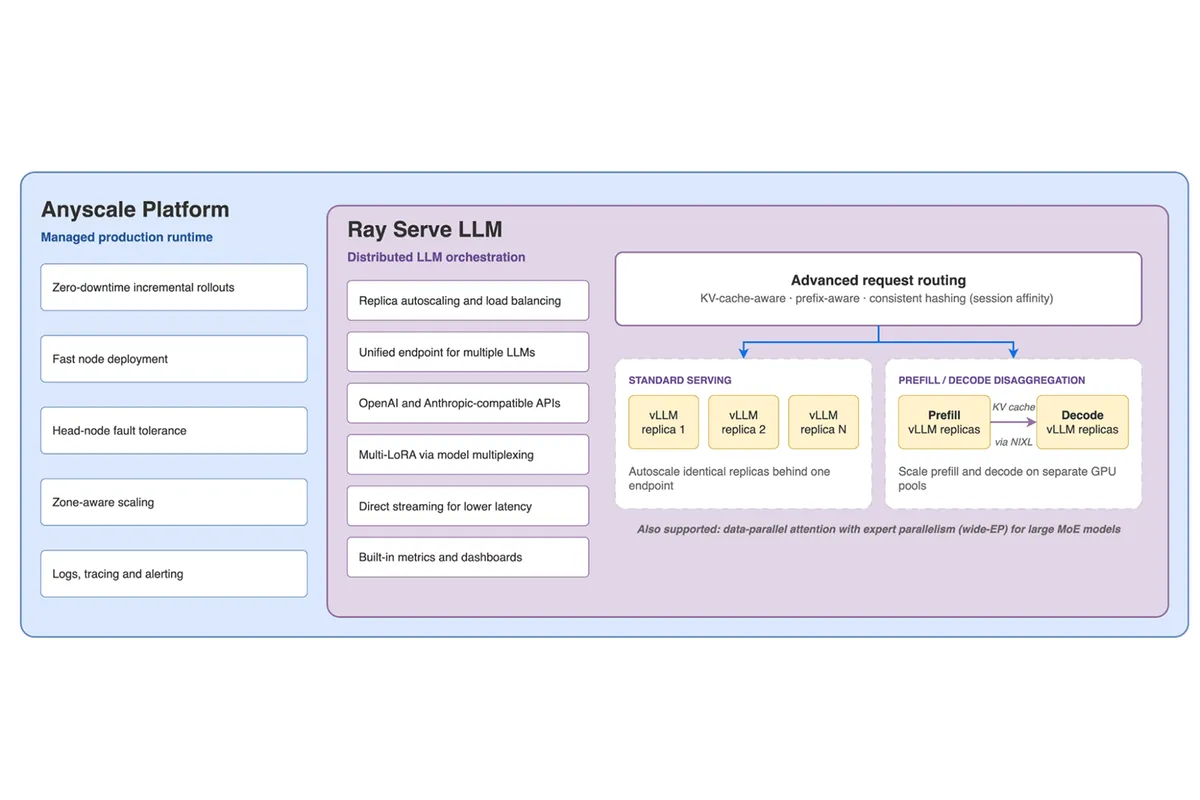
- A Ray Serve LLM a vLLM-re építve útválasztást, skálázást és kompatibilis API-végpontokat biztosít.
- Az Anyscale méréseiben a KV-gyorsítótár és a CUDA-grafikonok jelentősen javították a teljesítményt.
- A mintakód Claude Code, Codex és Cursor csatlakoztatását is bemutatja.
A kódoló ügynökök nagy mennyiségű kontextust küldenek
Az Anyscale szerint a kódoló ügynökök minden műveletnél újra elküldhetik a repository kontextusát, az utasításokat, az eszközök eredményeit és a beszélgetési előzményeket. Ezek az adatok a forráskódot, belső dokumentumokat és architekturális döntéseket is tartalmazhatják, ezért a vállalat szerint fontos kérdés, hogy az üzemeltetési környezet a szervezet ellenőrzése alatt maradjon.
A szolgáltatás saját futtatókörnyezetben történő működtetése az Anyscale értelmezésében azt is lehetővé teszi, hogy a csapat megőrizze a kódot, a nyomkövetési adatokat és a használati információkat. Ezeket jóváhagyás után később adat-előkészítésre és a modellek csapatra szabott utóhangolására is fel lehet használni.
A munkaterhelés jellemzően előfeldolgozás-intenzív. A bemenetek hosszúak, miközben a válasz gyakran csak egy rövid eszközhívás vagy kódszerkesztés. A kódoló ügynökök ráadásul több fordulón keresztül sokszor ugyanazt a kontextust küldik el, ami lehetőséget ad az automatikus prefix KV-gyorsítótár újrahasznosítására.
A költségmodell szerint már 8 fejlesztőnél megérheti
Az Anyscale költségmodellje három forgatókönyvet hasonlít össze. A folyamatosan bekapcsolva tartott önálló kiszolgálás havonta körülbelül 2920 dollárba kerülhet, ami 50 regisztrált fejlesztő mellett nagyjából 58 dollárt jelent fejlesztőnként. Ha a rendszer csak munkaidőben működik, a becslés körülbelül 840 dollár havonta, illetve 17 dollár fejlesztőnként.
Összehasonlításként a vállalat egy aktív fejlesztő esetében körülbelül 800 dolláros havi, Claude Code API-hoz kapcsolódó költséggel számol. A kalkulációk nagyjából 4 dolláros GPU-csomópont-óradíjat feltételeznek RTX PRO 6000 használata mellett, egy GPU megosztásával 50 regisztrált fejlesztő között. Az Anyscale hangsúlyozza, hogy ezek tervezési előrejelzések, nem teljes tulajdonlási költségszámítások.
A cég szerint a saját GPU-k megosztása lehetővé teszi, hogy a költségek kevésbé kövessék lineárisan a fejlesztők és a kérések számát. Az Anyscale a BMW példáját is említi, amelynél a vállalat állítása szerint már 8 fejlesztő mellett kedvezőnek bizonyult az API-ról házon belüli következtetésre váltás költség-haszon aránya.
Ray Serve LLM és vLLM együtt kezeli a kiszolgálást
Az útmutatóban a vLLM végzi az alapvető következtetést, betölti a modellt a GPU-kra és előállítja a tokeneket. A Ray Serve LLM a replikák összehangolásáért, a kérések útválasztásáért és a terheléselosztásért felel, valamint OpenAI- és Anthropic-kompatibilis végpontokat biztosít.
Az Anyscale Platform a kezelt futtatókörnyezetet adja hozzá. A platform GPU-kat biztosít, automatikusan méretezi a csomópontokat, akár nullára is, továbbá naplózást, nyomkövetést, riasztásokat, hibatűrést és leállás nélküli frissítéseket kínál. A Ray Serve LLM emellett támogatja a gyorsítótár állapotára épülő útválasztást, a közvetlen tokenstreamelést és az összetett, több csomópontos telepítéseket.
Az Anyscale által közölt mérésekben a fordítási gyorsítótár visszaállítása 8-szoros gyorsulást eredményezett. Egy NVFP4, MTP nélküli beállításban a fordítási idő 48,5 másodpercről 6 másodpercre csökkent. Egyetlen replikás GLM-5.2 értékelésben a 512 GiB-os CPU KV-gyorsítótár a gyorsítótárazott prompttokenek arányát 6,1 százalékról 74,9 százalékra növelte 58 gyakori prompt mellett, a medián TTFT pedig 48,4 másodpercről 9,2 másodpercre esett.
A vállalat további eredményei szerint a többtokenes előrejelzés, vagyis az MTP, 65-ről 121 token/másodpercre növelte a kimeneti áteresztőképességet. A CUDA-grafikonok használata kliensoldali mérésben 15,9-ről 45,6 token/másodpercre emelte a tokenkibocsátást a késleltetett végrehajtási módhoz képest.
Három kódoló klienshez készítettek mintát
Az Anyscale a megoldás reprodukálásához kódtárat is létrehozott. Ennek öt része egy alap Anyscale-szolgáltatás telepítését és ellenőrzését, a Claude Code, a Codex és a Cursor csatlakoztatását, a GPU-használat és a gyorsítótárazás hangolását, a nyílt modell és a Claude közötti LiteLLM-alapú útválasztást, valamint a csapat számára beállítható automatikus telepítést mutatja be.
A három kliens eltérő API-útvonalakat használ: a Cursor a /v1/chat/completions, a Claude Code a /v1/messages, a Codex pedig a /v1/responses végpontot. Az útmutató szerint a saját modell üzemeltetése csökkentheti a szolgáltatói korlátoktól való függést, nagyobb kontrollt adhat a kapacitás és a sorok felett, valamint mérsékelheti a modellbeszállítóhoz kötődést.
Az Anyscale szerint az üzemeltetéshez a feladathoz illő modellt és hardvert kell kiválasztani, majd beállítani a vLLM motort és a Ray Serve telepítést. A modellek összehasonlításánál a vállalat többek között a SWE-bench, a Terminal-Bench, a Toolathlon, a τ-bench, a CyberGym és a GDPval-AA v2 mérőszámait említi, miközben arra figyelmeztet, hogy a pontszámok gyakran a teljes ügynökrendszert tükrözik, nem csak a modellt.