Bizonytalan eszközválasztásnál visszaadja a döntést az AI-agentnek az Arize
Az Arize AI olyan módszert mutatott be az AI-agentek eszközválasztásának javítására, amely a döntési modell bizonytalanságát is figyelembe veszi. A 0,7 alatti konfidenciájú döntéseknél visszaadták a választást a csevegőmodellnek, így a tesztben 21-ről 3-ra csökkent az üres vagy befejezetlen válaszok száma.
- Az Arize külön döntési modellel választotta ki az agent által használt eszközt.
- A Phoenix minden eszközválasztást külön DECISION spanben jelenít meg.
- 0,7 alatti konfidenciánál a csevegőmodell döntött újra az eszközről.
- Az üres vagy befejezetlen válaszok száma 21-ről 3-ra csökkent.
- A tesztben a kapuzott változat 92 százalékos helyes eszközhívási arányt ért el az értékelő szerint.
Különválasztották az eszköz kiválasztását és használatát
Az Arize AI szerint a legtöbb agent egyetlen modellhívásban oldja meg az eszközhasználatot. A csevegőmodell elolvassa a beszélgetést, kiválasztja a használni kívánt eszközt, majd kitölti a hozzá tartozó argumentumokat. A nyomkövetés általában megmutatja, melyik eszközt hívta meg a modell, milyen argumentumokat adott át, és mi lett az eredmény. Azt viszont nem mutatja meg, milyen más lehetőségeket mérlegelt, illetve mennyire volt biztos a választásában.
Az Arize kísérletében a kiválasztási feladatot egy külön döntési modellre bízták. Ez a modell több lehetőséghez valószínűséget ad, szöveget azonban nem generál. A csevegőmodell ezután megtartja a másik feladatot: meghívja a kiválasztott eszközt, és kitölti annak argumentumait. A tesztben az OpenAI Decisions API-ját használták, a routerként említett döntési modell pedig az OpenAI gpt-6-luna volt.
Az Arize Phoenix ehhez új, DECISION nevű span-típust támogat. Minden eszközválasztás saját spanen jelenik meg, benne az elutasított lehetőségek valószínűségével is.
Háromféle agentet mértek ugyanazokon a kérdéseken
A vizsgálatban a Wonder Toys nevű demó játékáruház agentje szerepelt. Az agent öt eszközt használhatott: katalóguskeresést, egy termék megjelenítését, vásárlást, rendelés ellenőrzését és rendelés törlését.
Az Arize 100, vásárlói üzenetként megfogalmazott tesztet futtatott le az agenten. Három változatot hasonlítottak össze, amelyek ugyanazt a promptot, ugyanazt az öt eszközt és ugyanazt a csevegőmodellt használták. Az első változatban maga a csevegőmodell választotta ki az eszközt. A másodikban a döntési modell választását mindig kikényszerítették. A harmadik, kapuzott változat csak akkor használta a döntési modell választását, ha annak konfidenciája legalább 0,7 volt, ez alatt a csevegőmodell döntött.
Minden változat minden üzenetet háromszor kapott meg, így összesen 900 fordulót vizsgáltak. Az elsőként helyesnek jelölt eszközhívás aránya a három változatnál 78, 95 és 91 százalék volt. Az értékelő által helyesnek ítélt eszközhívások aránya 79, 89 és 92 százalékot ért el. A fordulónkénti medián idő 6,5, 5,6, illetve 7,1 másodperc, a költség pedig 0,0217, 0,0210 és 0,0220 dollár volt.
A 0,7 alatti konfidencia több hibával járt
A 100 tesztüzenet alapján a 0,7 alatti konfidenciájú választások körülbelül minden harmadik esetben rossz irányba vitték az agentet. A 0,7 és 0,8 közötti tartományban ez körülbelül minden hatodik esetben történt meg, 0,8 felett pedig tízből kevesebb mint egyszer.
Az Arize erre egy egyszerű szabályt épített: 0,7 alatti konfidencia esetén figyelmen kívül hagyták a router választását, és a csevegőmodellre bízták az eszköz kiválasztását. A mindig kikényszerített routerváltozathoz képest az üres vagy befejezetlen válaszok száma 21-ről 3-ra csökkent, változatonként 300 fordulóban. Az eredeti agent, amely saját maga választotta ki az eszközeit, ebben a tesztben egyetlen üres vagy befejezetlen választ sem adott.
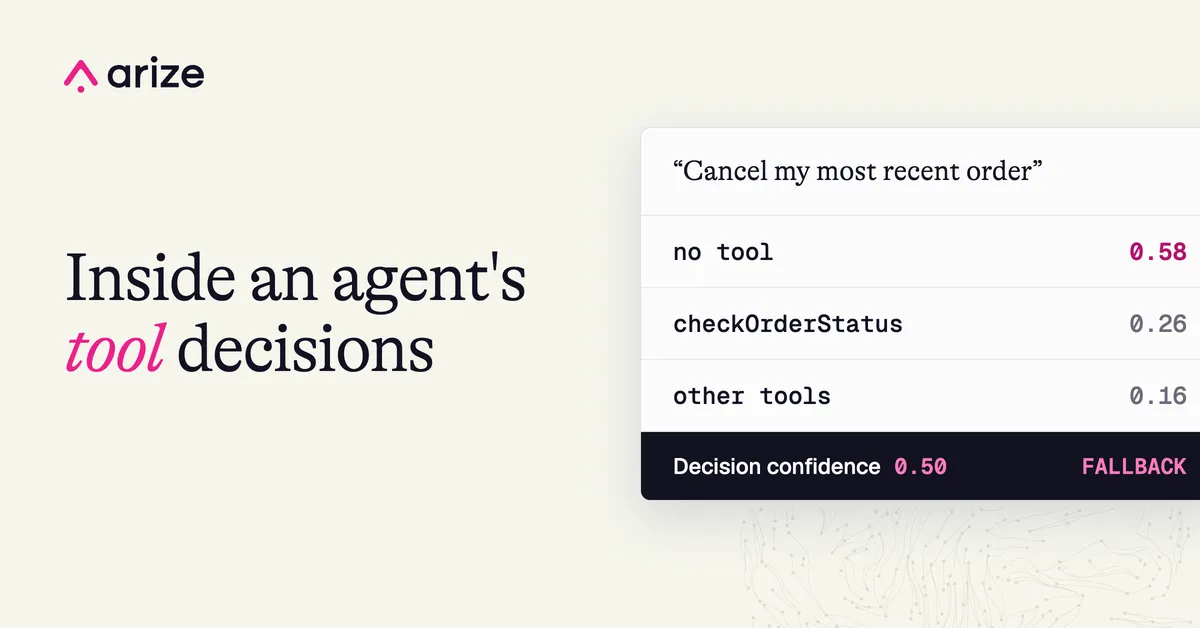
Az egyik példa a „Cancel my most recent order” üzenet volt. A router leginkább azt valószínűsítette, hogy nem kell eszközt hívni, ennek valószínűsége 0,58, a rendeléslekérdezésé pedig 0,26 volt. A döntés konfidenciája 0,50 lett. A mindig kikényszerített változatban a csevegőmodell nem hívhatott eszközt, ezért három alkalomból háromszor azt írta, hogy előbb megnézi a rendeléseket, majd megállt. A kapuzott változatban a 0,50-es érték a küszöb alatt maradt, ezért a csevegőmodell maga választott, meghívta a checkOrderStatus eszközt, és folytatta a rendelés feldolgozását.
A Phoenixben külön látható a döntés és az eredmény
Az Arize hangsúlyozza, hogy a konfidencia önmagában azt mutatja meg, mennyire volt biztos a router, azt nem, hogy sikeres lett-e az egész forduló. Ezért minden fordulót értékeltek, majd az eredményeket annotációként a nyomkövetéshez kapcsolták.
Kétféle értékelést használtak. Egy nyelvi modell azt vizsgálta, hogy a felhasználói kéréshez, az elérhető eszközökhöz és a tényleges hívásokhoz képest helyesek voltak-e az eszközhívások. A véletlenszerűség mérséklésére minden fordulót háromszor értékeltettek, és azt a döntést fogadták el, amellyel legalább két értékelés egyetértett. Emellett kódalapú ellenőrzést is futtattak: előre megadták, melyik eszközt kellene elsőként meghívni az egyes üzeneteknél, majd összevetették ezt a tényleges első hívással.
A két eredmény külön diagnózist ad. Ha mindkettő hibát jelez, akkor valószínűleg maga az eszközválasztás volt a probléma. Ha csak az értékelő szerint hibás a forduló, a kiválasztott eszköz megfelelő lehetett, és az argumentumok vagy a válasz okozhatta a hibát. A Phoenixben az annotációk alapján ezek a fordulók szűrhetők, a döntési spanek pedig közvetlenül megmutatják, melyik választás mennyire volt biztos.
A módszer az Arize szerint arra ad gyakorlati mintát, hogy az agentek fejlesztői saját tesztüzeneteiken keressék meg a megfelelő küszöbértéket. A bemutatott rendszerben 0,7 felett a router döntését fogadták el, ez alatt pedig visszaadták a választást a csevegőmodellnek.
Arize AI: AI agent tool selection: The tool your agent almost called