Nyolc döntési modellt tesztelt az Arize, szoros eredmények születtek
Nyolc döntési modellt hasonlított össze az Arize AI hallucinációk felismerésében, nyelvi modellek értékelésében és ügynökök útválasztásában. A modellek pontossága közel alakult egymáshoz, a sebesség, a költség és a telepítés módja viszont jelentősen eltért.
- Az Arize nyolc döntési modellt vetett össze három feladaton.
- A Jev 85,5 százalékos pontossággal nyerte a RAGTruth-fordulót.
- A Kev 76,8 százalékos eredménnyel megelőzte a Laya 59,8 százalékát.
- A Jev és a Liquid döntetlenre végzett a Phoenix értékelési fordulójában.
- A teszt a pontosság mellett a sebességet és az 1000 döntésre jutó költséget is mérte.
Egyre több döntési modell jelent meg
A döntési modell kérdést és rögzített számú lehetőséget kap, majd minden lehetőséghez valószínűséget rendel. Szöveget nem ír, ezért a használatához nincs kimeneti tokenköltség, és a válaszra sem kell szöveggenerálásra várni. Az Arize szerint ez két feladatra teszi alkalmassá: egy ügynökön belüli döntésekre, például annak kiválasztására, hogy melyik eszközt vagy képességet használja, illetve értékelőként, amely egy rendszer működését pontozza.
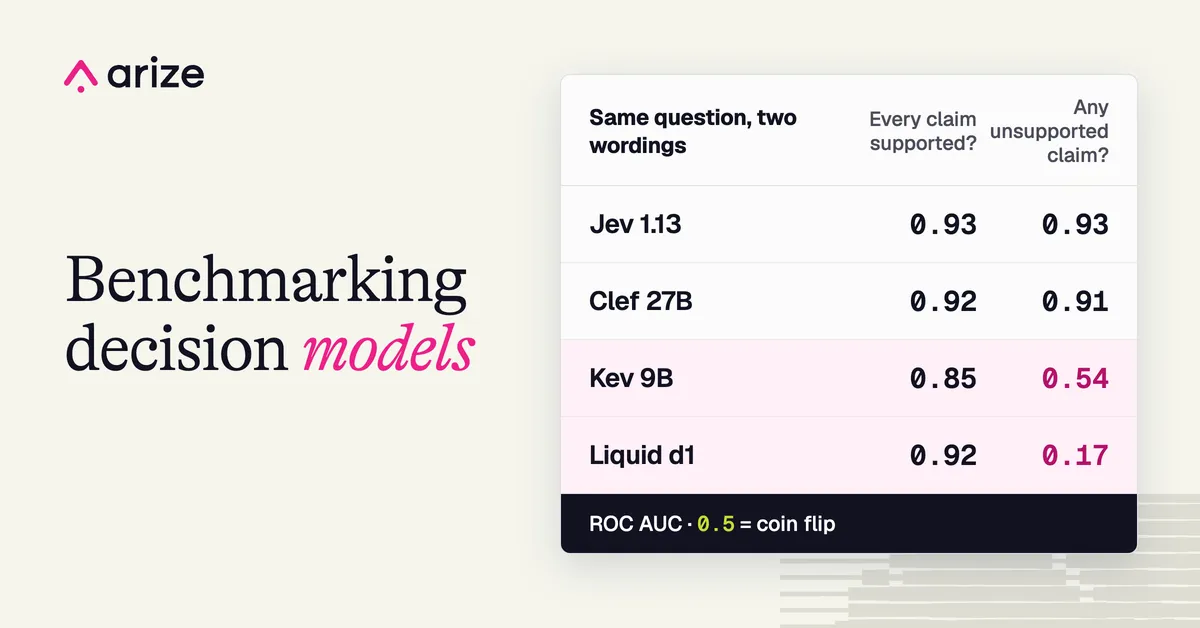
A TypeSafe szeptember 15-én adta ki a Jev modellt. Néhány héten belül az OpenAI, a Liquid, a Cloudflare, az AWS és a PostHog is bemutatott hasonló megoldást, miközben a Hugging Face-en megjelent a nyílt forrású Kev. Az Arize benchmarkjában a Jev 1.13, a Liquid d1, az OpenAI Decisions, a Cloudflare Clef 27B, a Kev 9B, a PostHog Jeeves, az AWS Strands Decider 2B és a Convai Innovations Laya modell szerepelt.
A modellek között vannak hosztolt API-k és helyben futtatható, nyílt modellek is. A Jev, a Liquid d1 és az OpenAI Decisions zárt szolgáltatás, míg a Clef 27B, a Kev, a Jeeves, a Strands Decider és a Laya helyben futtatható. Hét modell elfogadta a Jev által használt /v1/systemone kérésformátumot. Az OpenAI Decisions API ettől eltérően egyetlen, címkézett szövegtömböt és kérdéslistát használ, ezért az Arize az összehasonlításhoz saját szöveges elrendezést alkalmazott.
Három feladaton, kieséses rendszerben mértek
Az Arize két csoportba osztotta a mezőnyt. A felhős csoportban hálózaton keresztül elérhető API-k szerepeltek, a helyi csoportban pedig nyílt modellek futottak egy Apple M4 Max processzorral és 36 GB memóriával rendelkező MacBook Prón. A döntéseket pontosság, késleltetés és 1000 döntés költsége alapján értékelték. Egy párharcot az nyert meg, aki a három kategóriából legalább kettőben győzött. A pontosság csak akkor számított egyértelmű győzelemnek, ha a 95 százalékos konfidenciaintervallumok nem fedték át egymást.
A negyeddöntőben a RAGTruth 2675 sorát használták hallucinációészlelésre. A Jev 85,5 százalékos kiegyensúlyozott pontosságot ért el az OpenAI Decisions 81,5 százalékával szemben. A konfidenciaintervallumok érintkeztek, ezért ez a kategória döntetlen lett, a Jev viszont gyorsabbnak és olcsóbbnak bizonyult: döntésenként 0,08 másodpercet és 1000 döntésenként 0,045 dollárt mutatott, szemben az OpenAI 0,16 másodpercével és 0,090 dollárjával.
A Liquid d1 és a Clef 27B pontossága közel azonos volt, 84,8, illetve 85,2 százalék, a Liquid azonban gyorsabb és olcsóbb lett. A Kev 76,8 százalékos eredménnyel legyőzte a Laya 59,8 százalékát, míg a Jeeves 80,3 százalékot ért el a Strands Decider 69 százalékával szemben. A Laya volt a leggyorsabb, 0,04 másodperces döntésenkénti eredménnyel, mérete pedig egy gigabájt alatt maradt.
A Jev és a Liquid döntetlenre végzett az értékelésben
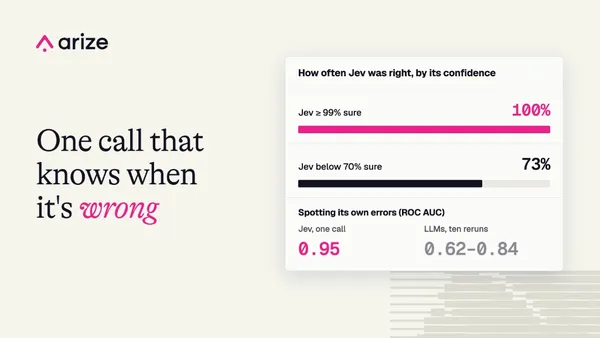
Az Arize Phoenix 13 értékelőkészlete, összesen 655 címkézett eset alapján vizsgálták, mennyire alkalmasak a modellek értékelőbíróként. A tesztek többek között a hűséget, a tömörséget, a toxicitást és az eszközhasználat kezelését mérték. A szerzők a kalibrációt is figyelték, vagyis azt, hogy a modell bizonyossága mennyire felel meg a tényleges pontosságának.
A felhős döntőben a Jev 91,1, a Liquid 87,6 százalékos eredményt ért el, de a konfidenciaintervallumok átfedtek. A Jev a sebességben, a Liquid a költségben nyert, így a döntést a kalibráció alapján kellett volna meghozni. A Jev kalibrációs hibája 0,023, a Liquidé 0,051 volt, és az Arize szerint mindkét eredmény kiválónak számított. A két modell végül nem volt elválasztható, ezért a felhős döntő döntetlennel zárult.
Az Arize korábbi összehasonlításában az Opus 5 hallucinációészlelésben 86,6 százalékos kiegyensúlyozott pontosságot ért el, 1000 ítéletenként 14,30 dolláros költséggel. A benchmark szerzői szerint a Jev, a Liquid és a Clef 27B ennek a pontosságnak a hibahatárán belül maradt, miközben költségük az Opus 5 árának töredéke volt. Az eredmények alapján a fejlesztőknek a pontosság mellett a válaszidőt, az üzemeltetési költséget és a telepítés módját is mérlegelniük kell.
Arize AI: Decision model benchmark: Jev, Kev, Liquid d1, and more