Új Azure AI Speech modell javítja a többnyelvű beszédfelismerést
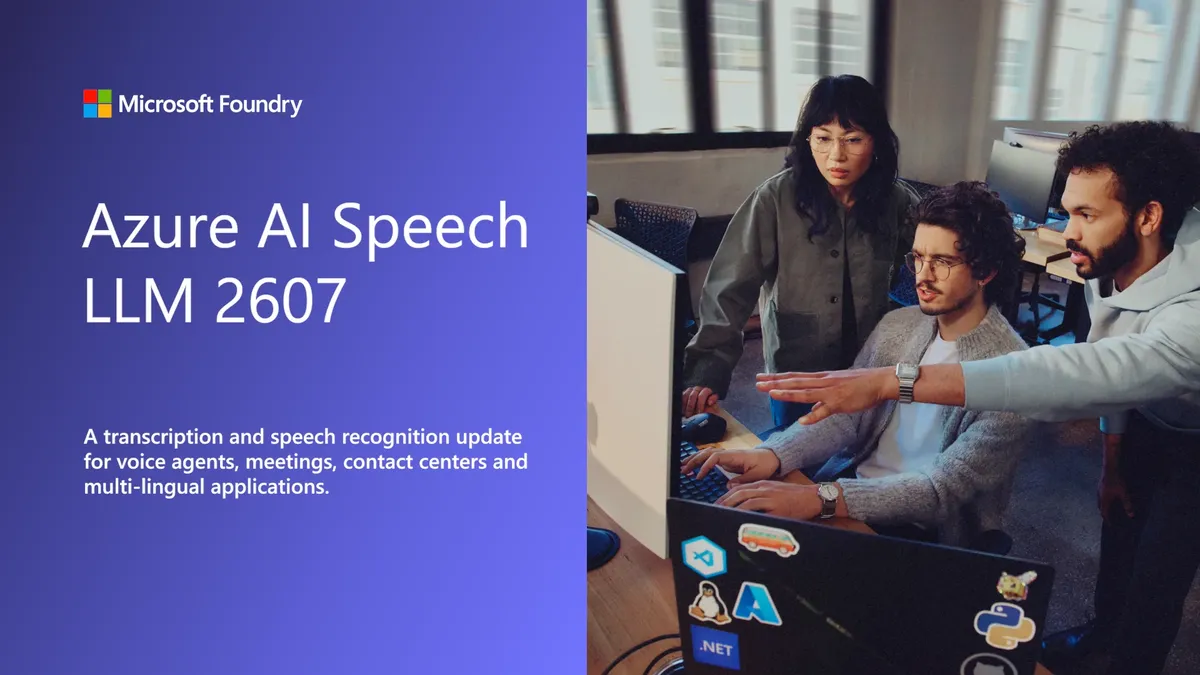
A Microsoft bemutatta az Azure AI Speech LLM 2607 modellt, amely pontosabban kezeli a többnyelvű és kevert nyelvű hanganyagokat. A frissítés a kifejezéslisták használatát is egyszerűsíti, miközben a vállalat szerint akár háromszor alacsonyabb késleltetést kínál az előző, 2605-ös kiadáshoz képest.
- Az Azure AI Speech LLM 2607 javítja a többnyelvű és kevert nyelvű hanganyagok felismerését.
- A Microsoft szerint a késleltetés akár háromszor jobb az előző, 2605-ös kiadásnál.
- A kifejezéslisták külön paraméterként adhatók meg, és több mint 2000 entitást tartalmazhatnak.
- A modell a Fast API-n keresztül érhető el átíráshoz és interaktív hangalapú alkalmazásokhoz.
- A szolgáltatásfrissítés automatikusan települ, ügyféloldali teendő nélkül.
Pontosabb felismerés több nyelven
A Microsoft Foundry szeptember 10-i bejelentése szerint az Azure AI Speech LLM 2607 a beszédfelismerési modell legújabb frissítése. A kiadás a többnyelvű felismerést és azokat a hanganyagokat célozza, amelyekben a beszélők egy beszélgetés közben nyelvet váltanak.
A vállalat belső értékelései alapján a modell javulást mutat a Tier 1 és Tier 2 nyelveknél, valamint a Tier 2 és Tier 3 nyelvi területeknél is. A Microsoft szerint robusztusabbá vált a nagybetűk, az írásjelek, illetve a számok és számjegyek átírása.
A fejlesztés a domainhez kapcsolódó entitások és személynevek felismerésére is kiterjed. Ez a gyakorlatban a nevek, márkák és technológiai kifejezések pontosabb rögzítését jelentheti a vállalat által ismertetett értékelések szerint. A Microsoft közlése alapján az LLM Speech 2607 a HuggingFace OpenASR ranglistáján a második helyen áll.
Egyszerűbbé vált a kifejezéslisták kezelése
A beszédfelismerő alkalmazások egyik gyakori problémája a szakterminusok, terméknevek, mozaikszavak, vállalatnevek és iparági kifejezések felismerése. Az LLM Speech 2607 ehhez külön paramétert biztosít a felhasználó által megadott kifejezéslistákhoz.
A fejlesztők így közvetlenül adhatják meg a felismeréshez fontos szavakat és kifejezéseket, anélkül, hogy az egyedi szókincset egy általános promptba kellene beágyazniuk. A Microsoft szerint ez egyszerűbbé, tisztábbá és éles környezetben könnyebben karbantarthatóvá teszi a testreszabást.
A kifejezéslisták több mint 2000 entitást is tartalmazhatnak. A Microsoft példái szerint a funkció használható vállalati terminológiához, műszaki terméknevekhez, iparági szókincshez, rövidítésekhez és az ügyfél által meghatározott kifejezésekhez.
Elérhető az API-kban, automatikusan érkezik
Az LLM Speech 2607 a Fast API-n keresztül érhető el, így a fejlesztők a frissítést átírási és interaktív hangalapú alkalmazásokban is használhatják. A Microsoft ilyen felhasználási területként említi a hangalapú ügynököket, az értekezletek átírását, az ügyfélszolgálati központokat és az online meetingalkalmazásokat.
A modell kipróbálható a Foundry Playground Azure Speech, Speech to Text felületén. A REST API-hoz és az SDK-khoz kapcsolódó használati módokról a Microsoft nyilvános dokumentációja ad további információt.
A frissítéshez az ügyfeleknek nincs külön teendőjük, mivel a Microsoft közlése szerint a szolgáltatásoldali telepítés automatikusan megtörténik. Az új modell így a meglévő alkalmazásarchitektúra módosítása nélkül hozhat minőségi és késleltetési javulást azokban a beszédfeldolgozási folyamatokban, amelyek több nyelvet vagy speciális szókincset kezelnek.
Microsoft Foundry: Announcing Azure AI Speech LLM 2607: Better Multilingual Accuracy, Easier Customization