A beszédfelismerők még elbuknak, ha más is beszél a háttérben
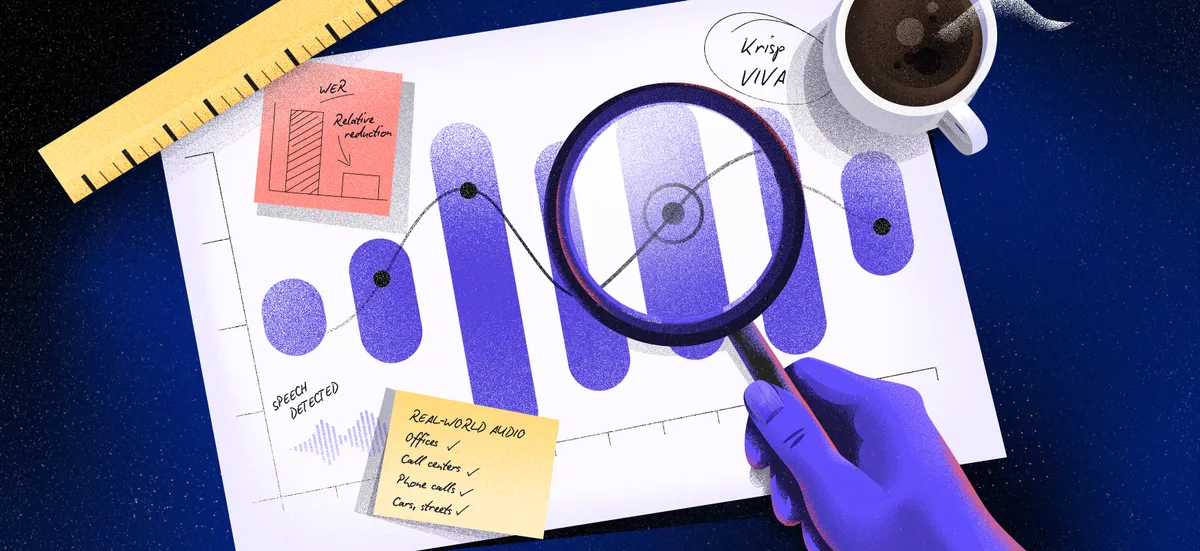
A modern beszédfelismerők jól kezelik a forgalom, a légkondicionáló és a billentyűzet zaját, de egy másik beszélő hangja továbbra is komoly hibákat okoz. A Krisp 265 valódi beszélgetésen mérte meg, hogyan változik 11 beszédfelismerő-konfiguráció pontossága a Voice Isolation használatával.
- A Krisp 265 valódi felvételen vizsgálta a háttérbeszéd hatását.
- A teszt 11 beszédfelismerő-konfigurációt és négy Voice Isolation modellt fedett le.
- A teljes korpuszon 73 százalékkal csökkent a szóhibaarány.
- Munkahelyi környezetben 31,84 százalékról 6,30 százalékra esett a hibaarány.
- Gyenge, háttérbeszéd nélküli telefonhangoknál az izoláció ronthatott az eredményen.
A másik beszélő hangja más típusú probléma
A Krisp szerint a zaj azért szűrhető viszonylag jól, mert nem hasonlít a felismerni kívánt beszédre. Egy másik ember hangja viszont ugyanazokat a jellemzőket hordozza, mint a fő beszélőé, ezért a beszéd kiemelése egy másik hang alól eltérő feladat a hagyományos zajszűréstől.
Ez különösen problémás lehet hangalapú ügynököknél. A háttérben beszélő személy szavai bekerülhetnek az átiratba, így a rendszer olyan információkra támaszkodhat, amelyeket a felhasználó nem mondott. Az is előfordulhat, hogy a rendszer a másik beszélőt azonosítja fő beszélőként, átadja neki a szót, félbeszakítja a felhasználót, vagy egy elhangzott kérdés nélkül válaszol.
Valódi irodákban és telefonhívásokban teszteltek
A Krisp saját benchmarkot készített, mert állítása szerint nem talált olyan iparági mérési rendszert, amely változatos, valós környezetekben vizsgálná a párhuzamos beszéd hatását. A három hónapos adatgyűjtési projektben minden felvétel valódi emberrel, valódi helyiségben és valódi eszközön készült. Szintetikus keverést és utólag hozzáadott zajt nem használtak.
Az adatbázis három fő helyzetet fed le: munkahelyi környezeteket, négy működő call center emeletet, valamint telefonhívásokat autóban, utcán, üzletben és metróban. A felvételek 24 audioeszközzel és 18 fejhallgatómodellel készültek. A legtöbb munkairodai és call centeres felvételen a fő beszélő megszólal, egy második beszélő bekapcsolódik, a fő beszélő elhallgat, majd visszatér. A legnehezebb szakasz az, amikor csak a másodlagos beszélő hallható, mert a helyes átirat ilyenkor üres.
Mind a 265 fájl kézzel ellenőrzött átiratot és JSON-metaadatot kapott. A szegmenseket négy címkével látták el: primary, mix, secondary és noise. Így külön mérhető, mi történik akkor, amikor csak a fő beszélő, mindkét beszélő, csak a háttérbeszélő, illetve egyikük sem beszél.
A Voice Isolation 73 százalékkal csökkentette a hibaarányt
A Krisp 11 konfigurációt futtatott kilenc beszédfelismerő-motoron, streaming és kötegelt feldolgozásban. Minden felvételt egyszer eredeti hangon, majd a négy Voice Isolation modell mindegyikén keresztül dolgoztak fel.
A teljes korpuszon a szóhibaarány 73 százalékkal csökkent. A munkakörnyezetekben az érték 31,84 százalékról 6,30 százalékra, a call centerekben pedig 23,83 százalékról 6,86 százalékra esett. A 11 konfiguráció mindegyike javult, és egyik sem romlott az eredeti hanghoz képest.
A javulás azonban nem minden helyzetben azonos. Gyenge sávszélességű, háttérbeszéd nélküli telefonhangoknál a Voice Isolation ronthat is az eredményen. A VI 2.5 Balanced ilyen esetekben 3,53 százalékos szóhibaarányt ért el, de egy felvételnél az érték 9,42 százalékról 21,65 százalékra nőtt.
A Krisp a benchmark adatállományát, a modellkimeneteket és az értékelési eszköztárat is közzéteszi. A vállalat szerint ez lehetővé teszi, hogy a fejlesztők olyan körülmények között vizsgálják a beszédfelismerő rendszereket, amelyekben a háttérben zajló valódi beszélgetések jelentik a fő kihívást.