Nullára csökkentette a train-rollout eltérést a vLLM ROCm-on
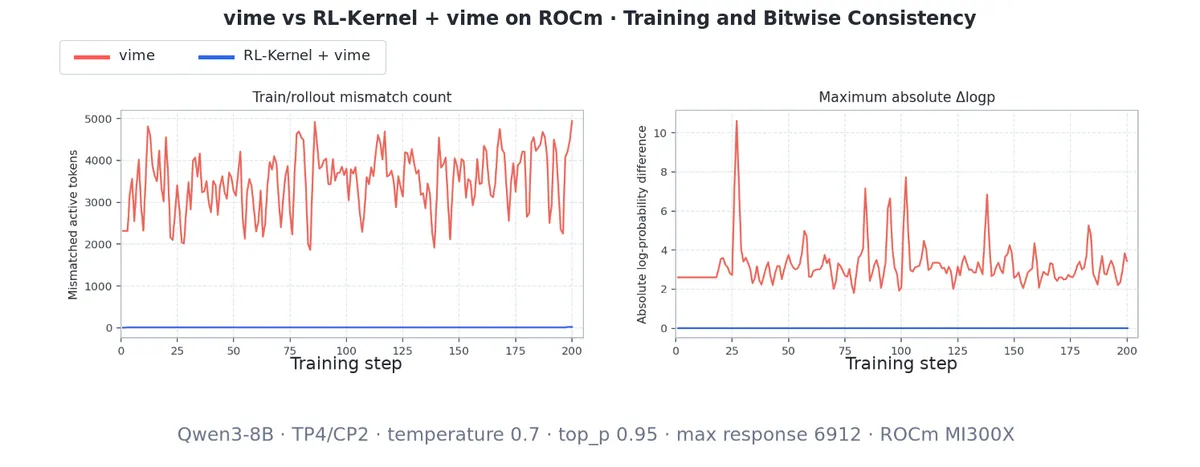
A vLLM, a vime és az RL-Kernel fejlesztői 200 egymást követő tanítási és rolloutlépésen át nulla eltérést mértek AMD Instinct MI300X GPU-kon. A Qwen3-8B kísérletben a mismatch_count és a max_abs_diff értéke végig nulla maradt.
- A Qwen3-8B kísérlet 200 lépésén át nulla eltérést mértek.
- A validáció egy 8 GPU-s AMD Instinct MI300X konfiguráción futott.
- A vime a folyamat időzítését és a súlyverziókat hangolja össze.
- Az RL-Kernel a logprob-számítás numerikus végrehajtását rögzíti.
- A natív vime minden vizsgált lépésben eltérést jelzett.
Miért térhet el ugyanaz a modell?
A megerősítéses tanítási folyamatokban gyakran külön végrehajtómotor dolgozik a modell tanításán és a válaszok generálásán. Emiatt ugyanazok a súlyok és bemenetek is eltérő logprobértékeket adhatnak. A különbséget okozhatja többek között a GPU-kernelfelépítése, a párhuzamosítás, a részösszegek összevonási sorrendje vagy a köztes számítási pontosság.
A vLLM szerint ez hatással lehet az importance ratio értékére, a rollout és a tanítás közötti KL-diagnosztikára, valamint a clippingre. A cél ezért az volt, hogy a rollout során rögzített token logprobját a tanítási oldal ugyanazzal a súlyverzióval, bitről bitre azonos numerikus végrehajtással számolja újra.
A fejlesztők ezt numerikus végrehajtási szerződésként írják le. Ebbe tartozik, hogy mely értékek vesznek részt a számításban, hogyan osztják fel és egyesítik a redukciókat, milyen pontosságot használnak az egyes köztes eredményeknél, hol történik kerekítés, és milyen matematikai primitíveket alkalmaznak.
A vime és az RL-Kernel eltérő feladatot kapott
A vime a teljes tanítási idővonalat hangolja össze. Nyilvántartja, melyik tokenköteg melyik lépéshez tartozik, melyik súlyverzió generálta az adatot, mely rolloutrekord kerül az adott frissítésbe, és mikor szinkronizálják az új súlyokat a vLLM-mel.
Az RL-Kernel ezzel párhuzamosan a numerikus végrehajtást igazítja össze. A strict path rögzíti az RMSNorm, az Attention, a GEMM, a SwiGLU, a lineáris logprob-számítás és a megosztott kollektív műveletek fontos határait. A megoldásnak nem kell minden memórialayoutot és ütemezési szabályt közösre cserélnie, amíg ezek nem módosítják az összehasonlított eredmények numerikus jelentését.
A ROCm-hoz a fejlesztők többek között determinisztikus, MFMA-alapú GEMM-kernelokat, szókincscsökkentést és HIP IPC-kommunikációt adtak hozzá. Rögzítették az AITER és CK Attention végrehajtási ütemezését, kezelték a matematikai függvények és a fordítói fúzió által okozott utolsó bites eltéréseket, valamint javították a lapozott KV-gyorsítótár és a HIP Graph újrajátszásának állapotkezelését.
200 lépésen át nulla eltérés
A 2026. szeptember 14-én közzétett beszámoló szerint a teljes vime-folyamatban, a Megatron tanítási és a vLLM rolloutoldal összekapcsolásával, 200 lépéses ROCm-validációt hajtottak végre. A kísérletben Qwen3-8B modellt és BF16 pontosságot használtak egyetlen, 8 darab AMD Instinct MI300X 192GB GPU-t tartalmazó gépen.
A Megatron konfigurációja TP4, CP2 és PP1 volt, a rolloutot két, egyenként TP4-es vLLM-motor végezte. A vizsgálat 200 rollout- és tanítási lépést, a dapo-math-17k adatkészletet, 1234-es tanítási és rolloutmagot, promptonként nyolc mintát, globálisan nyolcas köteget, valamint legfeljebb 6912 tokenes választ használt.
A szigorú útvonalon mind a mismatch_count, mind a max_abs_diff nulla maradt mind a 200 lépésben. A vLLM szerint a natív vime ezzel szemben minden lépésben eltérést jelzett az összehasonlításban. A forrás alapján az eredmény azt mutatja, hogy a vime és az RL-Kernel együtt ellenőrizhető, bitpontos train-rollout egyezést tud fenntartani AMD ROCm környezetben.