A vLLM különválasztaná a promptfeldolgozást és a tokenek generálását
A vLLM új útmutatója azt mutatja be, hogyan választható szét a nagy nyelvi modellek kiszolgálásában a promptok feldolgozása, a tokenek generálása és a CPU-s előfeldolgozás. A megközelítés javíthatja a késleltetést nagy terhelés mellett, de csak akkor, ha a köztes KV-gyorsítótár továbbítása kellően gyors.
- A vLLM különválasztja a prefill és decode fázist.
- A KV-gyorsítótár gyors továbbítása nélkül a TTFT romolhat.
- A különválasztás nagy terhelésnél csökkentheti az ITL kiugrásait.
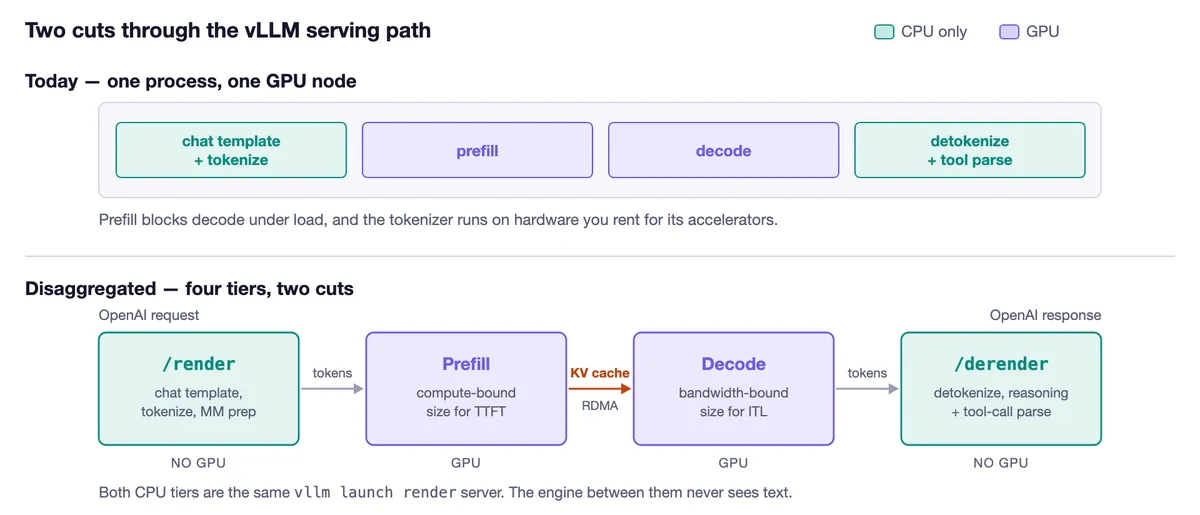
- A tokenizálás és a válaszértelmezés külön CPU-s render rétegre helyezhető.
- A megoldás használatához vLLM 0.30.0 vagy újabb verzió kell.
Egy folyamatban ütközik három különböző feladat
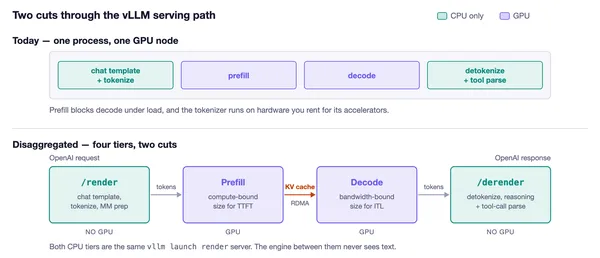
A vLLM 2026. szeptember 29-én közzétett bejegyzése szerint egy hagyományos vllm serve folyamat három, eltérő természetű munkát végez. A prefill a teljes promptot dolgozza fel egy menetben, elsősorban számításigényes, és ez határozza meg az első tokenig eltelt időt, vagyis a TTFT-t.
A decode ezzel szemben egyszerre egy tokent állít elő. Teljesítményét főként az befolyásolja, hogy a GPU milyen gyorsan tudja beolvasni a modell súlyait a memóriából, ez határozza meg a tokenek közötti késleltetést, az ITL-t. Ha a két fázis ugyanazon a GPU-n fut, egy hosszú prompt feldolgozása közben a már válaszoló kérések tokenfolyamai is akadozhatnak.
A harmadik feladatcsoport CPU-n fut: ide tartozik a chatsablonok kezelése, a tokenizálás, a detokenizálás, valamint a gondolkodási és eszközhívási válaszok értelmezése. A vLLM szerint ezek a munkák gyakran olyan gépen zajlanak, amelyet elsősorban a gyorsítói miatt bérelnek.
A KV-gyorsítótár továbbítása a kulcskérdés
A különválasztott kiszolgálásban a prefill és a decode külön példányként fut. A két réteg között a KV-gyorsítótár mozog, amely a prompt tokenjeihez tartozó figyelmi kulcsokat és értékeket tartalmazza. A vLLM példája szerint a Llama-3.1-70B BF16 formátumban tokenenként 320 KiB adatot tárol, így egy 10 ezer tokenes prompt körülbelül 3 GB-nyi KV-adatot ad át a decode rétegnek.
A bejegyzés szerint ennek továbbítására általában RDMA-t használnak. A vLLM ökoszisztémájában több mint egy tucat csatlakozó érhető el, köztük a NIXL, az LMCache, a Mooncake, a FlexKV és az AMD MoRI-IO megoldása, valamint az ezeket láncoló MultiConnector.
A vLLM két NVIDIA L40S GPU-val végzett mérésében a különválasztott prefill és decode réteg p99-es ITL-je 0,2 és 2 kérés közötti terhelésnél 25 és 52 milliszekundum között maradt. Az együtt futó konfigurációnál ugyanez az érték 23 milliszekundumról 169 milliszekundumra nőtt már 0,4 kérés másodpercenkénti terhelésnél, majd 263 milliszekundumot ért el 2 kérésnél.
A megoldásnak ugyanakkor ára van. Ugyanezen a tesztgépen, amely nem támogatta a GPU-k közötti közvetlen másolást, egy 8 ezer tokenes prompt KV-gyorsítótárának továbbítása körülbelül 1,3 másodpercet vett igénybe. Emiatt a különválasztott konfiguráció medián TTFT-je 2,2 másodperc volt, szemben az együtt futó rendszer 0,7 másodpercével.
Mikor ajánlja a vLLM a szétválasztást?
A vLLM szerint a cél elsősorban nem a csúcsteljesítmény növelése, hanem az úgynevezett goodput javítása. Ez azt mutatja meg, hány kérést lehet kiszolgálni úgy, hogy azok egyszerre teljesítsék a TTFT-re és az ITL-re vonatkozó célokat. A prefill és a decode külön méretezhető, így az előbbi számításigényesebb, az utóbbi pedig nagyobb kötegelt feldolgozásra optimalizálható.
A különválasztás főként akkor lehet indokolt, ha a termelési terhelés mellett az ITL p99 értéke nem teljesíti a szolgáltatási célokat, illetve ha sok hosszú prompt érkezik nagy párhuzamosság mellett. Növekvő kontextusú chatbotoknál és ügynöki folyamatoknál a vLLM kétirányú átvitelt, valamint KV-kiszervezést vagy megosztott gyorsítótárat, például LMCache-et vagy Mooncake-ot javasol.
A CPU-s render réteg különválasztása a /render és /derender végpontokkal történik. Az első OpenAI-kérést alakít tokenazonosítókká, a második pedig a generált tokenekből állít elő megfelelő OpenAI-választ, külön kezelve a tartalmat, a gondolkodást és az eszközhívásokat. A vLLM útmutatója szerint egy 9 ezer tokenes chatprompt sablonkezelése és tokenizálása körülbelül 15 milliszekundum CPU-időt igényelt, egy renderkiszolgáló pedig 73 kérés/másodperc sebességet ért el valamivel több mint egy processzormaggal.
A projekt a vLLM 0.30.0 vagy újabb verzióját feltételezi. Alacsony, szakaszos vagy késleltetésre kevésbé érzékeny terhelésnél továbbra is az együtt futó kiszolgálást ajánlja, és azt is javasolja, hogy a KV-átvitelt még a részletes teljesítménymérés előtt ellenőrizzék.