A Cartesia szerint a H-Net akár ötször hatékonyabb lehet
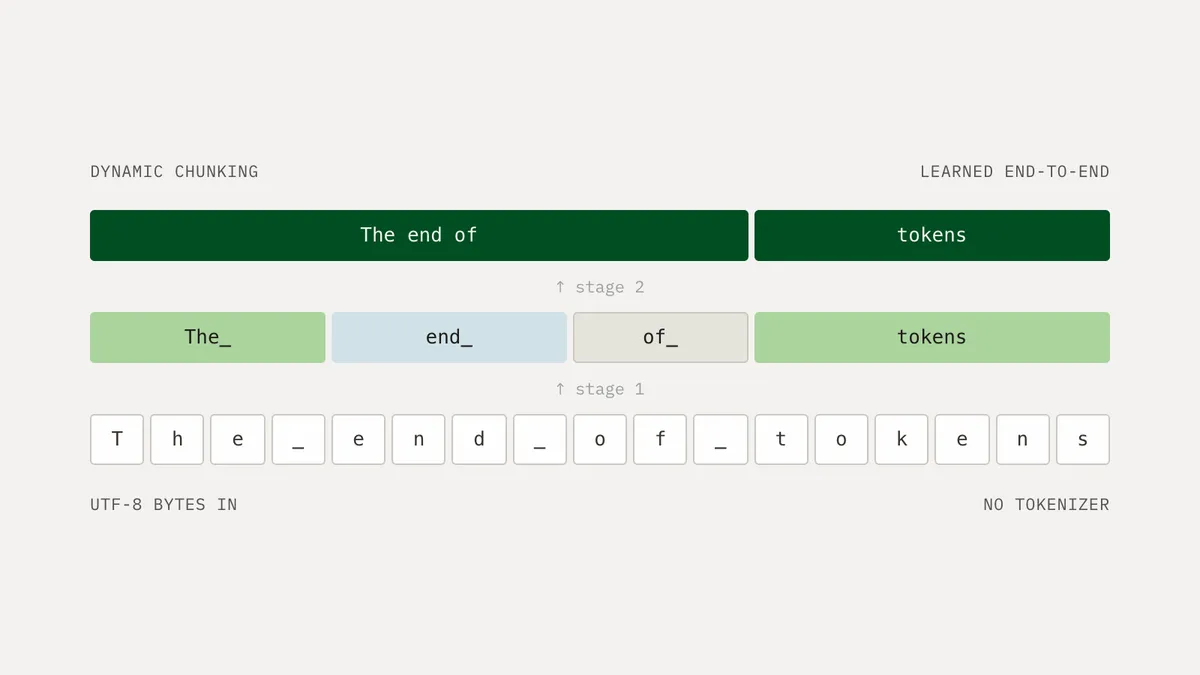
A Cartesia új kutatása szerint a hierarchikus hálózatok, vagyis a H-Nets, a hagyományos tokenizált nyelvi modelleknél hatékonyabban tanulhatnak közvetlenül bájtszintű adatokból. A vállalat mérései szerint az ellenőrzött, egylépcsős H-Nets akár 3-5-szörös számítási hatékonysági előnyt is elérhetnek.
- A H-Net közvetlenül a modellben, dinamikusan csoportosítja a bájtszintű adatokat.
- A Cartesia szerint az egylépcsős H-Nets akár 3-5-szörös számítási hatékonysági előnyt érhetnek el.
- Egy kétlépcsős H-Net a cég állítása szerint 10-szer kevesebb számítással és adattal is jobb eredményt ért el egy nyílt forrású modellnél.
- A vállalat biológiai és képi alkalmazásokon is vizsgálja az architektúrát.
- A Cartesia a továbbfejlesztett H-Net-technológia kiadását tervezi.
A tokenizálás helyett a modell tanulja meg a darabolást
A mai nyelvi modellek jellemzően nem közvetlenül a szöveget dolgozzák fel. A bemenetet először tokenekre bontják, amelyek egy rögzített szókészlet elemei. A gyakori Byte Pair Encoding, vagyis BPE, a 256 bájtból indul ki, majd a leggyakrabban előforduló szomszédos tokenpárokat ismételten összevonja egy előre meghatározott méretű szókészlet eléréséig.
A Cartesia által használt adatmixel egy BPE-token átlagosan 4,57 bájtot fed le, így a modellnek rövidebb sorozatokat kell feldolgoznia. A megoldás ugyanakkor rögzített, a tokenizálást pedig a modell tanítása előtt, külön folyamatban végzik el. A vállalat szerint ez a nyelvi modellezési folyamat egyik utolsó olyan része, amelyet emberek terveznek meg ahelyett, hogy a modell tanulná meg.
A H-Net ezt a lépést a modellen belül végzi el. Az architektúra a bájtokat dinamikusan nagyobb egységekbe csoportosítja, majd ezek felett dolgozik. A folyamat a Cartesia értelmezése szerint a karakterekből szavakat, a szavakból kifejezéseket, a kifejezésekből pedig fogalmakat építő hierarchikus absztrakcióhoz hasonlíthat.
A Cartesia mérései szerint kisebb számítási igény mellett is működik
A vállalat 2026. október 28-án közzétett bejegyzésében először egy modern, tokenizált Transformer-alapú nyelvi modell skálázási létráját alakította ki. Ezután az egyes méretszinteken a tokenizálási komponenst egy bájtszintű H-Netre cserélték, miközben megtartották a BPE-alapú modell gerincét és hiperparamétereit.
A Cartesia szerint a gondosan ellenőrzött, egylépcsős H-Nets a pusztán tanult tokenizálás révén akár 3-5-szörös számítási hatékonysági javulást mutattak. A bejegyzés egy rugalmasabb, kétlépcsős H-Net eredményeit is bemutatja. Ez a modell a vállalat állítása szerint egy vele összevethető, nyílt forrású modellnél 10-szer kevesebb számítással és adattal is jobb teljesítményt ért el.
A H-Net öt fő modulból áll: egy bemeneti kódolóból, egy tanult csoportosító lépésből, a durvább egységeken működő főhálózatból, egy visszafejtő részből és egy dekóderből. Az egylépcsős változat egy dinamikus darabolási szintet használ, a főhálózat maga pedig H-Net lehet, így a folyamat több szinten, rekurzívan is felépíthető.
A rendszer a nyelven túl is használható lehet
A Cartesia szerint a H-Nets a nyers adatokból való tanulás általánosabb módszere felé mutathatnak. A vállalat olyan viselkedéseket is megfigyelt, amelyek korábban nem jelentek meg nyelvi modellekben, köztük a kontextuson belüli tokenizálást. Ez arra utalhat, hogy a modell a feldolgozandó adatok alapján maga alakítja ki a hasznosabb egységeket.
Az architektúra a cég szerint nem korlátozódik bájtokra vagy diszkrét adatokra. A bejegyzés biológiai és képi területeken folyó kutatásokról is beszámol, amelyek a H-Nets többféle adatformátumon való alkalmazhatóságát vizsgálják.
A mostani írás egy kétrészes sorozat első része. A Cartesia a következő bejegyzésben szélesebb modellválasztékon szeretné részletesebben elemezni, miért lehetnek a H-Nets hatékonyabbak a nyelvi modellezésben. A vállalat egyúttal közölte, hogy a továbbfejlesztett H-Net-technológiát tervezi kiadni, de a forrás nem ad meg ehhez időpontot vagy részletes elérhetőséget.
Cartesia: From Tokens to Bytes I: Scaling Hierarchical Networks | Cartesia