A nyers bájtokból tanuló modellek jobban általánosíthatnak
A Cartesia új elemzése szerint a nyers bájtokhoz hozzáférő nyelvi modellek erősebb általánosítási képességet mutathatnak, miközben a tömörített bemeneteken működő modellek számítási szempontból hatékonyabbak. A kutatók szerint a hierarchikus H-Net modellek a két előnyt egyszerre kínálhatják.
- A Cartesia a számítási hatékonyság és az általánosítás kapcsolatát vizsgálta.
- Az előtokenizálás kézzel megalkotott szabályokkal szegmentálja a korpuszt.
- A bájtszintű modellek erősebb általánosítást mutathatnak.
- A tömörített bemeneteken működő modellek számítási szempontból hatékonyabbak.
- A Cartesia szerint a H-Netek a két előnyt egyszerre kínálhatják.
Kétféle skálázódási törvényt vizsgáltak
A Cartesia október 28-án közzétett, From Tokens to Bytes II: Learning from Raw Data című bejegyzésében azt vizsgálja, milyen kompromisszumokkal járnak a különböző bemeneti és architekturális megoldások, ha a cél a lehető legjobb nyelvi modellek betanítása előzetes feltevések nélkül.
A kutatók két összefüggést elemeznek. A compute-to-loss, vagyis számítási kapacitás és veszteség közötti skálázódási törvény azt méri, mennyire hatékony egy modell az előtanítás során. A loss-to-loss kapcsolat azt mutatja meg, hogyan függ össze az előtanítás során elért veszteség, illetve bájtonkénti bitérték a későbbi feladatokon nyújtott teljesítménnyel. A Cartesia ezt a modell általánosítási képességének közelítő mércéjeként használja.
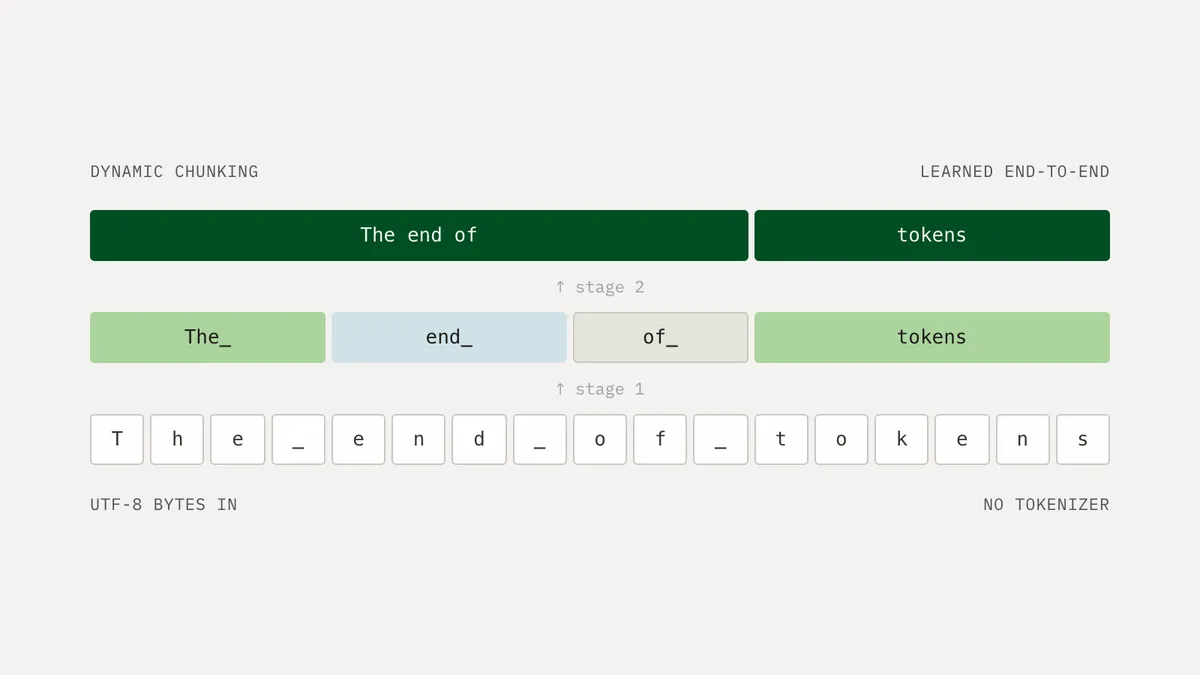
A vizsgálatban byte-level Transformer, BPE-tokenizált Transformer előtokenizálással és anélkül, valamint különböző hierarchikus hálózatok szerepeltek. A kutatók szerint a H-Net és a BLT, vagyis Byte Latent Transformer megoldásoknál az end-to-end felépítés meghatározó.
Az előtokenizálás rejtett előfeltevései
A bejegyzés külön kitér az előtokenizálásra. Ez a tokenizálás előtt egy kézzel megalkotott reguláris kifejezéssel szegmentálja a korpuszt. A Cartesia példái szerint az OpenAI GPT-2-höz használt szabályok többek között az angol összevonásokat, a betűkből és számokból álló részeket, valamint a szóközöket kezelték. A későbbi megoldások összetettebbé váltak, egyebek mellett a számokat háromjegyű csoportokra bonthatták, illetve a nagybetűs és kisbetűs részek alapján is darabolhatták a szavakat.
Előtokenizálás nélkül a létrejövő tokenek között sok szemantikailag nehezen értelmezhető darab jelenik meg. A kutatók példaként olyan részleteket sorolnak, amelyek szóközökön átívelnek, több szót ragasztanak össze, tulajdonnevek közepéből származnak, vagy mondatjeleket, sortöréseket és behúzásokat kereszteznek.
A Cartesia szerint az előtokenizálás szélesebb szerepe, hogy a tokeneket megpróbálja a szöveg szemantikailag értelmes egységeihez igazítani. A latin betűs nyelvekben ilyen egységek lehetnek a szóközzel elválasztott szavak. Ezek a szabályok ugyanakkor nem az adatokból tanultak, ezért a kutatók szerint a szavak fogalmának bájtokból történő megtanulása nem triviális feladat.
Hatékonyabb tömörítés, erősebb általánosítás
A Cartesia korábbi eredményei alapján a H-Net modellek relatív számítási előnye az előtanítási veszteséghez képest a későbbi, eloszláson kívüli értékeléseken tovább nőtt. A diverz adathalmaz esetében 1,3-szoros számítási szorzóról 2-szeresre, a kódot tartalmazó részhalmazon 2-szeresről 5-szörösre emelkedett a különbség a más eloszlású nyelveken végzett értékeléseknél.
Az új elemzésben a kutatók külön skálázási sorozatot tanítottak egy tisztán bájtalapú, nem hierarchikus Byte Transformerhez, tokenizáló és darabolás nélkül. A futtatások eredményei szerint a validációs, bájtonkénti bitérték és az OLMES értékelési csomag bájtonkénti bitértéke erősen összefüggött, és egyetlen sima görbére rendeződött.
A Cartesia egyik központi megállapítása szerint a standard, tömörített bemeneten működő nyelvi modellek jobb számítási hatékonyságot érnek el, a finomabb, például bájtszintű adatokhoz hozzáférő modellek viszont erősebb általánosítást mutatnak. A kutatók szerint a H-Netek mindkét tulajdonságot egyesítik, és az eredmények arra utalnak, hogy a bemenet feldolgozásának minősége szorosan összefügghet azzal, mennyire képes a modell megérteni az adatokat.
Cartesia: From Tokens to Bytes II: Learning from Raw Data | Cartesia