Amazon EC2 P5en
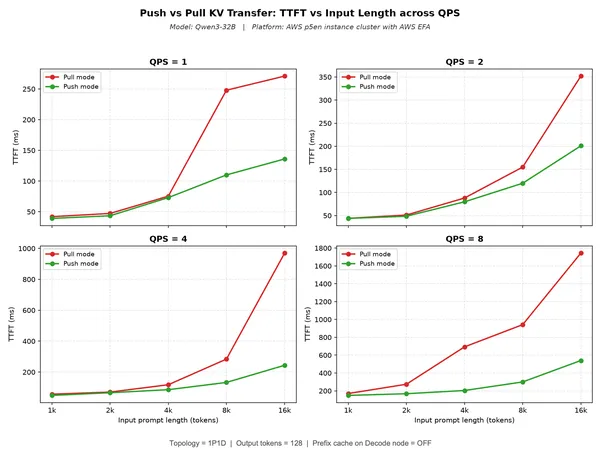
A vLLM új módszere gyorsíthatja a nagy nyelvi modellek válaszait
A vLLM push-alapú KV-cache átvitelt vezetett be a szétválasztott előfeldolgozás és token-generálás gyorsítására. A megoldás az OpenAI Qwen3-32B modelljével végzett…
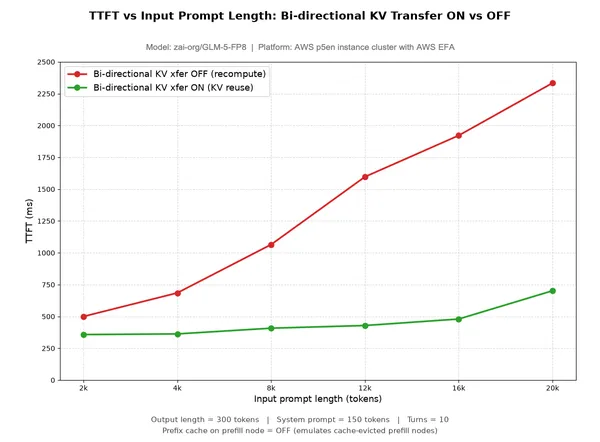
A vLLM kétirányú KV-átvitellel gyorsítja a többlépcsős ügynöki feladatokat
A vLLM kétirányú KV-átvitelt vezetett be a többlépcsős ügynöki munkafolyamatok gyorsítására. A vállalat méréseiben a technika akár 1,6-szoros, illetve 3,3-szoros…