A vLLM új módszere gyorsíthatja a nagy nyelvi modellek válaszait
A vLLM push-alapú KV-cache átvitelt vezetett be a szétválasztott előfeldolgozás és token-generálás gyorsítására. A megoldás az OpenAI Qwen3-32B modelljével végzett tesztben akár háromszoros javulást hozott az első tokenig eltelt időben.
- A vLLM push-alapú NIXL-összekötőt mutatott be.
- A decode példány a prefill befejezése előtt regisztrálja a célblokkokat.
- A megoldás háttérszálra helyezi az átviteli előkészítést.
- A Qwen3-32B benchmarkban akár háromszoros TTFT-javulást mértek.
- A TPOT a tesztben akár 30 százalékkal javult.
A válaszgenerálás két külön szakasza
A vLLM nyílt forráskódú következtetési és kiszolgáló motor nagy nyelvi modellekhez. Az ilyen modellek futtatása két eltérő feladatból áll: az előfeldolgozás, vagyis a prefill feldolgozza a bemeneti promptot és felépíti a kulcs-érték gyorsítótárat, a decode pedig ezt a gyorsítótárat használva, tokenenként állítja elő a választ.
A prefill és a decode külön motorpéldányokon is futtatható. Ez a szétválasztás lehetővé teszi, hogy a két szakaszt külön skálázzák és optimalizálják, ugyanakkor a prefill során létrehozott KV-cache-t át kell vinni a decode példányhoz, mielőtt elkezdődhet a tokenek generálása. Emiatt az átvitel hatékonysága közvetlenül befolyásolja az első tokenig eltelt időt, vagyis a TTFT-t.
A pull helyett push-alapú átvitel
A vLLM egyik korábbi megoldása az NVIDIA Inference Xfer Library, röviden NIXL összekötőjét használja. A rendszer RDMA-képes hálózatokon, például az AWS Elastic Fabric Adapteren keresztül mozgatja a KV-blokkokat. A támogatott példánytípusokon az EFA közvetlen átvitelt tesz lehetővé a GPU vagy a Trainium memóriája között, a gazdagép memóriájának közbeiktatása nélkül.
A korábbi, pull-alapú működésben a prefill példány elkészíti a KV-cache-t, majd az útválasztó továbbítja a forrás metaadatait a decode példánynak. Ezután a decode példány lefoglalja a célblokkokat, előkészíti az átvitelt, majd NIXL READ művelettel lekéri az adatokat. Ezek a lépések egymás után történnek, ezért mindegyik az első tokenig vezető kritikus út része.
Az október 14-én bemutatott push-alapú változatban a decode példány már előre regisztrálja a célblokkokat. A prefill példány akkor indítja el az NIXL WRITE műveletet, amikor elkészült a prompt KV-cache-e, és megérkezett a célregisztráció. Így a beállítás egy része párhuzamosan történhet a prefill feldolgozásával.
Háttérszál végzi az átviteli előkészítést
A push-alapú összekötő három szereplőt hangol össze: a decode példány előre regisztrálja a célblokkokat, a prefill példány párosítja a kéréseket és elindítja az átvitelt, egy dedikált háttérszál pedig elvégzi a KV-cache átvitelének előkészítését.
A folyamat akkor is működik, ha a célregisztráció és a prefill befejezése eltérő sorrendben történik. A rendszer azonosító alapján párosítja a kéréseket, és a vLLM szerint az újraindított, előre leállított vagy újrapróbált kéréseket is megfelelően kezeli. A prefill példány a regisztráció és a saját számítása elkészülte után átadja a blokkokat a háttérszálnak. Ez készíti elő a NIXL-leírókat, összefűzi a folytonos blokkokat nagyobb átviteli tartományokká, majd benyújtja a WRITE műveletet.
A decode példány értesítést kap az átvitel befejezéséről. A token-generálást akkor kezdi meg, amikor az összes várt értesítés megérkezett.
A vLLM szerint csökkenhet a késleltetés
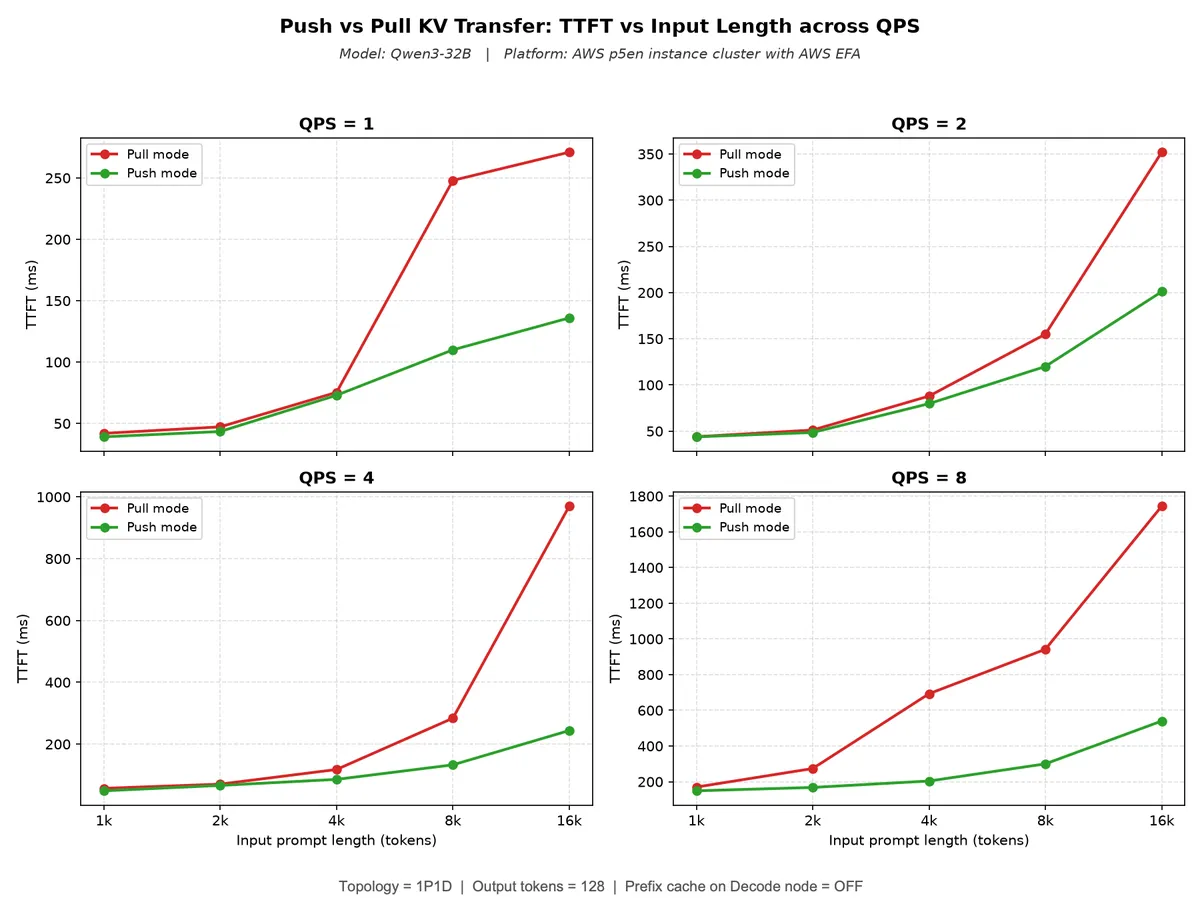
A vLLM benchmarkja egyetlen prefill és egyetlen decode példányból álló, 1P1D telepítést használt Amazon EC2 P5en példányokon, EFA-kapcsolattal. A Qwen3-32B modellen a push mód a pull módhoz képest akár háromszoros javulást ért el a TTFT-ben, a kimeneti tokenenkénti idő, vagyis a TPOT pedig akár 30 százalékkal javult. A projekt szerint az eredmények a terheléstől és a konfigurációtól függnek.
A fejlesztést AWS Trainium példányok EFA-val összekapcsolt fürtjein építették és ellenőrizték, majd gyorsítófüggetlen funkcióként hozzájárultak a vLLM projekthez. A bemutatott eredmények GPU-kat használó AWS p5en fürtön születtek.
A megoldásnak van egy útválasztási kompromisszuma is. Pull módban az útválasztó a prefill befejezése után választhat decode példányt, ami nagyobb rugalmasságot ad a terhelés és a szolgáltatási szintek kezelésekor. Push módban a decode példányt korábban kell kiválasztani, cserébe a céloldali előkészítés átfedhet a prefill számításával, és a KV-blokkok hamarabb felszabadulhatnak.