A vLLM kétirányú KV-átvitellel gyorsítja a többlépcsős ügynöki feladatokat
A vLLM kétirányú KV-átvitelt vezetett be a többlépcsős ügynöki munkafolyamatok gyorsítására. A vállalat méréseiben a technika akár 1,6-szoros, illetve 3,3-szoros javulást hozott az első tokenig eltelt időben.
- A vLLM kétirányú KV-átvitellel csökkenti a korábbi kontextus újraszámítását.
- A KV-metaadatokat az útválasztó tárolja, a tenzorok közvetlenül a csomópontok között mozognak.
- A Qwen3-32B esetében akár 1,6-szoros, a GLM-5-FP8-nál akár 3,3-szoros TTFT-javulást mértek.
- A KV-blokkok alapértelmezett megőrzési ideje 480 másodperc.
- A helyi újraszámításról vagy távoli átvitelről a 64 tokenes küszöbérték dönt.
A hosszú beszélgetések újraszámítása lassítja a válaszokat
A többfordulós ügynöki alkalmazások minden új körben újra elküldik a korábbi beszélgetést. Ebbe beletartoznak a rendszerutasítások, a korábbi felhasználói kérések, az eszközök eredményei és a modell előző válaszai is. A kontextus növekedésével a rendszer ugyanazokat a részeket ismételten dolgozza fel.
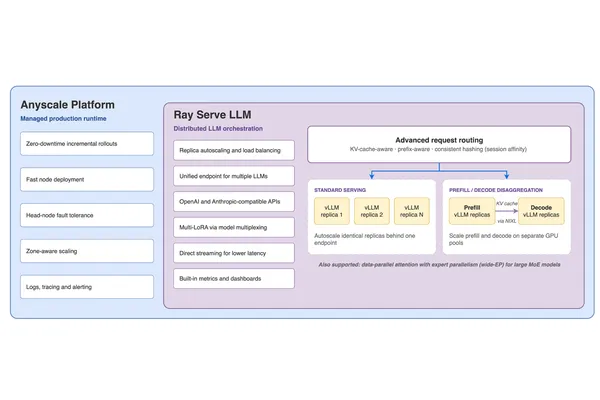
A vLLM prefill és decode csomópontokra bontott kiszolgálásában a prefill csomópont feldolgozza a promptot és létrehozza a KV-gyorsítótárat, a decode csomópont pedig felhasználja ezeket a blokkokat a válasz előállításához. A hagyományos megoldás csak a prefill irányából a decode felé továbbítja a KV-blokkokat. Emiatt a következő körben a prefill csomópont nem fér hozzá a decode oldalon maradt, korábban létrehozott blokkokhoz, és újra kell számolnia a korábbi válaszokhoz tartozó KV-reprezentációkat.
A decode csomópont visszaküldi a korábbi KV-blokkokat
A 2026. október 12-én közzétett bejelentés szerint a kétirányú KV-átvitel lehetővé teszi, hogy a decode csomópont a következő körökben visszaadja a korábban kiszámított KV-adatokat a prefill csomópontnak. Így a közös kontextust nem kell minden alkalommal újraszámolni.
A folyamatban a decode csomópont a válasz létrehozása után megtartja a felhasználható blokkokat, majd a metaadataikat továbbítja a válaszfolyamban. A KV-gyorsítótárat figyelő útválasztó ezeket a metaadatokat a beszélgetés azonosítójához kapcsolva tárolja, és a következő kérésnél átadja a prefill csomópontnak. Maga az útválasztó csak a blokkok helyére vonatkozó metaadatokat kezeli, a KV-tenzorok közvetlenül a csomópontok között mozognak.
A vLLM az NVIDIA Inference Xfer Library KV-összekötőjét is kibővítette. A tényleges adatátvitel mindkét irányban NIXL READ művelettel történik, miközben a prefill és a decode csomópont továbbra is eltérő szerepet tölt be a helyi és távoli blokkok metaadatainak kezelésében.
Akár 3,3-szoros javulás az első tokenig eltelt időben
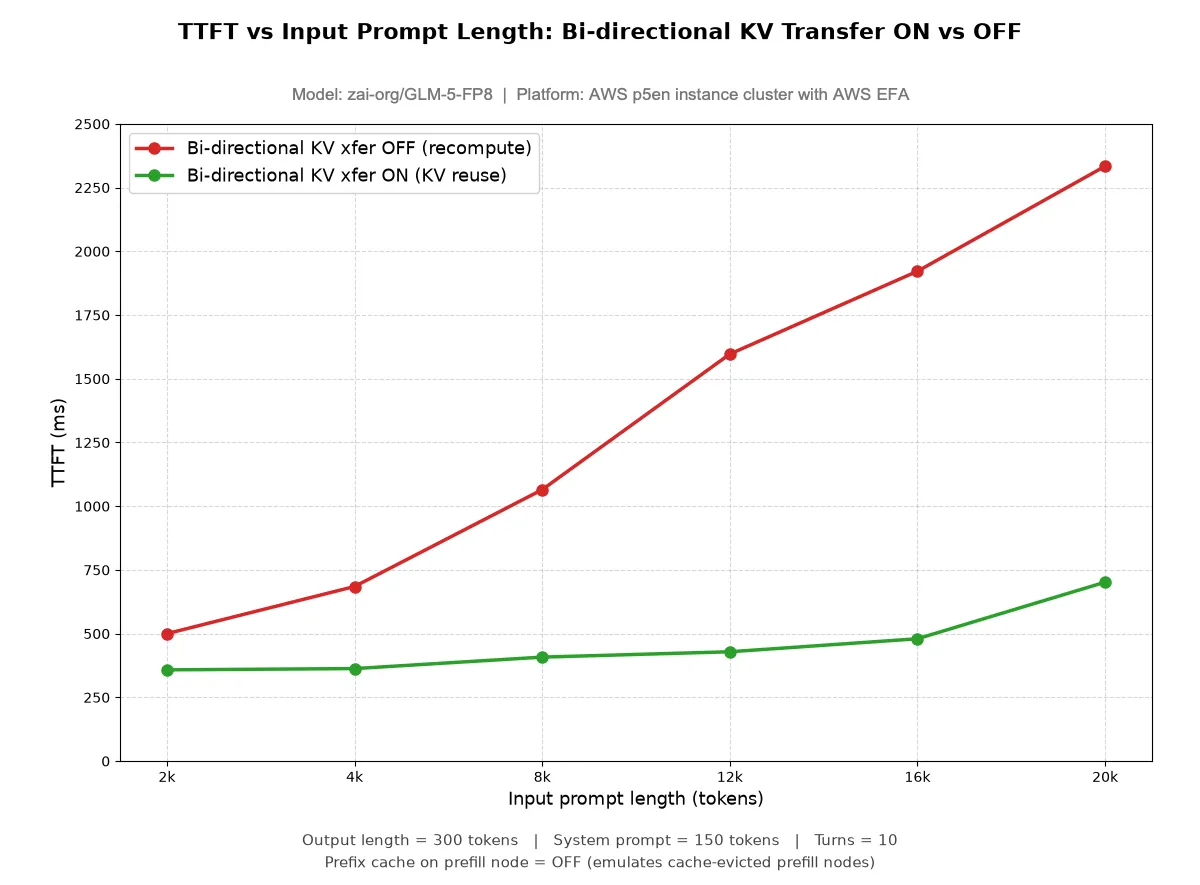
A vLLM Amazon EC2 P5en példányokból álló, AWS Elastic Fabric Adapterrel összekötött GPU-fürtön végzett, 1P1D telepítéses méréseiben a kétirányú KV-átvitel a Qwen3-32B esetében akár 1,6-szoros, a zai-org/GLM-5-FP8 esetében pedig akár 3,3-szoros TTFT-javulást hozott. A közlemény szerint az eredmények a munkafolyamattól és a konfigurációtól függnek.
A decode csomópont alapértelmezés szerint 480 másodpercig tartja meg a blokkokat a decoder_kv_blocks_ttl beállítással. Ha a következő kör ezen időn belül érkezik, a prefill csomópont felhasználhatja a korábbi KV-adatokat, későbbi kérésnél viszont a rendszer visszatér a szokásos prefill-feldolgozáshoz. A kv_recompute_threshold alapértelmezett értéke 64 token. Rövid újrahasznosítható előtag esetén a helyi újraszámítás gyorsabb lehet az átvitelhez szükséges kommunikációnál.
A funkciót eredetileg AWS Trainium-fürtökön fejlesztették és ellenőrizték, majd gyorsítófüggetlen képességként hozzájárultak a vLLM projekthez. A bemutatott GPU-s eredmények alapján a megoldás az alkalmazások számára hosszabb beszélgetési előzmények mellett is egyenletesebb első válaszidőt és kisebb ismételt prefill-terhelést tehet lehetővé.