Apache Spark
Az Apache Spark nyílt forráskódú, elosztott adatfeldolgozó keretrendszer, amely nagy adathalmazok kezelésére és elemzésére szolgál. Fontos szerepet tölt be az MI világában, mert az adatok előkészítése, átalakítása és feldolgozása gyakran a gépi tanulási rendszerek alapja.
Ezen a címkeoldalon a Spark teljesítményét és fejlesztését érintő hírek kapnak helyet. Itt olvashatók a Databricks deklaratív adatfolyamok számítási igényéről szóló állításai, valamint az AI ügynökök szerepéről a Spark UDF függvényeinek GPU gyorsításra való átírásában.
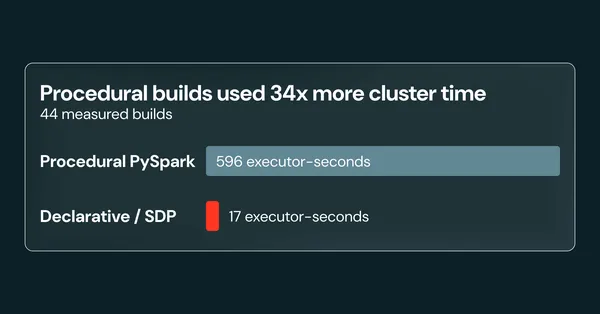
A Databricks szerint 34-szer kevesebb számítás kell a deklaratív adatfolyamokhoz
A Databricks mérése szerint a Spark Declarative Pipelines deklaratív adatfolyamai körülbelül 34-szer kevesebb számítási időt használtak, mint a procedurális…
AI-ügynökök írhatják át a Spark UDF-jeit GPU-gyorsításra
Az NVIDIA olyan AI-ügynökökkel támogatott munkafolyamatot mutatott be, amely Apache Spark-felhasználói függvényeket ír át GPU-gyorsításra. A vállalat szerint a…