A Databricks szerint 34-szer kevesebb számítás kell a deklaratív adatfolyamokhoz
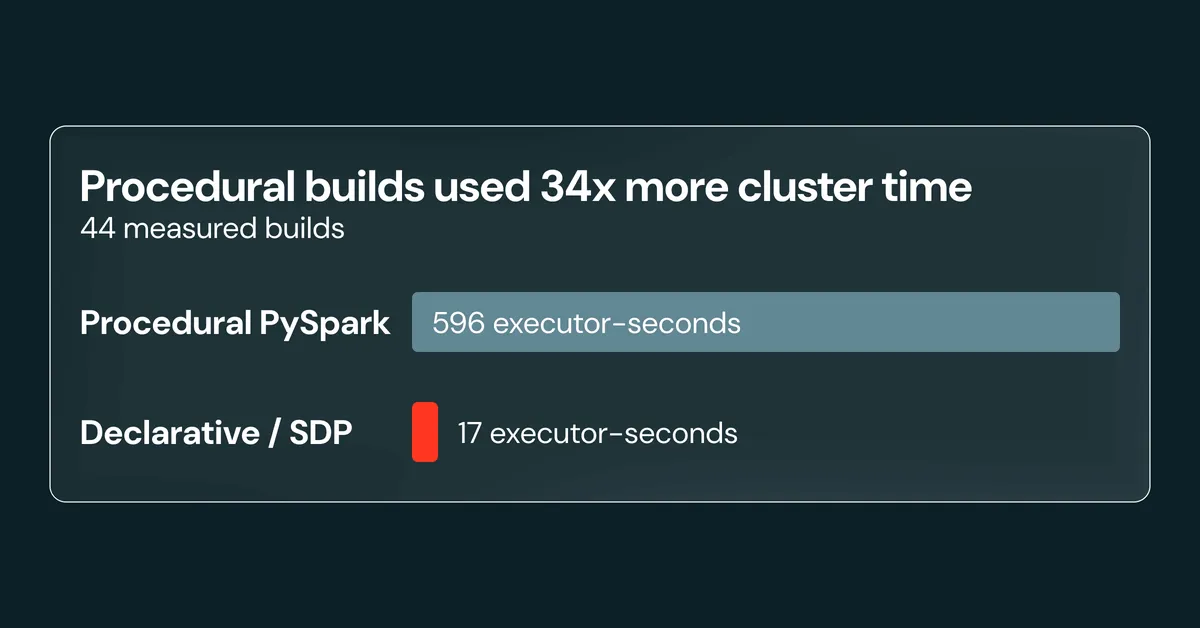
A Databricks mérése szerint a Spark Declarative Pipelines deklaratív adatfolyamai körülbelül 34-szer kevesebb számítási időt használtak, mint a procedurális PySpark-folyamatok. A deklaratív megközelítés kevesebb kódot is igényelt, miközben a logikai hibák felismerésében nem mutatott előnyt.
- A deklaratív folyamatok körülbelül 34-szer kevesebb fürtidőt használtak.
- A deklaratív kód medián hossza 64 sor volt, a procedurálisé 131 sor.
- A száraz futtatás 264 buildből 55 esetben még kimenet előtt felismerte a hibát.
- A logikai hibák aránya a két megközelítésnél hasonló maradt.
- A deklaratív build-ek több modelltokent, de kevesebb fürtidőt igényeltek.
Az ügynökök egyre több adatfolyamot írnak
A Databricks 2026. október 23-án közzétett elemzése szerint az AI-ügynökök már a gyártási adatfolyamok növekvő részét készítik. A cég állítása alapján a Databricksen futó Spark Declarative Pipelines adatfolyamok több mint 70 százalékát ügynökök hozzák létre.
Ez két szempontból növeli a hibák jelentőségét. Minden újrapróbálkozás számítási időt és erőforrást igényel, ezért az iterációknak olcsón és hatékonyan kell futniuk. Emellett a kód felülvizsgálata fontos ellenőrzési ponttá válik, így a létrehozott kódnak tömörnek, olvashatónak és helyesnek kell lennie.
Az Apache Spark kétféle programozási modellt kínál. A procedurális megoldás lépésről lépésre írja le, hogyan kell előállítani az egyes adatkészleteket. A deklaratív folyamat ezzel szemben azt írja le, milyen adatkészletekre van szükség, a végrehajtás módját pedig a Sparkra bízza.
A deklaratív kódot még futtatás előtt ellenőrizni lehet
A Databricks szerint a deklaratív folyamatok egyik legfontosabb előnye, hogy a strukturális hibák már futtatás előtt felismerhetők. Ilyen lehet egy nem létező oszlopra való hivatkozás, egy még létre nem hozott tábla használata vagy egy hibás konfigurációs módosítás.
A Spark száraz futtatása, vagyis a dry run során a rendszer ellenőrzi, hogy az oszlophivatkozások illeszkednek-e az adatkészletek sémájához, minden függőséghez tartozik-e előállító adatfolyam, illetve teljes és megfelelő sorrendű-e a folyamat gráfja. A procedurális kódnál ilyen előzetes szakasz nincs, ezért a hibás lépés eléréséig a fürtön kell futtatni a folyamatot.
A Databricks 22 adat mérnöki feladatot vizsgált, feladatonként 12 különböző, termelési adatokra jellemző rendezetlen értékeket tartalmazó bemeneti adatkészlettel. Mindegyik esetben procedurális PySpark- és Spark Declarative Pipelines-megoldás is készült. Ez összesen megközelítőleg 528 buildet jelentett, a teszteket pedig minden esetben Opus 4.8 végezte.
Kevesebb kód, jelentősen kisebb fürtidő
A két megközelítés hasonló arányban oldotta meg a feladatokat. Procedurálisan 264-ből 255, deklaratívan pedig 264-ből 258 build fejeződött be sikeresen. A különbség főként a hibák kezelésében és a szükséges kód mennyiségében jelent meg.
A procedurális futtatások összesen 596 végrehajtói másodpercet használtak, szemben a deklaratív megoldások 17 másodpercével. A Databricks számítása szerint ez körülbelül 34-szeres különbség. A deklaratív száraz futtatás 264 buildből 55 esetben még bármilyen kimenet előállítása előtt megállította a hibás folyamatot.
A sikeresen befejezett build esetében a deklaratív kód medián hossza 64 sor volt, míg a procedurális megoldásoké 131 sor. Ez nagyjából 51 százalékkal kevesebb kódot jelent. A deklaratív megoldások absztrakt szintaxisfája szintén kisebb volt, körülbelül 44 százalékkal.
A vizsgálatban 19 procedurális build olyan megoldást használt, amely az adatokat memóriába töltötte és soronként dolgozta fel. A deklaratív build-ek között ilyen nem fordult elő. A Databricks szerint a rövidebb és egységesebb kód kevesebb felülvizsgálatot és kevesebb karbantartandó mintát jelent.
A logikai hibákat továbbra is tesztekkel kell keresni
A deklaratív modell előnyei nem terjednek ki minden hibára. A száraz futtatás a strukturális problémákat képes felismerni, de azt nem, ha egy folyamat hibamentesen lefut, mégis rossz eredményt ad. A Databricks mérésében a két megközelítés ezen a téren lényegében azonosan teljesített: a különbség nagyjából 15 százalékon belül maradt.
A teljes táblázat szerint a procedurális build-ek 73 esetben, vagyis 27,7 százalékban adtak hibás választ úgy, hogy a futás sikeresnek tűnt. A deklaratív megoldásoknál ez 85 eset, 32,2 százalék volt. A cég ezért hangsúlyozza, hogy a logikai hibák felderítéséhez továbbra is tesztekre és kódáttekintésre van szükség.
A deklaratív megközelítés ugyanakkor több nyelvi modelltokent használ. A Databricks táblázata szerint a medián build költsége az Opus 4.8 listaáraival számolva körülbelül 0,50 dollár volt, szemben a procedurális megoldások 0,26 dollárjával. A cég érvelése szerint ez egyszeri, előzetes költség, miközben a hibás folyamatok fürtidőben jelentkező vesztesége minden sikertelen futtatáskor, az adatmennyiséggel együtt nő.
Databricks: Built for Agents: The Case for Spark Declarative Pipelines