Llama-3.1-70B
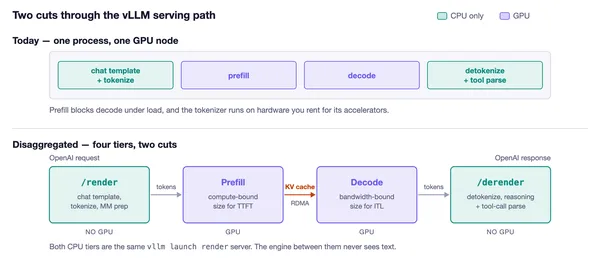
A vLLM különválasztaná a promptfeldolgozást és a tokenek generálását
A vLLM új útmutatója azt mutatja be, hogyan választható szét a nagy nyelvi modellek kiszolgálásában a promptok feldolgozása, a tokenek generálása és a CPU-s…
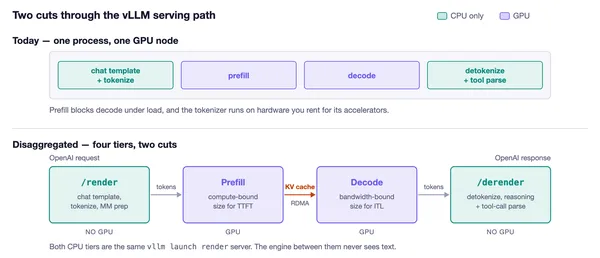
A vLLM négy részre bontaná az LLM-kiszolgálást
A vLLM új útmutatója a nagy nyelvi modellek kiszolgálásának szétválasztását mutatja be. A prefill és a decode külön példányokra helyezésével csökkenthető a hosszú…