A vLLM négy részre bontaná az LLM-kiszolgálást
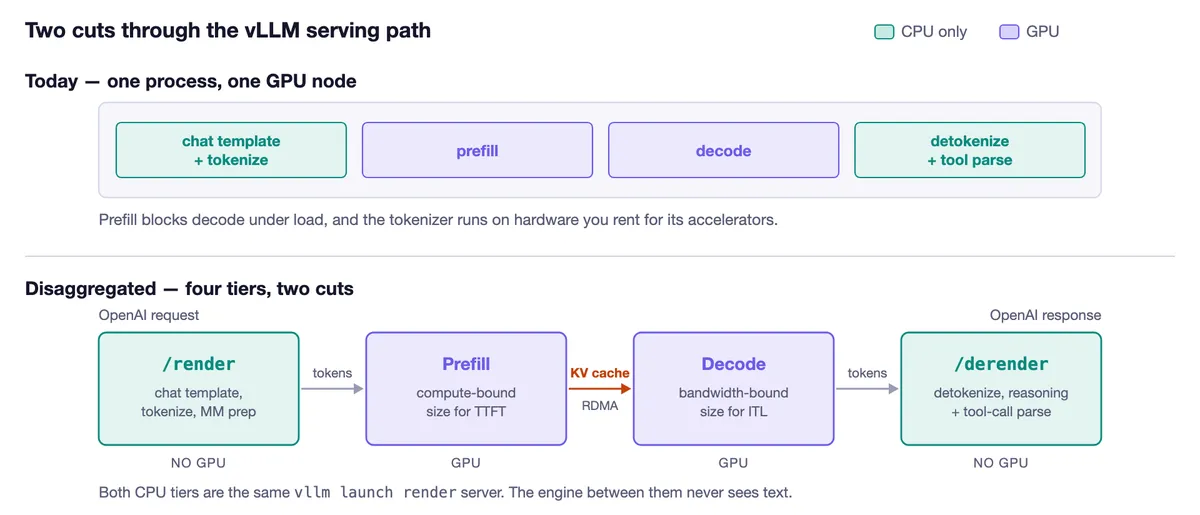
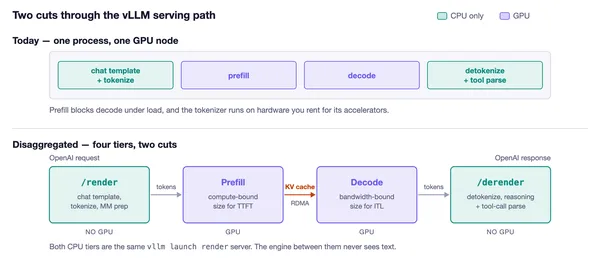
A vLLM új útmutatója a nagy nyelvi modellek kiszolgálásának szétválasztását mutatja be. A prefill és a decode külön példányokra helyezésével csökkenthető a hosszú promptok okozta válaszidő-növekedés, miközben a CPU-s feladatok is leválaszthatók a GPU-s gépekről.
- A vLLM a prefill- és decode-szakasz külön példányban futtatását támogatja.
- A két réteg között a KV-gyorsítótár mozog, ami jelentős adatátvitelt igényelhet.
- A szétválasztás fő előnye a TTFT és az ITL külön hangolhatósága.
- A renderelési réteg a tokenizálást és a parsing feladatokat CPU-s gépre helyezheti.
- Lassú KV-átvitel vagy alacsony terhelés mellett a közös kiszolgálás lehet célszerűbb.
Egy folyamat három eltérő feladatot végez
A vLLM 2026. szeptember 29-én közzétett útmutatója szerint az alapértelmezett vllm serve folyamat három különböző munkát kezel: a prompt feldolgozását, a válasz tokenenkénti generálását, valamint több CPU-s feladatot.
A prompt feldolgozását prefillnek nevezik. Ez egyetlen menetben olvassa be a teljes bemenetet, elsősorban számításigényes, és meghatározza az első tokenig eltelt időt, vagyis a TTFT-t. A decode ezzel szemben egyszerre egy tokent állít elő, teljesítményét főként az határozza meg, milyen gyorsan olvashatók be a modell súlyai a memóriából. Ez adja az inter-token latency, az ITL értékét.
Ha a két szakasz ugyanazon a GPU-n fut, egy hosszú prompt feldolgozása minden éppen készülő választ megakaszthat. A vLLM szerint a harmadik, könnyebben figyelmen kívül hagyható csoportba tartozik a sablonkezelés, a tokenizálás, a detokenizálás, valamint a gondolkodási és eszközhívási adatok feldolgozása. Ezek CPU-s műveletek, mégis gyakran gyorsítókártyát használó gépen futnak.
A prefill és a decode külön példányba kerülhet
A disaggregated serving, vagyis a szétválasztott kiszolgálás a prefill- és decode-szakaszt két külön példányra osztja. A két oldal között a KV-gyorsítótár mozog. Ebben találhatók a prompt tokenjeihez tartozó figyelmi kulcsok és értékek, amelyekre a decode-nak szüksége van a válasz előállításához.
Az adat mennyisége jelentős lehet. A forrás példája szerint a Llama-3.1-70B BF16 formátumban tokenenként 320 KiB KV-adatot tárol, így egy 10 ezer tokenes prompt körülbelül 3 GB-ot ad át a decode-rétegnek. Ez 400 Gb/s-os kapcsolaton, többletterhelés nélkül is nagyjából 65 ezredmásodpercet jelent.
Az átvitelt KV-összekötők kezelik, jellemzően RDMA használatával. A vLLM ökoszisztémájában több mint egy tucat ilyen megoldás érhető el, köztük a NIXL, az LMCache, a Mooncake, a FlexKV és az AMD MoRI-IO. A MultiConnector több összekötő láncolását is támogatja.
A vLLM a frontend leválasztását is támogatja. A /render egy OpenAI-kérést tokenazonosítókká alakít, a motor tokeneket fogad és ad vissza, a /derender pedig ismét szabályos OpenAI-választ készít, külön kezelve a tartalmat, a gondolkodást és az eszközhívásokat. Az útmutató további lehetőségként említi a multimodális modellek encoder-szétválasztását, a MoE-modellekhez készült AFD plugint, valamint a Mamba állapotátvitelét a hibrid SSM-modelleknél.
A cél a kiszámítható késleltetés, nem feltétlenül a nagyobb átviteli sebesség
A vLLM szerint a szétválasztás értéke elsősorban a goodput, vagyis az a fenntartható kérésmennyiség, amely mellett a TTFT- és ITL-célok is teljesülnek. A prefill- és decode-réteg külön méretezhető, így a promptfeldolgozás számításigényéhez, illetve a válaszok kötegelt generálásához eltérő párhuzamosítás használható.
A forrásban szereplő, két NVIDIA L40S GPU-n végzett mérésben a Qwen2.5-7B-Instruct körülbelül 8 ezer tokenes promptokat és 256 kimeneti tokent kapott. A közös kiszolgálásnál a p99 ITL 0,4 kérés/másodpercnél 23 ezredmásodpercről 169 ezredmásodpercre ugrott, 2 kérés/másodpercnél pedig 263 ezredmásodpercet ért el. A prefill és decode szétválasztása mellett az érték 25 és 52 ezredmásodperc között maradt.
Az AMD egy másik mérésében a Qwen3-235B-A22B-FP8 modell egy nyolc MI300X GPU-t használó gépen másodpercenként 8 kérés mellett 100-ból 73 alkalommal teljesítette az 1 másodperces TTFT- és 50 ezredmásodperces ITL-célt. A közös kiszolgálásnál ez 30 kérés volt. Az llm-d útmutatója 16 H200 GPU-n a gpt-oss-120b modellnél 59 százalékkal alacsonyabb átlagos végponttól végpontig mért késleltetést és 67 százalékkal alacsonyabb P95-értéket jelzett a szétválasztott megoldás javára.
A KV-átvitel döntő korlát lehet
Minden első token megfizeti a KV-gyorsítótár átvitelének költségét. A vLLM ezért gyors hálózati kapcsolatot javasol, például RDMA-t InfiniBand vagy RoCE felett, illetve NVLinket vagy GPU-k közötti közvetlen másolást egy gépen belül.
A bemutatott L40S-rendszerben nem volt elérhető GPU-k közötti közvetlen másolás. Egy 8 ezer tokenes Qwen2.5-7B prompt körülbelül 470 MB KV-adatának átvitele nagyjából 1,3 másodpercig tartott. Emiatt a P/D megoldás medián TTFT-je 2,2 másodperc lett, szemben a közös kiszolgálás 0,7 másodpercével, miközben az ITL farokértéke stabil maradt.
Az útmutató szerint a késleltetés jelentős részét az átvitel körüli többletterhelés okozhatja. A vLLM a mérés előtt a nvidia-smi topo -p2p r ellenőrzését, majd néhány hosszú prompt egyenkénti elküldését javasolja. Ha a KV Transfer mérőszámainál az átlagos átviteli idő több száz ezredmásodperc, először ezt kell javítani.
A CPU-s renderelési réteg leválasztása közben a tokenizálás és a feldolgozás a CPU-terheléshez igazítható. A forrásban szereplő mérés szerint egy 9 ezer tokenes Qwen2.5-7B chatprompt sablonkezelése és tokenizálása körülbelül 15 ezredmásodperc CPU-időt igényelt, egy alapbeállítású renderkiszolgáló pedig másodpercenként 73 kérést kezelt valamivel több mint egy processzormaggal.
A vLLM v0.30.0 vagy újabb verziójára épülő felállás ugyanakkor három vagy négy szolgáltatás üzemeltetését és új hibalehetőséget jelent. Alacsony, szakaszos vagy késleltetésre kevésbé érzékeny forgalomnál a forrás továbbra is a közös kiszolgálást tartja megfelelőnek. A szétválasztás főként akkor indokolt, ha a termelési terhelés mellett az ITL p99 értéke túllépi a célértéket, illetve ha hosszú promptok és nagy párhuzamosság mellett a prefill rendszeresen megakasztja a válaszokat.