NVIDIA Inference Xfer Library
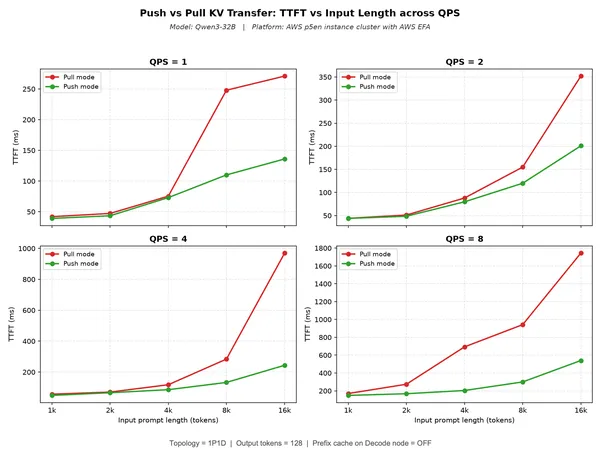
A vLLM új módszere gyorsíthatja a nagy nyelvi modellek válaszait
A vLLM push-alapú KV-cache átvitelt vezetett be a szétválasztott előfeldolgozás és token-generálás gyorsítására. A megoldás az OpenAI Qwen3-32B modelljével végzett…
Az NVIDIA ModelExpress felgyorsítja a nagy AI-modellek betöltését
Az NVIDIA ModelExpress a modell súlyainak mozgatását gyorsítaná azzal, hogy mindig a leggyorsabb elérhető forrást választja. A rendszer a már működő példányok…