A CLIP természetes nyelvű utasításokkal tanít robotokat
A FAR.AI kutatói szerint Vision-Language Modellek, köztük a CLIP, jutalmazó modellként használhatók megerősítéses tanulásban. A módszerrel egy humanoid robotot egyetlen természetes nyelvű mondattal tanítottak több összetett mozdulatra.
- A CLIP a robot vizuális állapotát egy természetes nyelvű feladattal veti össze.
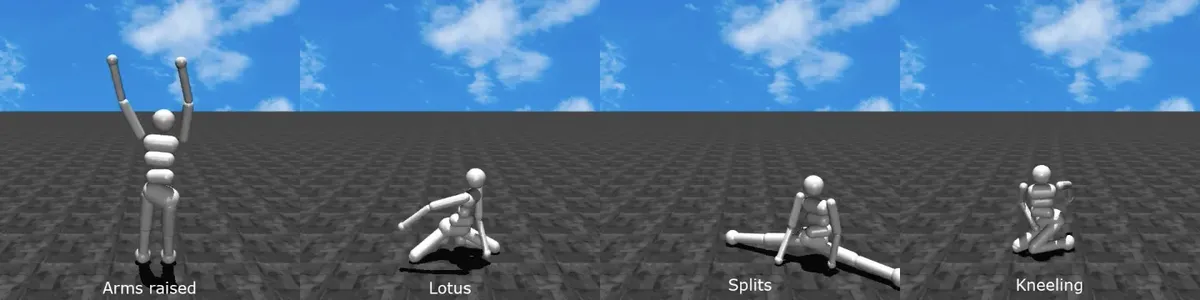
- A humanoid robot többek között térdelést, lótuszülést és spárgázást tanult.
- A nagyobb CLIP-modellek pontosabb jutalmazó modellként működtek.
- A kutatók CartPole és MountainCar környezetekben is tesztelték a módszert.
Szöveges utasítás váltja ki a kézzel írt jutalmazást
A megerősítéses tanulásban a fejlesztőknek általában kézzel kell meghatározniuk, milyen viselkedést jutalmazzon a rendszer. Ez nehéz feladat lehet. Egy másik lehetőség, hogy a jutalmazó modellt nagy mennyiségű emberi visszajelzésből tanítják meg, ez viszont költséges.
A FAR.AI bemutatott megközelítése ezt egy előre betanított Vision-Language Modellel próbálja kiváltani. A kutatók példaként az „a humanoid robot kneeling”, vagyis „egy térdelő humanoid robot” szöveges utasítást használják. A modell összeveti a robot vizuális állapotát a feladathoz tartozó szöveggel, majd az egyezés mértéke alapján jutalmat ad az ügynöknek.
A módszer alapja a CLIP kép- és szövegreprezentációinak összehasonlítása. A két reprezentáció közötti koszinuszos hasonlóság határozza meg a jutalmazási jelet, így a szöveges célhoz jobban illeszkedő állapot magasabb jutalmat kap.
A humanoid több összetett feladatot is megtanult
A kutatók először klasszikus vezérlési környezetekben, a CartPole és a MountainCar feladatokban vizsgálták a CLIP-alapú jutalmazást. A CartPole esetében a rendszer szabályozás és finomhangolás nélkül is jól működött. A MountainCarnál a legmagasabb jutalom a megfelelő helyen jelent meg, de a jutalmazási függvény alakja nehezebbé tette a tanulást.
Ezen javított egy opcionális eljárás, a cél és az alapvonal regularizálása. Ehhez a kutatók egy, a környezetet általánosan leíró alaputasítást is használtak, például „a humanoid” szöveget. A módszer simábbá teheti a jutalmazási függvényt. A kutatók szerint a MountainCar esetében a realisztikusabb textúrák szintén kedvezőbb jutalmazási alakzathoz vezettek.
A fő kísérletekben egy humanoid robotot tanítottak meg térdelni, lótuszülésben ülni, felállni, felemelni a karját és spárgázni. Mindegyik feladatot egyetlen mondatos szöveges utasítás írta le, további prompttervezés nélkül. Más mozdulatok, például az egy lábon állás, a csípőre tett kéz és a keresztbe tett kar nehezebbnek bizonyultak.
A nagyobb CLIP-modellek pontosabb jutalmazást adtak
A vizsgálat egyik fő megállapítása, hogy a nagyobb CLIP-modellek lényegesen jobb jutalmazó modelleknek bizonyultak. A humanoid térdelését csak a kutatásban elérhető legnagyobb CLIP-modell tudta sikeresen megtanítani. A FAR.AI szerint a sikertelen feladatok elsősorban a felhasznált CLIP-modellek képességkorlátaira vezethetők vissza.
A humanoid feladatoknál nem állt rendelkezésre előre meghatározott, valódi jutalmazási függvény, ezért a teljesítményt emberi címkézéssel vizsgálták. A kutatók olyan állapotokat gyűjtöttek, amelyek között sikeres feladatvégrehajtások is szerepeltek, majd kézzel címkézték őket. Emellett a végső, CLIP-jutalmazással tanított házirendek sikerességi arányát is manuálisan értékelték.
A FAR.AI szerint az emberi értékelés szükségszerűen tartalmazhat szubjektív elemeket. A kutatók ugyanakkor arra jutottak, hogy a Vision-Language Modellek meglepően hatékonyak és robusztusak lehetnek jutalmazó modellként. Várakozásuk szerint a fejlettebb, nagyobb modellek szélesebb feladatkört is kezelhetnek, mivel a rendszernek a természetes nyelvű leírásból kell következtetnie arra, hogyan értékelje a robot viselkedését.